SemiAnalysis phân tích: Bộ nhớ Rubin Ultra giảm xuống còn 192GB, liệu NVIDIA cũng phải nhượng bộ trước HBM?

TL;DR
· SemiAnalysis cho biết NVIDIA đang giới thiệu trước cho các khách hàng chủ chốt phiên bản Rubin Ultra giảm thông số, với bộ nhớ chính là 192GB.
· Thông tin này không phải là xác nhận chính thức từ NVIDIA, điểm mấu chốt nằm ở nguồn cung HBM, mức tiêu thụ điện năng và triển khai hệ thống NVL576.
· Giảm thông số không đồng nghĩa với nhu cầu AI đã đạt đỉnh, phiên bản công suất cao có thể vẫn được giữ lại, nhưng điện năng phòng máy và chuỗi cung ứng vẫn là rào cản.
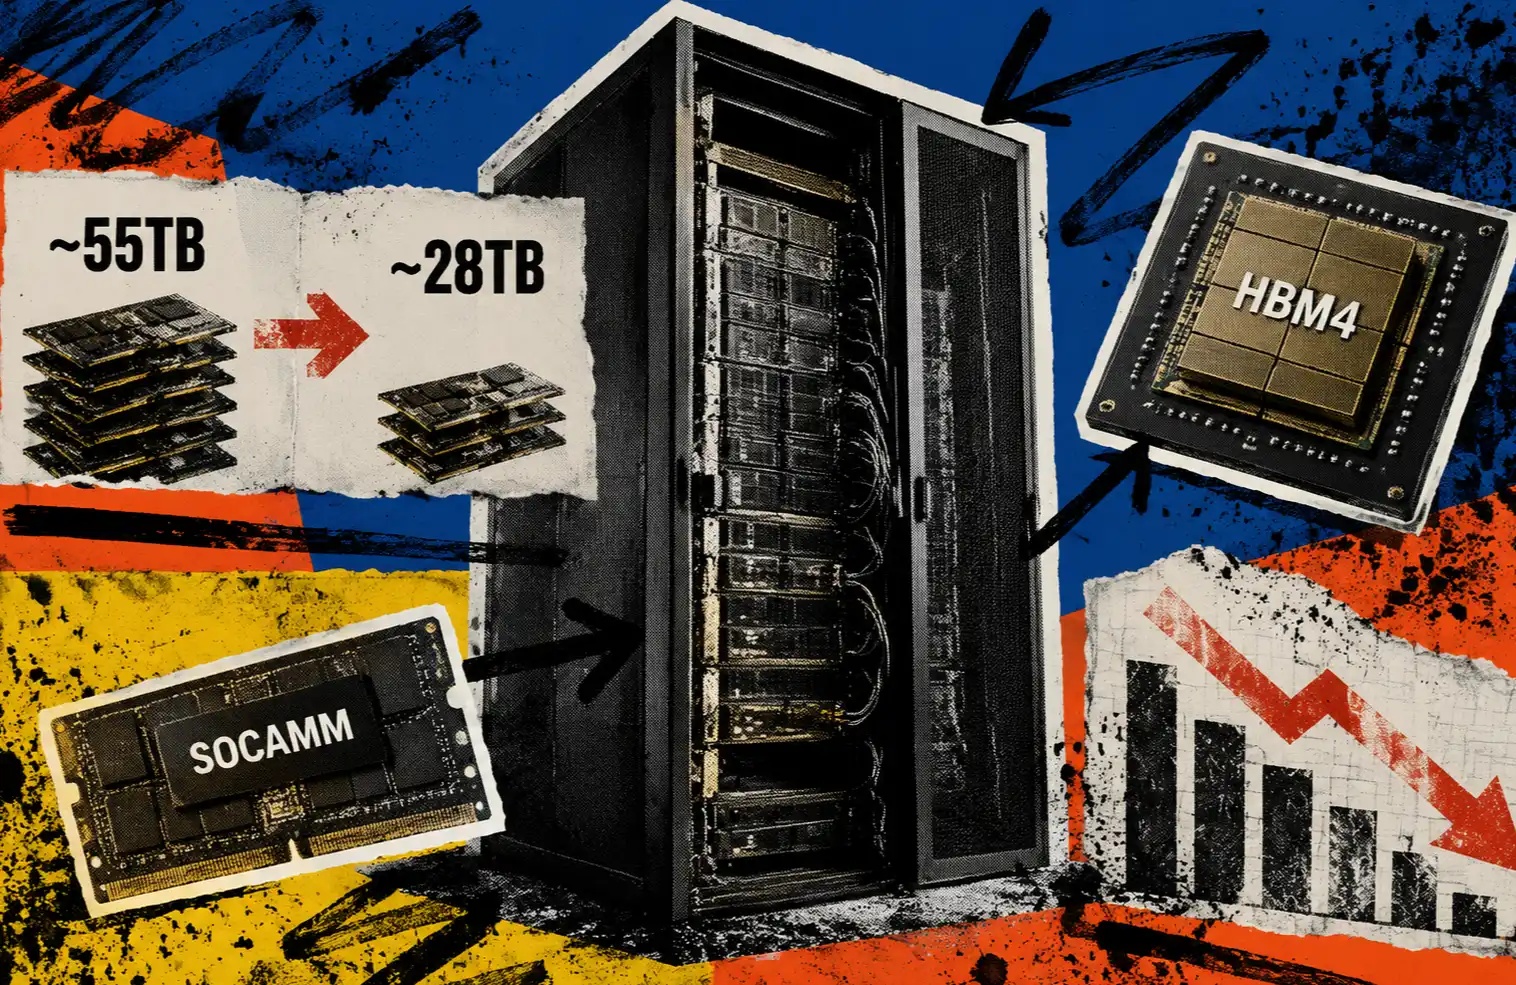
Báo cáo của SemiAnalysis công bố ngày 29/7 cho biết NVIDIA đang giới thiệu trước cho các khách hàng chủ chốt phiên bản Rubin Ultra đã điều chỉnh. Theo thông tin giới thiệu trước cho khách hàng, SKU chính sẽ sử dụng HBM4 8-Hi với dung lượng bộ nhớ 192GB, thấp hơn so với kỳ vọng trước đó của thị trường về cấu hình mạnh mẽ hơn của Rubin Ultra.
Đây không phải là thông số sản phẩm cuối cùng được NVIDIA xác nhận chính thức. Blog kỹ thuật của NVIDIA công bố ngày 21/7 tiết lộ GPU Rubin có hai die tính toán, sử dụng HBM4, tối đa 288GB, băng thông 22TB/s và hiệu suất NVFP4 50 PFLOPS, điều này củng cố nhận định cơ bản rằng "Rubin là sản phẩm trọng yếu thế hệ tiếp theo", nhưng phiên bản chính 192GB của Rubin Ultra vẫn nên được xem là thông tin giới thiệu trước cho khách hàng do SemiAnalysis tiết lộ.
Đối với khách hàng trung tâm dữ liệu AI, bộ nhớ, nguồn cung HBM, mức tiêu thụ điện năng trên mỗi card và độ phức tạp khi triển khai trong rack sẽ ảnh hưởng trực tiếp đến cách xây dựng hệ thống huấn luyện và suy luận, tốc độ xây dựng và chi phí. Nếu Rubin Ultra giảm bộ nhớ chính xuống 192GB, điều này giống như NVIDIA đang ưu tiên lựa chọn phiên bản dễ triển khai ở quy mô lớn hơn trong điều kiện HBM và điện năng hạn chế, thay vì đẩy thông số từng GPU lên mức tối đa.
Bộ nhớ 192GB thấp hơn kỳ vọng ban đầu, phiên bản chính ưu tiên khả năng triển khai
Trước đó tại GTC 2025 cũng như trong tài liệu của nhiều công ty chứng khoán và truyền thông, Rubin Ultra thường được mô tả là thế hệ sản phẩm có bộ nhớ lớn hơn, công suất cao hơn và đóng gói phức tạp hơn, bao gồm các giả định táo bạo hơn như HBM4E, 1TB, NVL576.
Thông tin giới thiệu trước cho khách hàng mà SemiAnalysis đưa ra lần này rõ ràng thận trọng hơn: phiên bản chính sử dụng HBM4 8-Hi với bộ nhớ 192GB. Sự thay đổi này nên được hiểu là mức điều chỉnh giảm so với kỳ vọng thị trường trước đó và lộ trình ban đầu, chứ không phải NVIDIA đã chính thức công bố một thông số nào đó rồi rút lại.
Bộ nhớ không phải là thông số độc lập. Huấn luyện mô hình lớn và suy luận ngữ cảnh dài cần nhiều bộ nhớ tốc độ cao hơn, bộ nhớ càng lớn thì một GPU đơn lẻ có thể chứa càng nhiều phân đoạn mô hình, bộ đệm và dữ liệu. Nhưng HBM cũng là một trong những linh kiện khan hiếm và đắt đỏ nhất trong phần cứng AI hiện tại. Phiên bản chính sử dụng ít HBM hơn có thể giúp NVIDIA phân bổ nguồn cung hạn chế cho nhiều GPU và hệ thống hơn.
Đây cũng là điểm dễ bị hiểu lầm khi nói về việc "hạ cấp thông số". Thông tin hiện có không ủng hộ việc diễn giải trực tiếp thành nhu cầu AI chậm lại. Cách giải thích hợp lý hơn là, trong bối cảnh HBM và điện năng đều khan hiếm, sản phẩm chủ lực cần cân bằng giữa hiệu năng, chi phí, nguồn cung và triển khai.
Câu chuyện sức mạnh tính toán chuyển hướng sang NVL576, khách hàng mua toàn bộ hệ thống
SemiAnalysis cho biết, giá trị FLOPs lý thuyết đỉnh của phiên bản chủ lực Rubin Ultra về cơ bản được giữ nguyên, các điều chỉnh tập trung chủ yếu vào dung lượng bộ nhớ, mức tiêu thụ điện và hình thái hệ thống, chứ không phải đơn giản là cắt giảm sức mạnh tính toán.
Trọng tâm của hướng đi này nằm ở NVL576. Nói đơn giản, NVIDIA vẫn đang kết nối nhiều GPU hơn thông qua liên kết tốc độ cao để tạo thành một miền tính toán thống nhất lớn hơn, giúp khách hàng chuyển từ thông số từng card sang năng lực hệ thống của toàn bộ rack và toàn cụm. Báo cáo này đề cập rằng, một hình thái hệ thống đang được lên kế hoạch là kết nối 8 rack 72-GPU, tạo thành quy mô NVL576.
Điều này thực tế hơn đối với các nhà cung cấp đám mây và phòng thí nghiệm AI lớn. Yếu tố giới hạn việc mở rộng cụm huấn luyện không chỉ là sức mạnh của từng GPU, mà còn bao gồm mức tiêu thụ điện của rack, tản nhiệt, nguồn điện, mạng lưới, nguồn cung HBM, nhịp độ giao hàng và hạ tầng xây dựng trung tâm dữ liệu. Dung lượng bộ nhớ trên mỗi card cao hơn tất nhiên có giá trị, nhưng nếu đi kèm với mức tiêu thụ điện cao hơn, chi phí BOM cao hơn và rack khó triển khai hơn, khách hàng chưa chắc đã sử dụng hết công suất.
Sự thay đổi chính của Rubin Ultra giống như việc giữ lại hiệu năng tính toán và khả năng mở rộng hệ thống, đồng thời kiểm soát dung lượng bộ nhớ và mức tiêu thụ điện trong phạm vi dễ sản xuất hàng loạt, dễ cung ứng và dễ triển khai hơn.
1800W trở thành thông số chủ lực, điện năng kìm hãm cấu hình tối đa
Mức tiêu thụ điện là một con số quan trọng khác trong lần thay đổi hướng đi này.
SemiAnalysis cho biết, mức tiêu thụ điện ở cấp độ chip của phiên bản chủ lực Rubin Ultra khoảng 1800W, tương đương với cấu hình Rubin 1800W Max-Q trước đó, thấp hơn phiên bản 2300W từng được thị trường thảo luận. Báo cáo này cũng đề cập rằng, NVIDIA có thể vẫn cung cấp phiên bản Max-P tiêu thụ điện cao từ 2600W đến 2800W, và có thể tồn tại SKU 1200W hướng đến tải tính toán thấp hơn, chẳng hạn như token decode.
Những chi tiết này chưa được NVIDIA xác nhận chính thức, vẫn nên xem xét theo góc độ của báo cáo. Nhưng chúng đều chỉ về cùng một vấn đề thực tế: ngay cả khi chip có thể chạy ở mức tiêu thụ điện cao hơn, trung tâm dữ liệu của khách hàng chưa chắc đã có thể tiếp nhận ổn định.
Mức tiêu thụ điện trên mỗi GPU càng cao, yêu cầu về nguồn điện và tản nhiệt của rack càng lớn. Vấn đề mà nhiều khách hàng đối mặt không phải là "có muốn mua GPU mạnh hơn hay không", mà là khuôn viên hiện tại, khả năng kết nối điện và hệ thống tản nhiệt có thể hỗ trợ hay không. Các bài viết công khai trước đây của SemiAnalysis cũng đề cập rằng, Rubin có hai cấu hình tiêu thụ điện là 2300W Max-P và 1800W Max-Q, trong đó Max-Q nhấn mạnh hiệu suất trên mỗi watt, khách hàng sẽ chọn chạy ở mức tiêu thụ điện thấp hơn do ràng buộc về điện năng.
Trong môi trường hạn chế về điện năng, phiên bản 1800W có thể dễ dàng tăng sản lượng hơn. Nó hy sinh một phần cấu hình tối đa, nhưng giúp giảm áp lực cung cấp điện và tản nhiệt, đồng thời gần hơn với hình thái mà khách hàng có thể triển khai nhanh chóng.
HBM vẫn là nút thắt, giảm thông số không phải là nhu cầu đạt đỉnh
Nguồn cung HBM căng thẳng là một mạch chính khác khiến bộ nhớ giảm xuống còn 192GB.
Giải thích của SemiAnalysis là HBM khan hiếm hơn so với công suất sản xuất front-end của TSMC. Bằng cách giảm lượng HBM sử dụng trên mỗi GPU, NVIDIA có thể phân bổ nguồn cung hạn chế cho nhiều sản phẩm hơn và đối phó với áp lực chi phí do giá HBM tăng trong tương lai. Nhận định này cũng cần giữ nguyên cách diễn đạt của báo cáo, nhưng phù hợp với tình trạng căng thẳng hiện tại của chuỗi cung ứng phần cứng AI.
Điều này ảnh hưởng trực tiếp đến chuỗi ngành. Nếu dung lượng HBM trên mỗi card GPU chính thấp hơn kỳ vọng thị trường trước đó, thì tính toán nhu cầu đơn vị của nhà cung cấp HBM, mô hình mua sắm của nhà cung cấp đám mây và BOM máy chủ đều sẽ thay đổi. Nhưng điều này không có nghĩa là HBM không còn khan hiếm. Ngược lại, chính vì nguồn cung HBM căng thẳng, NVIDIA mới có động lực điều chỉnh giải pháp chính sang hình thái tiết kiệm HBM hơn và dễ tăng sản lượng hơn.
Rubin Ultra cũng không nhất thiết chỉ còn một phiên bản. Theo cách diễn đạt của SemiAnalysis, phiên bản Max-P công suất cao vẫn có thể hướng đến khách hàng cụ thể và các tình huống cực đoan, chỉ là không nhất thiết trở thành SKU chính được triển khai rộng rãi nhất.
Lần tiết lộ này giống như sản phẩm của giai đoạn mở rộng sức mạnh tính toán AI bước vào ràng buộc kỹ thuật. NVIDIA không dừng lại ở việc thúc đẩy quy mô hệ thống lớn hơn, nhưng việc thế hệ GPU tiếp theo có thể tăng sản lượng thuận lợi hay không ngày càng phụ thuộc vào nguồn cung HBM, điện năng phòng máy và khả năng triển khai thực tế của khách hàng, chứ không chỉ là thông số của từng chip đơn lẻ.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan