


Morgan Stanley phân tích: AI chip tăng tốc chạy đua, liệu nguồn điện có theo kịp? Nhu cầu tiềm ẩn năm 2027 khoảng 38GW
Tóm tắt nhanh
· Morgan Stanley ước tính dựa trên khoảng 19 triệu GPU/ASIC, trung bình mỗi chip có TDP 2kW, nhu cầu điện năng ngầm của chip năm 2027 vào khoảng 38GW, trong đó NVIDIA chiếm khoảng 16GW.
· 38GW không phải là tổng điện năng tiêu thụ của trung tâm dữ liệu hay công suất điện đã được xây dựng, mà là bài kiểm tra áp lực xem cơ sở hạ tầng có thể tiếp nhận lượng chip xuất xưởng hay không.
· Báo cáo tính toán nhu cầu AI HBM năm 2027 khoảng 48,6 tỷ Gb, nhu cầu CoWoS khoảng 2,66 đến 2,69 triệu tấm, nhưng giải pháp bộ nhớ phân tầng Rubin Ultra vẫn chưa được xác nhận cuối cùng.
· Sản lượng xuất xưởng TPU của Google dự kiến tăng từ 3,7 triệu đơn vị năm 2026 lên 7,35 triệu đơn vị năm 2027, kéo theo đơn hàng từ chuỗi cung ứng kiểm thử như KYEC.
Bài kiểm tra chuỗi cung ứng châu Á mới nhất của Morgan Stanley đã chuyển đổi sự mở rộng AI thành một con số điện năng trực quan hơn: dựa trên khoảng 19 triệu GPU và ASIC ngầm từ CoWoS năm 2027, với mức TDP trung bình 2kW mỗi chip, công suất điện tương ứng của nhóm chip này vào khoảng 38GW.
Trong đó, NVIDIA chiếm khoảng 16GW, Google khoảng 9GW, AMD khoảng 7GW, AWS khoảng 2GW, Microsoft, Meta và các nhà sản xuất khác mỗi bên khoảng 1GW.
Cần nhấn mạnh rằng, 38GW không phải là tổng điện năng tiêu thụ của các trung tâm dữ liệu AI toàn cầu vào thời điểm đó, cũng không phải là công suất điện đã được triển khai. Con số này chưa tính đầy đủ điện năng cho CPU, mạng, lưu trữ, làm mát và các thiết bị phụ trợ khác, mà gần hơn với một bài kiểm tra áp lực được suy ra từ sản lượng chip xuất xưởng: nếu năm 2027 các bộ tăng tốc AI được mở rộng theo mô hình chuỗi cung ứng, liệu cơ sở hạ tầng điện có thể đồng thời tiếp nhận các chip này không?
Điều này có nghĩa là, ràng buộc của việc mở rộng sức mạnh tính toán AI đang kéo dài từ "liệu GPU có thể được sản xuất ra không" sang việc liệu HBM, CoWoS, kiểm thử, giao hàng rack và kết nối điện có thể đến cùng lúc hay không.
Bài kiểm tra áp lực 38GW, đẩy nút thắt AI về phía điện năng
Lần tính toán này của Morgan Stanley dựa trên hai giả định cốt lõi: số lượng chip GPU và ASIC tương ứng với CoWoS năm 2027 khoảng 19 triệu đơn vị, TDP trung bình mỗi chip tính theo 2kW, từ đó suy ra nhu cầu điện năng ngầm của chip khoảng 38GW.
2kW là giả định trung bình được sử dụng để ước tính tổng lượng, không đại diện cho việc tất cả GPU và ASIC đều có mức tiêu thụ điện như nhau. 38GW cũng không bằng tải trọng vận hành thực tế của trung tâm dữ liệu, vì chip không phải lúc nào cũng chạy ở mức đầy tải, và các hệ thống CPU, mạng, lưu trữ, làm mát trong máy chủ sẽ tạo thêm điện năng tiêu thụ phụ trợ.
Nhưng con số này vẫn có giá trị tham khảo. Trong hai năm qua, các cuộc thảo luận về chuỗi cung ứng AI chủ yếu tập trung vào lịch sản xuất GPU, nguồn cung HBM và công suất CoWoS. Khi lượng chip xuất xưởng tiếp tục tăng, việc kết nối lưới điện, xây dựng trạm biến áp, lựa chọn địa điểm trung tâm dữ liệu và các thỏa thuận mua điện dài hạn có thể trực tiếp ảnh hưởng đến việc chip có thể chuyển hóa thành sức mạnh tính toán thực tế hay không.
Giao chip chỉ là bước đầu tiên. Sau khi GPU hoặc ASIC được đưa vào trung tâm dữ liệu, vẫn cần có hệ thống máy chủ, giá đỡ, mạng, tản nhiệt, điện năng và vận hành bảo trì đi kèm. Nếu việc xây dựng cơ sở hạ tầng chậm hơn so với xuất xưởng chip, thị trường có thể xuất hiện sự lệch pha "chip đã đến nhưng phòng máy và điện năng chưa sẵn sàng".
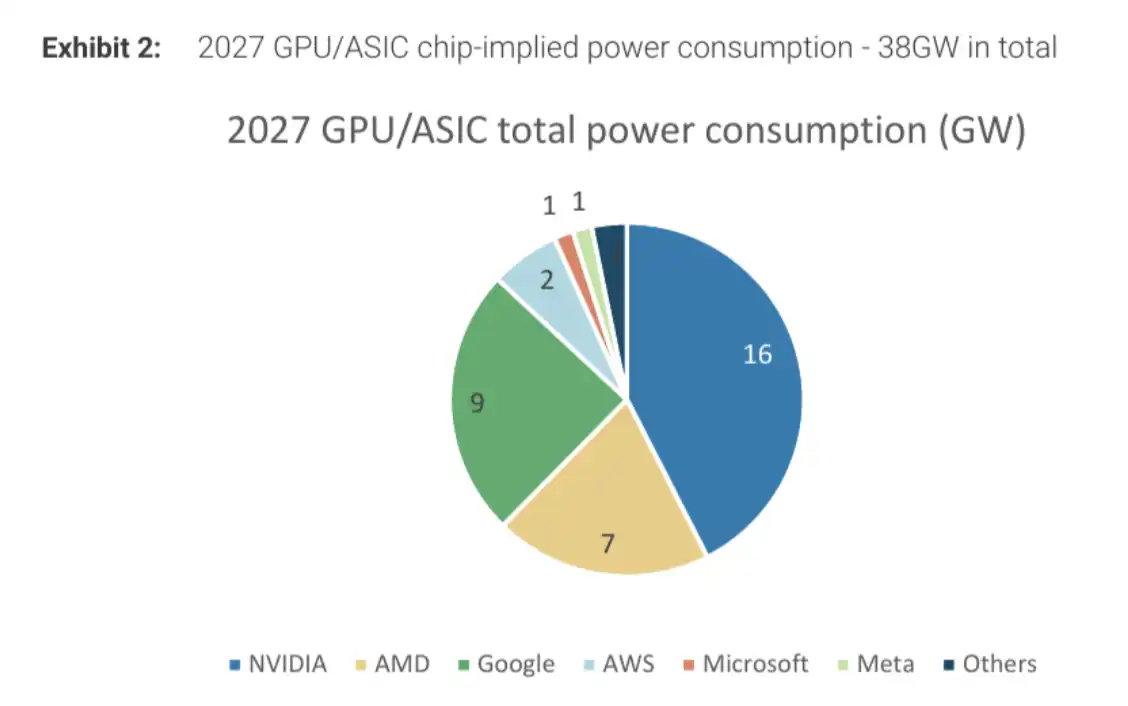
Nhu cầu điện năng ngầm của chip GPU/ASIC năm 2027 khoảng 38GW, trong đó NVIDIA 16GW, Google 9GW, AMD 7GW.
Đối với NVIDIA, nhu cầu ngầm 16GW cũng giải thích vì sao công ty liên tục tăng mật độ GPU trên mỗi giá đỡ. Báo cáo cho biết, NVIDIA về lâu dài muốn kết nối nhiều GPU hơn thông qua kiến trúc scale-up, nâng cao khả năng tính toán và hiệu suất ở cấp độ giá đỡ.
Nhưng giải pháp Kyber của giá đỡ Rubin Ultra thế hệ đầu tiên vẫn phải đối mặt với thách thức về PCB và tản nhiệt, có thể tiếp tục áp dụng thiết kế Oberon NVL72, sau đó mở rộng lên quy mô NVL576 thông qua kết nối CPO hoặc NPO. Việc tăng mật độ giá đỡ sẽ không loại bỏ nhu cầu điện năng, mà ngược lại còn tập trung áp lực cấp điện, tản nhiệt và kết nối vào các thiết kế trung tâm dữ liệu có thông số cao hơn.
HBM và CoWoS mở rộng song song, thông số Rubin Ultra vẫn chưa được xác định
Ngoài điện năng, HBM và đóng gói tiên tiến vẫn là những ràng buộc chính trong việc mở rộng chip AI quanh năm 2027.
Theo mô hình chuỗi cung ứng của Morgan Stanley, nhu cầu HBM tương ứng với chip AI năm 2027 khoảng 48,618 tỷ Gb. Cấu hình CoWoS được liệt kê trong Exhibit 3 khoảng 2,664 triệu tấm wafer, trong khi nhu cầu CoWoS toàn cầu trong Exhibit 5 khoảng 2,694 triệu tấm, hai con số có sự chênh lệch nhỏ do phạm vi thống kê khác nhau.
Báo cáo đồng thời tính toán, quy mô doanh thu wafer tương ứng với chip tính toán AI năm 2027 ít nhất đạt 58,8 tỷ USD. NVIDIA vẫn là bên có nhu cầu CoWoS lớn nhất, dự kiến chiếm khoảng 1,222 triệu tấm; AMD và Broadcom lần lượt khoảng 530.000 tấm và 484.000 tấm.
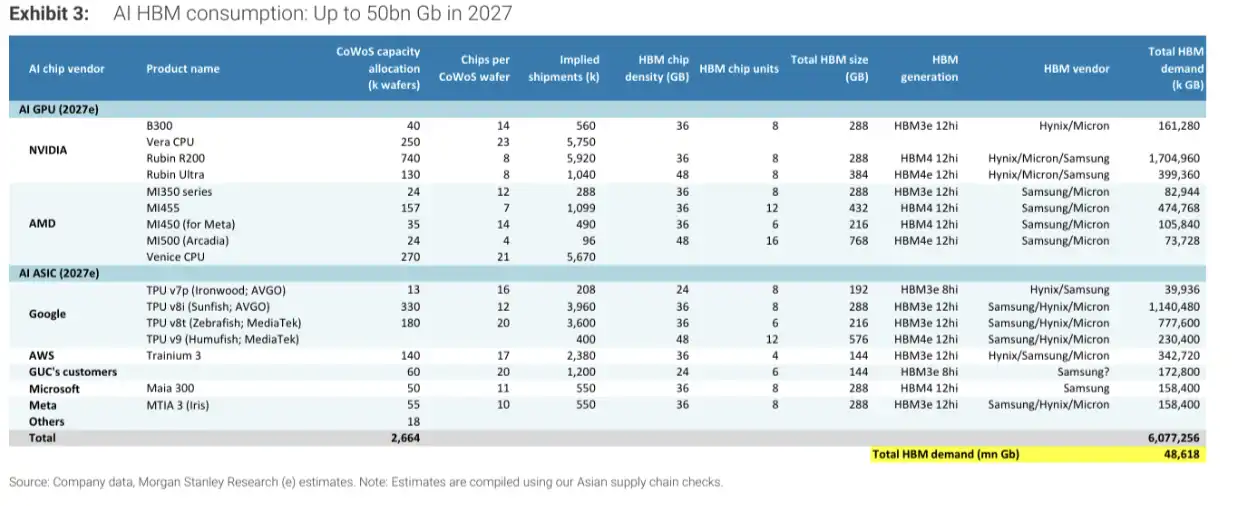
Nhu cầu AI HBM năm 2027 khoảng 48,6 tỷ Gb, cùng với cấu hình CoWoS và nhu cầu HBM của các loại GPU, ASIC khác nhau.
Dự báo nhu cầu vẫn tồn tại một biến số quan trọng: cấu hình HBM của Rubin Ultra vẫn chưa được xác định cuối cùng.
Kiểm tra chuỗi cung ứng cho thấy, Rubin Ultra có thể áp dụng thông số phân tầng, phiên bản cấu hình cao sử dụng HBM4e 8Hi, phiên bản cấu hình thấp có thể sử dụng HBM4 12Hi hoặc 8Hi. Morgan Stanley dự kiến, NVIDIA có thể đưa ra quyết định cuối cùng trước cuối quý 3 năm 2026.
Sự điều chỉnh này chủ yếu phản ánh ba áp lực: tình trạng thiếu hụt công suất HBM, chi phí bộ nhớ tăng cao, cũng như nhu cầu về dung lượng và băng thông của các khối lượng công việc AI khác nhau là không giống nhau. Báo cáo cho rằng, việc giảm cấu hình HBM có thể ảnh hưởng đến khối lượng công việc giải mã lớn hơn so với pre-fill, đặc biệt là trong các mô hình ngữ cảnh dài.
Cần lưu ý rằng, Exhibit 3 vẫn tính toán dựa trên cấu hình Rubin Ultra với HBM4e 12Hi, tổng dung lượng mỗi chip là 384GB. Do đó, nhu cầu HBM 48,6 tỷ Gb chưa phản ánh đầy đủ phương án giảm thông số phân tầng tiềm năng. Nếu cấu hình cuối cùng bị hạ xuống, lượng HBM sử dụng trên mỗi chip có thể giảm, nhưng chi phí bộ nhớ thấp hơn cũng có thể thúc đẩy tăng số lượng chip xuất xưởng, bù đắp một phần ảnh hưởng của việc giảm lượng sử dụng trên mỗi chip.
Thông tin công khai của Micron cho thấy, HBM4 của họ đã bước vào giai đoạn xuất xưởng số lượng lớn, HBM4E dự kiến sẽ sản xuất hàng loạt vào năm 2027. Phía nguồn cung đang thúc đẩy sản phẩm mới, nhưng cấu hình cuối cùng mà Rubin Ultra áp dụng vẫn phụ thuộc vào sự cân nhắc tổng thể của NVIDIA về hiệu suất, chi phí và đảm bảo nguồn cung.
Nhịp độ xuất xưởng của dòng Rubin vẫn rất mạnh mẽ. Báo cáo dự kiến, năm 2027 tổng số lượng xuất xưởng của Rubin và Rubin Ultra gần 7 triệu đơn vị, trong đó Rubin khoảng 5,92 triệu đơn vị, Rubin Ultra khoảng 1,04 triệu đơn vị; số lượng rack Rubin NVL72 xuất xưởng có thể đạt khoảng 90.000 đơn vị.
Rubin dự kiến bắt đầu tăng tốc từ quý 3 năm 2026, và khởi động xuất xưởng rack từ quý 4. Báo cáo cũng cho rằng, lượng "tồn kho" Blackwell mà thị trường lo ngại trước đây chủ yếu là tồn kho đệm chuỗi cung ứng, dự kiến sẽ được tiêu thụ hoàn toàn vào năm 2026.
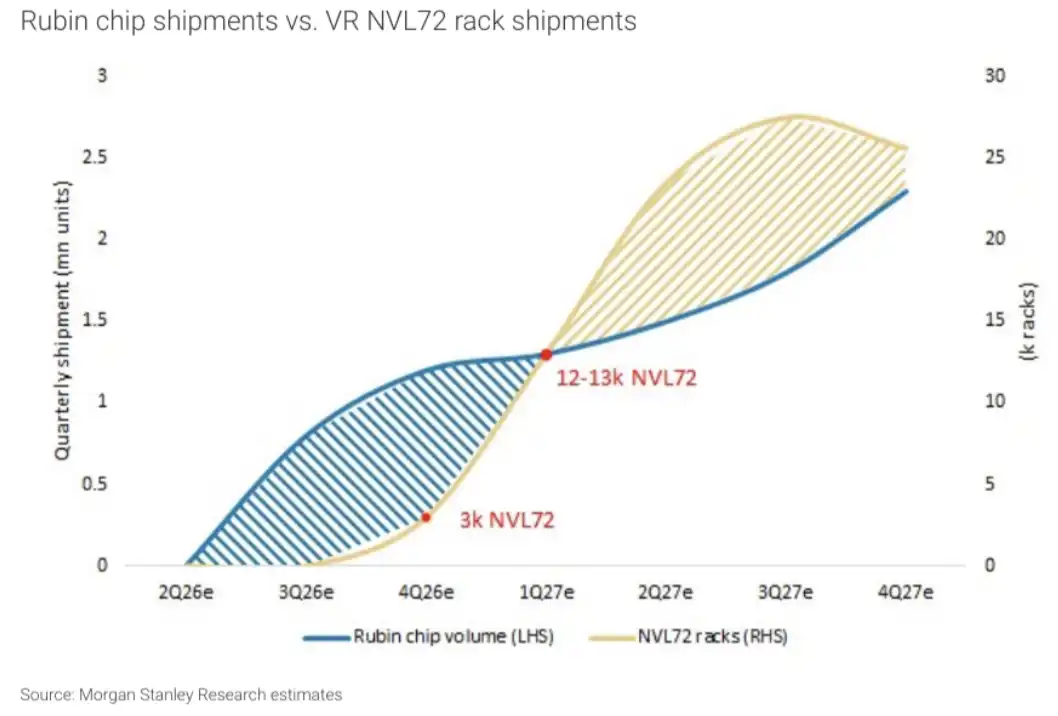
Dự báo xuất xưởng chip Rubin và Rubin Ultra cũng như lô rack Rubin NVL72.
Điều này có nghĩa là, từ nửa cuối năm 2026 đến năm 2027, chuỗi cung ứng của NVIDIA cần đồng thời hoàn tất việc tiêu thụ tồn kho Blackwell, tăng tốc sản xuất Rubin, chuyển đổi thông số HBM và giao hàng rack. Bất kỳ một khâu nào chậm lại đều có thể ảnh hưởng đến quy mô sức mạnh tính toán cuối cùng có thể bàn giao.
TPU của Google tăng lên 7,35 triệu đơn vị, đơn hàng lan truyền đến chuỗi kiểm thử
Ngoài NVIDIA, TPU của Google là một trục tăng trưởng rõ ràng khác trong báo cáo.
Theo dự báo của Morgan Stanley, sản lượng xuất xưởng TPU của Google sẽ tăng từ 3,7 triệu đơn vị năm 2026 lên 7,35 triệu đơn vị năm 2027. Trong đó, v8i có sự tham gia của Broadcom dự kiến xuất xưởng 4 triệu đơn vị, v8t có sự tham gia của MediaTek dự kiến xuất xưởng 3 triệu đơn vị, v9 dự kiến khoảng 150.000 đơn vị, còn lại khoảng 200.000 đơn vị đến từ v7.
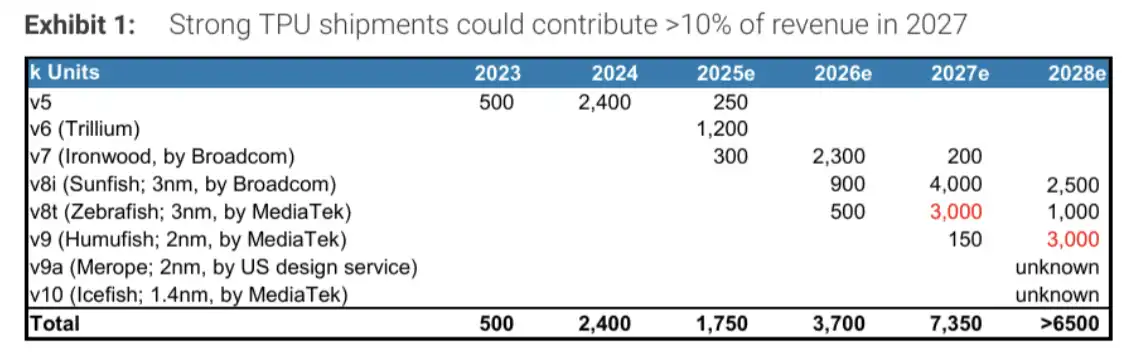
Dự báo xuất xưởng TPU qua từng thế hệ của Google và đóng góp tiềm năng vào doanh thu của KYEC.
Việc tăng sản lượng TPU sẽ lan truyền đơn hàng đến các khâu thiết kế chip, chế tạo wafer, đóng gói tiên tiến và kiểm thử. Báo cáo dự kiến, mảng kinh doanh liên quan đến TPU có thể chiếm 7% đến 8% doanh thu năm 2026 của KYEC, và tỷ trọng năm 2027 sẽ cao hơn một chút, trên 10%, bao gồm kiểm thử cuối cùng và một phần doanh thu từ kiểm tra wafer.
Nếu đưa toàn bộ CPU, TPU, kiểm thử cuối cùng và một phần hoạt động kiểm tra wafer của Google vào, nhu cầu liên quan đến Google dự kiến sẽ chiếm 10% đến 15% doanh thu năm 2027 của KYEC, cao hơn mức 8% đến 10% của năm 2026.
Nhu cầu kiểm thử cũng ngày càng phức tạp hơn. Báo cáo cho biết, TPU 3nm có sự tham gia của MediaTek dự kiến sẽ áp dụng kiểm thử Burn-in để nâng cao độ ổn định hiệu suất và độ tin cậy của chip AI; dự án CPU của Google cũng cần kiểm thử Burn-in và kiểm thử cấp hệ thống.
Quy trình kiểm thử phức tạp hơn và chu kỳ kiểm thử dài hơn sẽ làm tăng đơn hàng cho các nhà máy kiểm thử, nhưng liệu năng lực kiểm thử có trở thành nút thắt cổ chai hay không còn phụ thuộc vào sự thay đổi chung giữa thời gian kiểm thử từng chip và tổng sản lượng xuất xưởng. Báo cáo đồng thời lưu ý, việc rút ngắn thời gian kiểm thử ở một số khâu có thể giảm bớt áp lực năng lực trong ngắn hạn, do đó không thể đơn giản coi tăng trưởng nhu cầu kiểm thử là tương đương với tình trạng thiếu hụt năng lực chắc chắn.
38GW không phải là điểm cuối của nhu cầu, mà là bài kiểm tra năng lực giao hàng
Điểm đáng chú ý nhất của cuộc kiểm tra chuỗi cung ứng này không chỉ là đưa ra thêm các con số xuất xưởng chip AI, mà còn đặt các ràng buộc mở rộng chính của năm 2027 vào cùng một mô hình: Nvidia tiếp tục tăng mật độ GPU, Google TPU tăng tốc sản lượng, nhu cầu HBM và CoWoS tăng song song, và nhu cầu điện năng ngầm của chip được đẩy lên 38GW.
Những con số này vẫn phụ thuộc vào nhiều giả định. Giải pháp HBM phân tầng của Rubin Ultra vẫn chưa được chốt cuối cùng, tác động của việc giảm cấu hình bộ nhớ đến hiệu suất suy luận ngữ cảnh dài vẫn cần được xác minh; công suất CoWoS và HBM cần được mở rộng theo kế hoạch; máy chủ, giá đỡ, điện năng và tản nhiệt cũng cần theo kịp tiến độ giao chip.
Giải pháp kết nối cũng có thể tạo ra khác biệt. Báo cáo cho biết, do hạn chế của quy trình sản xuất nội địa, tốc độ SerDes của các nhà sản xuất GPU AI Trung Quốc có thể vẫn dừng ở mức 100Gb/s mỗi kênh, do đó kiến trúc siêu nút của họ đang áp dụng nhiều hơn kết nối NPO, trong khi Nvidia về lâu dài coi trọng CPO hơn. Các lộ trình khác nhau sẽ ảnh hưởng đến thiết kế siêu nút, chi phí triển khai và hiệu quả hệ thống.
Vì vậy, 38GW không phải là dự báo chính xác về mức tiêu thụ điện thực tế năm 2027, mà là một bài kiểm tra áp lực được suy ra từ phía xuất xưởng chip. Nó cho thấy nhu cầu chip AI vẫn mạnh mẽ, đồng thời nhắc nhở thị trường: điều quyết định liệu sức mạnh tính toán AI có thể được hiện thực hóa hay không có thể không còn chỉ là lịch sản xuất GPU, mà là liệu HBM, CoWoS, kiểm thử, giá đỡ và điện năng có thể đến đúng thời điểm cùng lúc hay không.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia