Toàn mạng đang bàn tán về Loop Engineering, rốt cuộc nó đã thay đổi điều gì?
TL;DR
· Tháng 6 năm 2026, nhiều người thực hành lập trình AI gần như đồng thời đề xuất Loop Engineering, Stripe đã sử dụng Minions để hợp nhất hơn 1300 PR do AI tạo ra mỗi tuần.
· Phương pháp này không còn phụ thuộc vào việc con người đưa ra từng lời nhắc tuần tự, mà để hệ thống tự động phát hiện nhiệm vụ, bàn giao, xác minh, lưu trạng thái và bước vào vòng tiếp theo.
· Độ tin cậy vẫn phụ thuộc vào bộ đánh giá độc lập, cổng chặn cứng và đánh giá thủ công; nợ xác minh và suy giảm khả năng hiểu có thể khuếch đại ngược lại rủi ro.
Gần đây, một kỹ sư của Anthropic đã công bố tài liệu 11 trang về "Kỹ thuật vòng lặp cho hệ thống tác nhân", đặt Loop Engineering sau Prompt Engineering, Context Engineering và Harness Engineering, coi đây là phương pháp then chốt để lập trình AI bước vào giai đoạn tiếp theo.
Tài liệu này thu hút sự chú ý vì nó trúng đúng bước ngoặt của các cuộc thảo luận về lập trình AI vào tháng 6 năm 2026. Addy Osmani, Boris Cherny và Peter Steinberger gần như trong cùng một tuần đã gọi giai đoạn mới của lập trình AI là Loop Engineering, trong khi pipeline Minions của Stripe đã sử dụng ý tưởng tương tự để hợp nhất hơn 1300 Pull Request do AI tạo ra mỗi tuần.
Con số này quan trọng, không phải vì AI đã viết thêm vài dòng code, mà vì trọng tâm phát triển phần mềm đang chuyển từ "con người bảo mô hình viết gì" sang "con người thiết kế một hệ thống tự xếp hàng, nhận nhiệm vụ, viết code, kiểm tra kết quả, lưu trạng thái và tiếp tục chạy".
Trong năm qua, các câu chuyện về công cụ lập trình AI chủ yếu xoay quanh năng lực của mô hình: hoàn thiện code chính xác hơn, cửa sổ ngữ cảnh dài hơn, tác nhân có thể hoàn thành các tác vụ phức tạp hơn trong một lần. Nhưng Loop Engineering thảo luận về một điều khác: khi việc tạo code ngày càng rẻ, điều kỹ sư thực sự cần thiết kế là một vòng lặp vận hành bền vững. Máy móc có thể liên tục tạo ra các giải pháp ứng viên, con người phải quyết định kết quả nào đáng tin cậy, kết quả nào phải chặn lại, và chi phí dài hạn nào đang bị che giấu.
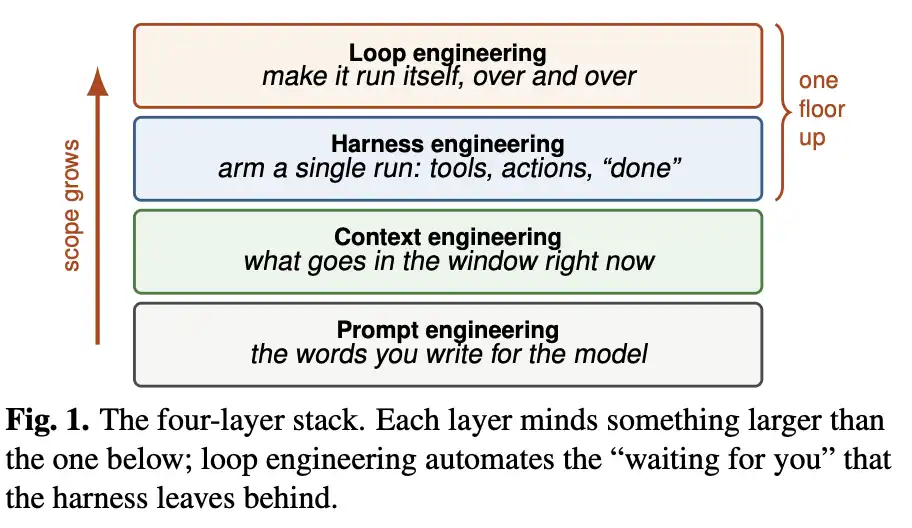
Gần đây, một kỹ sư của Anthropic đã công bố tài liệu dài 11 trang về "Kỹ thuật vòng lặp cho hệ thống tác tử", đặt Loop Engineering sau Prompt Engineering, Context Engineering và Harness Engineering, coi đây là phương pháp then chốt để đưa lập trình AI bước vào giai đoạn tiếp theo. Bài viết này lấy tài liệu đó làm điểm khởi đầu, kết hợp với các cuộc thảo luận công khai của Boris Cherny, Addy Osmani và những người khác, cùng với trường hợp Stripe Minions hợp nhất hơn 1.300 PR do AI tạo ra mỗi tuần, để giải thích Loop Engineering thực chất là gì, tại sao đột nhiên được bàn luận rộng rãi trên toàn mạng, và điều nó thực sự thay đổi không phải là việc viết code, mà là quá trình xác thực, điều phối và đánh giá trong phát triển phần mềm.
Lập trình AI chuyển từ "một lần nhắc" sang "vòng lặp liên tục"
Loop Engineering được đặt sau Prompt Engineering, Context Engineering và Harness Engineering, như tầng thứ tư của ngăn xếp kỹ thuật AI.
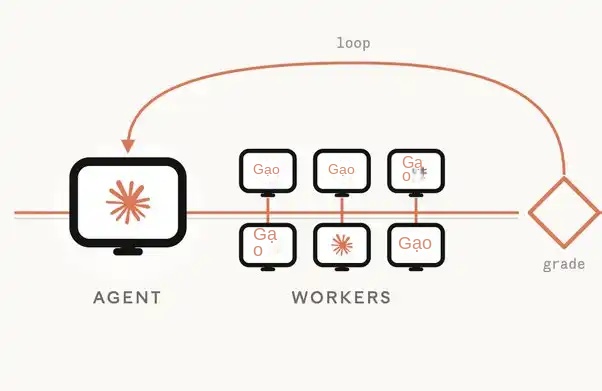
Prompt Engineering giải quyết vấn đề "hỏi thế nào"; Context Engineering giải quyết vấn đề "cho mô hình xem gì"; Harness Engineering giải quyết vấn đề "làm thế nào để kết nối một lần chạy mô hình với công cụ, kiểm thử và quy trình làm việc". Loop Engineering tiến thêm một bước: hệ thống không chỉ thực hiện một tác vụ duy nhất, mà có thể khởi động lại trong khoảng thời gian cố định hoặc dưới điều kiện kích hoạt, lấy kết quả của lần trước làm đầu vào cho vòng tiếp theo.
Một vòng lặp hoàn chỉnh thường bao gồm năm hành động.
Bước đầu tiên là phát hiện công việc, ví dụ như quét các lỗi CI, Issue mở, commit code hoặc tác vụ đang chờ xử lý; bước thứ hai là chuyển giao tác vụ, sắp xếp tác vụ thành ngữ cảnh mà mô hình có thể xử lý; bước thứ ba là xác thực độc lập, kiểm tra xem code do mô hình tạo ra có thực sự chạy được không, có vượt qua kiểm thử không, có gây ra tác dụng phụ không; bước thứ tư là lưu trữ kết quả, ghi trạng thái, đánh giá và các công việc chưa hoàn thành vào tệp hoặc hệ thống; bước thứ năm là lên lịch vòng lặp, để vòng tiếp theo tiếp tục chạy vào thời điểm thích hợp.
Điểm quan trọng nhất ở đây không phải là "tạo sinh", mà là "xác thực". Nếu một vòng lặp chỉ liên tục để mô hình viết code, rồi lại để chính mô hình đó tự khen ngợi kết quả của mình, nó rất dễ biến thành "vòng lặp gật đầu": mỗi vòng trông có vẻ tiến triển, nhưng thực chất chỉ là đóng gói lỗi một cách hoàn chỉnh hơn.
Vòng lặp triage buổi sáng của Osmani là một ví dụ cá nhân: hệ thống tự động đọc các bài kiểm tra CI thất bại của ngày hôm trước, các Issue đang mở và các commit gần đây, tạo ra một tệp trạng thái, và đưa những vấn đề không thể xử lý vào hộp thư đến thủ công. Giá trị của nó không phải là thay thế kỹ sư đưa ra mọi quyết định, mà là thực hiện sàng lọc sơ bộ trước khi kỹ sư thức dậy, để lại sự chú ý cho những phần thực sự cần phán đoán.
1300 PR của Stripe: Độ tin cậy đến từ ràng buộc, không phải mô hình
Đường ống Minions của Stripe là trường hợp doanh nghiệp ấn tượng nhất trong cuộc thảo luận này: mỗi tuần hợp nhất hơn 1300 Pull Request do AI tạo ra, và bản thân mã nguồn không được viết thủ công từng dòng.
Tuy nhiên, điều này không có nghĩa là Stripe giao hệ thống sản xuất cho một mô hình lớn tự do sáng tạo. Ngược lại, điểm mấu chốt của Minions nằm ở quy trình được kiểm soát chặt chẽ: một bộ điều phối xác định trước tiên lắp ráp ngữ cảnh, trích xuất thông tin nhiệm vụ từ Jira, tìm kiếm mã nguồn và các công cụ nội bộ; LLM chịu trách nhiệm tạo mã; sau đó, thông qua linter được mã hóa cứng, kiểm soát commit và cuối cùng là đánh giá thủ công để quyết định có hợp nhất hay không.
Nói cách khác, độ tin cậy không đến từ "mô hình đột nhiên đủ thông minh", mà đến từ một chuỗi các ràng buộc. Mô hình đề xuất các thay đổi ứng viên, hệ thống giới hạn những gì nó có thể chạm vào và những kiểm tra nào nó phải vượt qua, con người đưa ra quyết định cuối cùng về việc có đưa vào nhánh chính hay không.
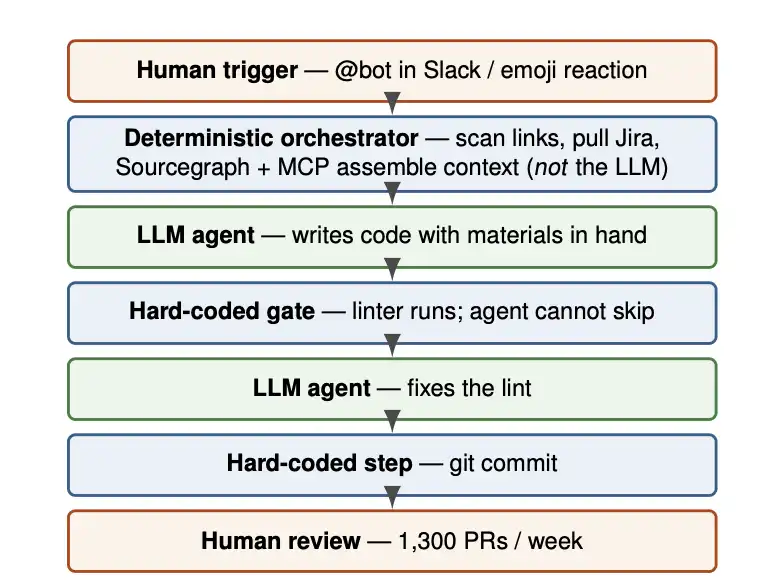
Đây cũng là sự khác biệt giữa Loop Engineering và các tập lệnh lập trình AI thông thường. Các tập lệnh thông thường thường tập trung vào "để mô hình hoàn thành nhiệm vụ"; hệ thống vòng lặp phải xem xét nhiệm vụ đến từ đâu, xử lý thế nào khi thất bại, cách duy trì trạng thái, cách kiểm soát ngân sách, và ai ngăn chặn lỗi xâm nhập vào môi trường sản xuất.
Nếu không có những ràng buộc này, 1300 PR mỗi tuần không phải là bước nhảy vọt về hiệu quả, mà có thể là một cỗ máy tạo ra nợ kỹ thuật.
Trình tạo và trình đánh giá phải được tách biệt
Một thiết kế cốt lõi của Loop Engineering là tách biệt trình tạo và trình đánh giá.
Trình tạo chịu trách nhiệm viết mã, sửa tệp và gửi kết quả ứng viên. Trình đánh giá chịu trách nhiệm tìm lỗi, và tốt nhất là mặc định cho rằng mã có vấn đề. Cả hai không thể được thực hiện bởi cùng một "tác nhân lạc quan", vì mô hình khi tự đánh giá thường có xu hướng chấp nhận đầu ra của chính nó, đặc biệt là khi mô tả nhiệm vụ mơ hồ, phạm vi kiểm thử không đầy đủ hoặc ngữ cảnh không hoàn chỉnh.
Trình đánh giá độc lập có thể đơn giản hơn, hoài nghi hơn và dễ tinh chỉnh hơn. Nó không cần giải quyết vấn đề một cách sáng tạo, chỉ cần xác minh trang có mở được không, bài kiểm tra có vượt qua không, điều kiện biên có bị phá vỡ không, và mã có tuân thủ các quy tắc đã định hay không. Một số thực tiễn cho phép trình đánh giá nhấp vào trang thực tế thông qua công cụ tự động hóa trình duyệt, thay vì chỉ đọc mã và đưa ra phán đoán.
Điều này giải thích tại sao "xác minh" là khâu khó nhất trong vòng lặp năm bước. Việc tạo mã ngày càng rẻ hơn, nhưng chứng minh một đoạn mã thực sự đúng vẫn còn đắt đỏ. Đặc biệt trong các kho mã lớn, lỗi không nhất thiết lộ ra ngay lập tức, và kiểm thử cũng không nhất thiết bao phủ các đường dẫn kinh doanh thực tế. Vòng lặp chạy càng nhanh, các giả định chưa được xác minh tích lũy càng nhanh.
Chi phí tiềm ẩn sẽ tự củng cố lẫn nhau
Rủi ro của Loop Engineering không nằm ở việc nó có thể viết sai mã hay không, mà ở chỗ nó có thể khiến nhóm khó nhận ra rằng họ đã mất đi sự hiểu biết.
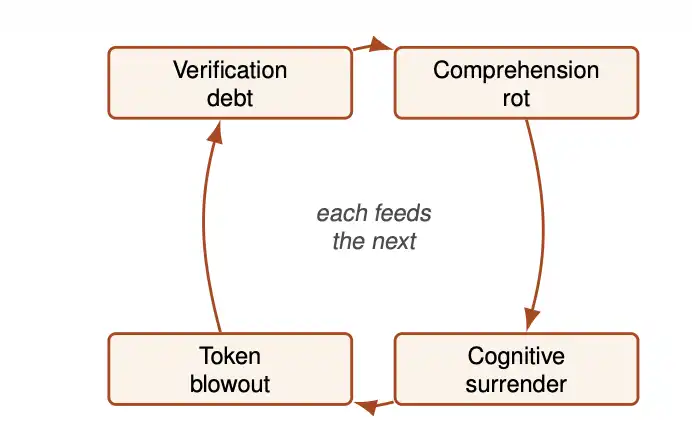
Loại chi phí đầu tiên là nợ xác minh. Những lỗi không được kiểm thử bao phủ sẽ tích lũy liên tục trong vòng lặp, cho đến khi một lần hợp nhất hoặc triển khai nào đó mới bùng phát tập trung. Loại thứ hai là suy giảm khả năng hiểu. Kho mã liên tục mở rộng, nhưng kỹ sư không trực tiếp trải qua các quyết định thiết kế quan trọng, bản đồ tư duy vẫn ở phiên bản cũ. Loại thứ ba là đầu hàng nhận thức. Con người bắt đầu mặc định chấp nhận đầu ra của máy móc, chỉ thực hiện phê duyệt hình thức. Loại thứ tư là sự bùng nổ tiêu thụ token. Việc thử lại, tác nhân phụ, ngữ cảnh dài và xác minh nhiều vòng sẽ khiến hóa đơn tăng nhanh chóng.
Bốn loại chi phí này sẽ nuôi dưỡng lẫn nhau: kiểm thử không đủ dẫn đến nợ xác minh, nợ xác minh tăng khiến kỹ sư càng ngại tìm hiểu sâu, hiểu biết giảm sút làm cho việc xem xét thủ công trở thành con dấu cao su, và việc xem xét kiểu con dấu cao su lại thúc đẩy thêm nhiều lần thử lại tự động và chi phí cao hơn.
Do đó, cùng một bộ thành phần vòng lặp, trong tay các kỹ sư khác nhau có thể tạo ra kết quả hoàn toàn trái ngược. Người có khả năng phán đoán mạnh, ranh giới rõ ràng có thể dùng vòng lặp để khuếch đại sự hiểu biết của mình về hệ thống, coi máy móc như một lớp thực thi không biết mệt mỏi; người có khả năng phán đoán yếu hoặc phụ thuộc quá nhiều vào tự động hóa, sau vài tháng có thể trở thành "người gác cổng" của hệ thống của chính mình, chỉ biết phê duyệt hoặc từ chối, nhưng không thể giải thích tại sao hệ thống lại hoạt động như vậy.
Khi mã trở nên rẻ hơn, thứ đắt đỏ là phán đoán
Loop Engineering đưa một xu hướng dài hạn lên vị trí rõ ràng hơn: mã, kế hoạch, PR và phân tách nhiệm vụ đang trở nên gần như miễn phí, nhưng "cái gì thực sự đúng" không hề rẻ hơn.
Đối với doanh nghiệp, điều này có nghĩa là trọng tâm đầu tư vào lập trình AI có thể chuyển từ việc mua các mô hình mạnh hơn sang thiết kế các quy trình ổn định hơn: ranh giới nhiệm vụ, lắp ráp ngữ cảnh, đánh giá độc lập, duy trì trạng thái, giới hạn ngân sách, điểm xem xét thủ công, và cách dừng vòng lặp khi có bất thường. Khả năng của mô hình vẫn quan trọng, nhưng nó chỉ là một phần của hệ thống.
Đối với kỹ sư, vai trò cũng đang thay đổi. Công việc cốt lõi trước đây là viết mã, giờ đây ngày càng nhiều công việc trở thành xem xét các câu trả lời ứng viên do máy tạo ra: nó có đáp ứng yêu cầu không, có phá vỡ kiến trúc không, có chỉ trông có vẻ hợp lý không, có đẩy độ phức tạp cho người bảo trì tương lai không.
Điều này không có nghĩa là lập trình viên đã bị thay thế. Ngược lại, Loop Engineering giống như một bộ khuếch đại khả năng phán đoán. Nó cho phép một kỹ sư tạo ra khối lượng thay đổi mà trước đây chỉ một nhóm nhỏ mới làm được, nhưng cũng có thể khuếch đại sự lười biếng, mù quáng tin tưởng và thiếu kiểm chứng thành các sự cố sản xuất.
Sự phân nhánh thực sự nằm ở việc con người có còn giữ đủ quyền phán đoán và phủ quyết mạnh mẽ hay không. AI có thể liên tục gửi PR, nhưng việc có được merge, có nên đưa lên môi trường production, hay về lâu dài có làm sụp đổ hệ thống hay không, vẫn phụ thuộc vào con người.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan