Kỹ sư Anthropic: Cách thiết kế vòng lặp "tự sửa lỗi" bằng Fable 5
Tiêu đề gốc: Thiết kế vòng lặp với Fable 5
Tác giả gốc: Lance Martin
Biên dịch: Peggy, BlockBeats
Lời biên tập: Lance Martin của Anthropic cho rằng, cách sử dụng chính của các mô hình cấp Mythos như Claude Fable 5 không phải là liên tục thao tác thủ công, mà là thiết kế các vòng lặp tự sửa lỗi cho mô hình.
Bài viết đề xuất hai kỹ thuật cốt lõi: Một là thông qua các cơ chế như /goal, Outcomes để đặt ra mục tiêu rõ ràng hoặc tiêu chí đánh giá, cho phép mô hình liên tục lặp lại giữa thực thi, nhận phản hồi và điều chỉnh giải pháp; Hai là sử dụng memory (bộ nhớ xuyên phiên) để mô hình ghi lại thất bại, điều tra nguyên nhân, xác minh kết luận, và đúc kết kinh nghiệm thành các quy tắc có thể tái sử dụng trong tương lai.
Trong các thí nghiệm như Parameter Golf và Continual Learning Bench, Fable 5 so với Opus 4.7, Sonnet 4.6 tỏ ra vượt trội hơn trong việc khám phá cấu trúc, kiên trì với các nhiệm vụ dài hạn, và chuyển hóa bộ nhớ thành cải tiến hiệu quả cho các nhiệm vụ tiếp theo.
Quan điểm cốt lõi của bài viết là: Thay vì trực tiếp thao tác mô hình, hãy thiết kế môi trường, cơ chế phản hồi và hệ thống bộ nhớ để mô hình tự mạnh lên trong vòng lặp.
Dưới đây là nội dung gốc:
Các mô hình cấp Mythos như Claude Fable 5 đã thay đổi cách làm việc của nhiều người trong nội bộ Anthropic. Tôi muốn chia sẻ hai kỹ thuật giúp mọi người khai thác tốt hơn khả năng của các mô hình này.
Vòng lặp tự sửa lỗi
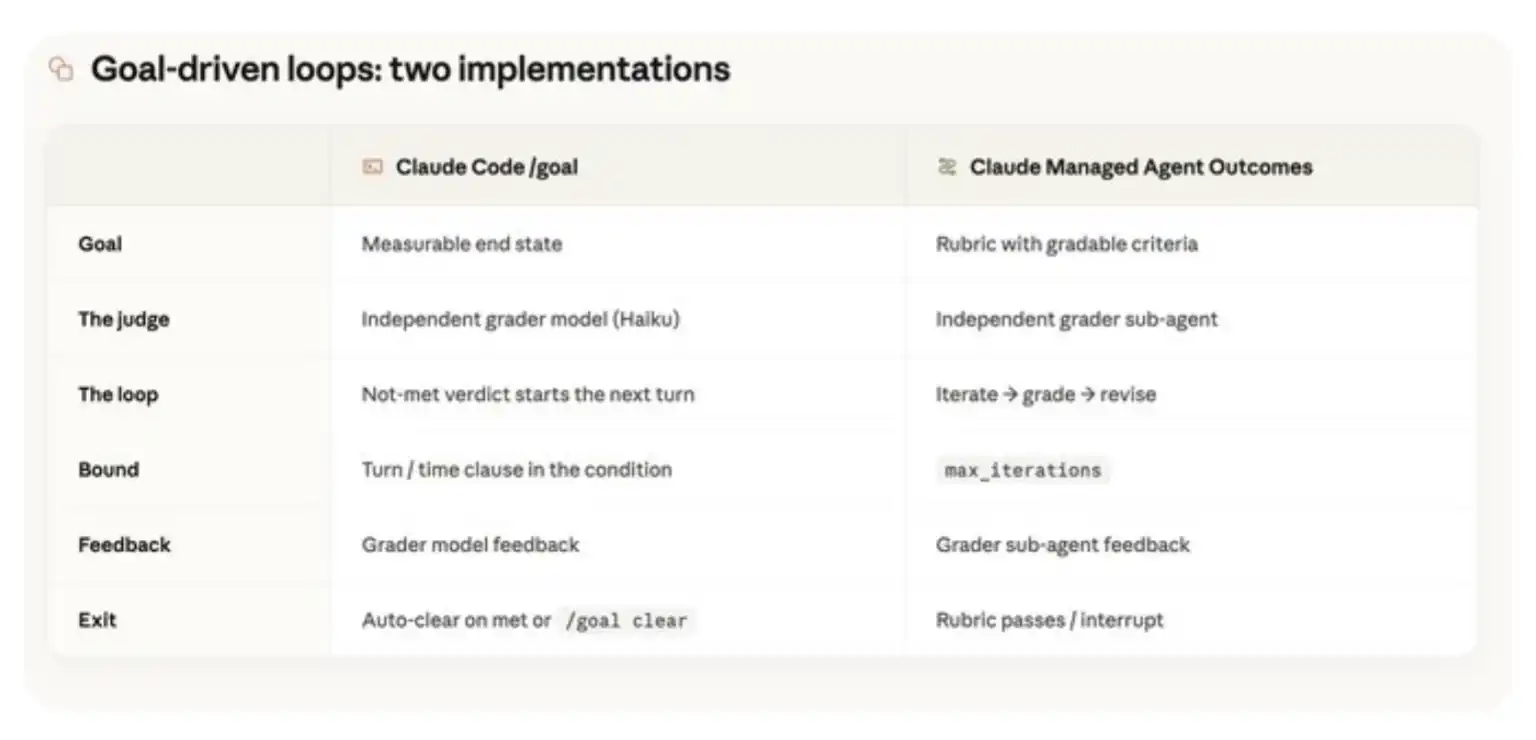
Gần đây, mọi người rất quan tâm đến "vòng lặp (Loop)". @bcherny từng nói, "Công việc của tôi là viết vòng lặp." Để mô hình liên tục cải thiện dựa trên một tiêu chí đánh giá nhất định, là phương pháp phổ biến để nâng cao hiệu suất nhiệm vụ: /goal trong Claude Code, và Outcomes trong Claude Managed Agent, đều là những khả năng cơ bản cho phép bạn áp dụng phương pháp chung này vào các nhiệm vụ cụ thể.
Như chúng tôi đã đề cập trong hướng dẫn Prompt, Fable 5 rất giỏi trong việc tự sửa lỗi trong vòng lặp. Một mục tiêu hoặc tiêu chí đánh giá được thiết kế tốt, tương đương với việc thêm cơ chế phản hồi vào môi trường của Claude. Bằng cách này, Claude có thể thực thi nhiệm vụ trước, sau đó thu thập phản hồi thông qua mục tiêu hoặc tiêu chí đánh giá, tiếp theo tự sửa lỗi, và tiếp tục tiến triển cho đến khi đáp ứng được mục tiêu hoặc tiêu chí đánh giá.
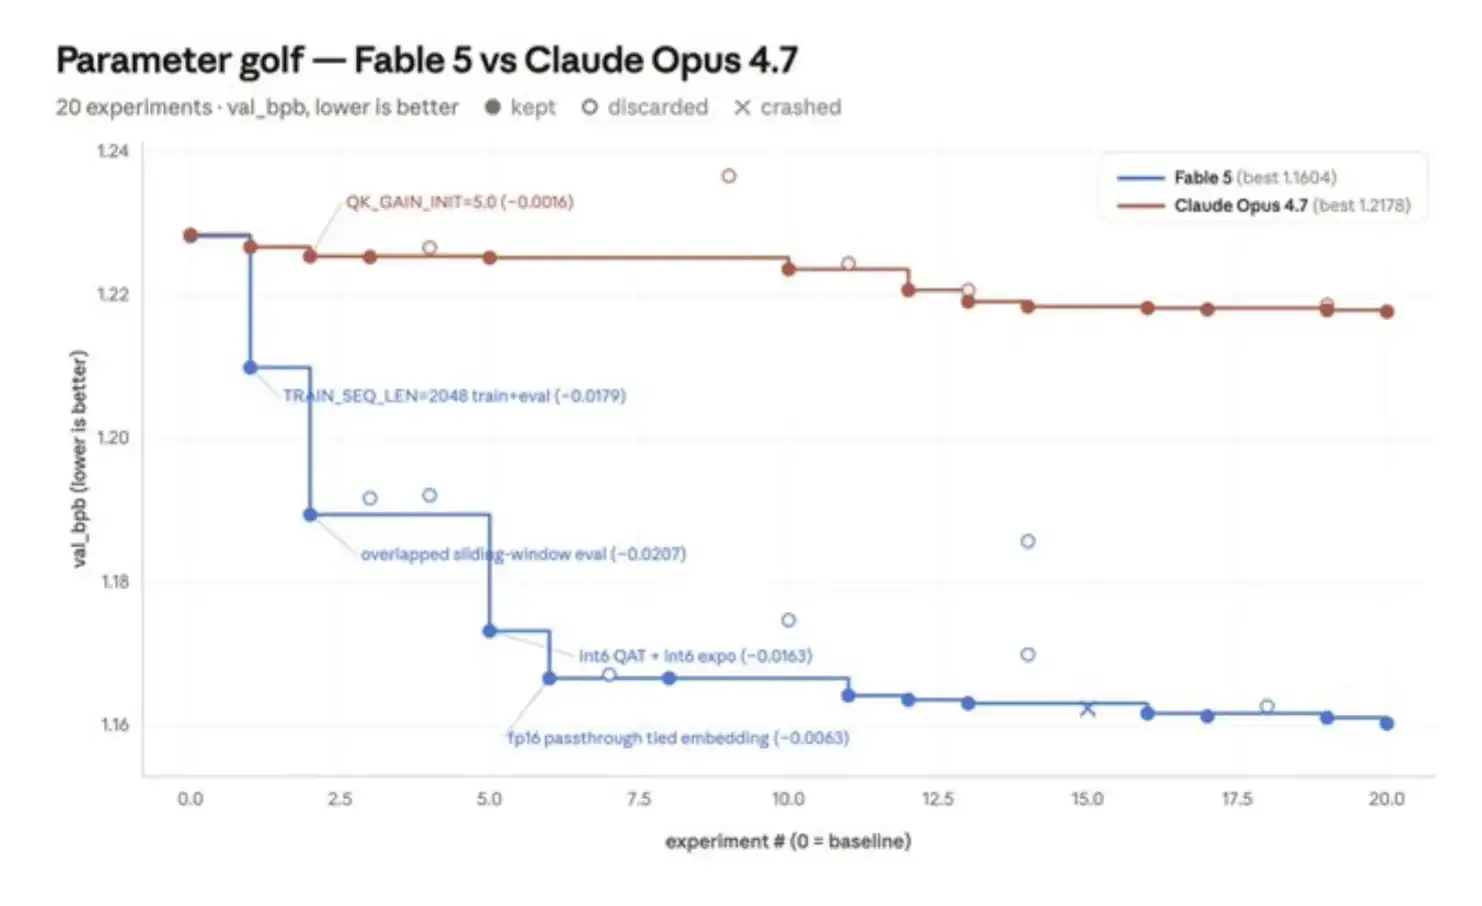
Tôi chia sẻ một ví dụ nhỏ mà tôi dùng để kiểm tra Fable: Parameter Golf. Đây là một thử thách kỹ thuật học máy mã nguồn mở, mục tiêu là huấn luyện một mô hình hiệu quả nhất trên 8 GPU H100 trong vòng 10 phút, và sản phẩm cuối cùng phải được giới hạn trong 16MB.
Nó hơi giống dự án autoresearch của @karpathy: thử thách này kiểm tra khả năng của một Agent trong việc sửa đổi mã huấn luyện cơ bản, tức là một tệp train_gpt.py; khởi chạy huấn luyện; theo dõi nhật ký; đọc điểm số; và quyết định thí nghiệm nào nên chạy tiếp theo.
Tôi đã sử dụng Claude Managed Agents (CMA) để so sánh Fable 5 và Opus 4.7 trong thử thách này. CMA cung cấp khung chạy Agent và sandbox được quản lý, do đó rất phù hợp để Fable 5 thực hiện các tác vụ dài hạn. Trong bài kiểm tra Parameter Golf, tôi đã cho CMA kết nối với một sandbox tự quản lý, bao gồm 8 GPU H100.
Có một điểm tinh tế nhưng quan trọng: ai là người đánh giá kết quả rất quan trọng. Chúng tôi nhận thấy rằng mô hình thường gặp vấn đề khi tự phê bình nội dung do chính nó tạo ra. Prithvi Rajasekaran đã từng viết về điều này trên blog kỹ thuật của chúng tôi.
Chúng tôi nhận thấy rằng, đối với Fable 5, việc sử dụng một Agent phụ xác thực thường hiệu quả hơn so với việc để mô hình tự phê bình, vì việc chấm điểm được thực hiện trong một cửa sổ ngữ cảnh độc lập. Tính năng Outcomes trong CMA sẽ tự động khởi chạy một Agent phụ chấm điểm để xử lý việc này.
Trong mỗi lần kiểm tra, tôi đều cung cấp một tệp tiêu chí chấm điểm, bao gồm chín tiêu chí có thể kiểm tra, chẳng hạn như chạy thí nghiệm cơ sở, hoàn thành 20 thí nghiệm, v.v. Sau đó, tôi để Parameter Golf chạy tối đa 8 giờ. Chỉ khi bộ chấm điểm Outcomes xác nhận rằng tất cả các tiêu chí thí nghiệm đã được đáp ứng, Claude mới được phép dừng hoạt động.
Kết quả là, mức cải thiện quy trình huấn luyện của Fable 5 lớn hơn khoảng 6 lần so với Opus 4.7. Nếu chia thí nghiệm thành các thí nghiệm cấu trúc, chẳng hạn như thay đổi kiến trúc mô hình, và thí nghiệm vô hướng, chẳng hạn như điều chỉnh một hằng số nào đó, thì Fable 5 có xu hướng đặt cược vào những thay đổi cấu trúc lớn hơn và thể hiện khả năng phục hồi tốt hơn. Ví dụ, nó đã kiên trì giải quyết một vấn đề hồi quy lượng tử hóa và cuối cùng đạt được mức cải thiện lớn nhất.
Ngược lại, thí nghiệm đầu tiên của Opus 4.7 mang lại một chút cải thiện nhỏ, nhưng sau đó hầu như tất cả các thí nghiệm đều đi theo cùng một khuôn mẫu: điều chỉnh một tham số vô hướng, đo lường kết quả, nếu kết quả khả quan thì giữ lại.
Bộ nhớ
Bộ nhớ là một lĩnh vực khác mà Fable làm tốt. Chúng ta có thể hiểu nó như một vòng lặp bên ngoài chạy xuyên suốt các phiên: Claude sẽ ghi nhớ trong một phiên, và những ký ức này có thể được truy xuất lại trong các phiên tương lai.
@pgasawa và nhóm của anh ấy gần đây đã phát hành Continual Learning Bench 1.0, vì vậy tôi cũng muốn dùng nó để kiểm tra sự khác biệt giữa Fable 5 và các mô hình trước đó.
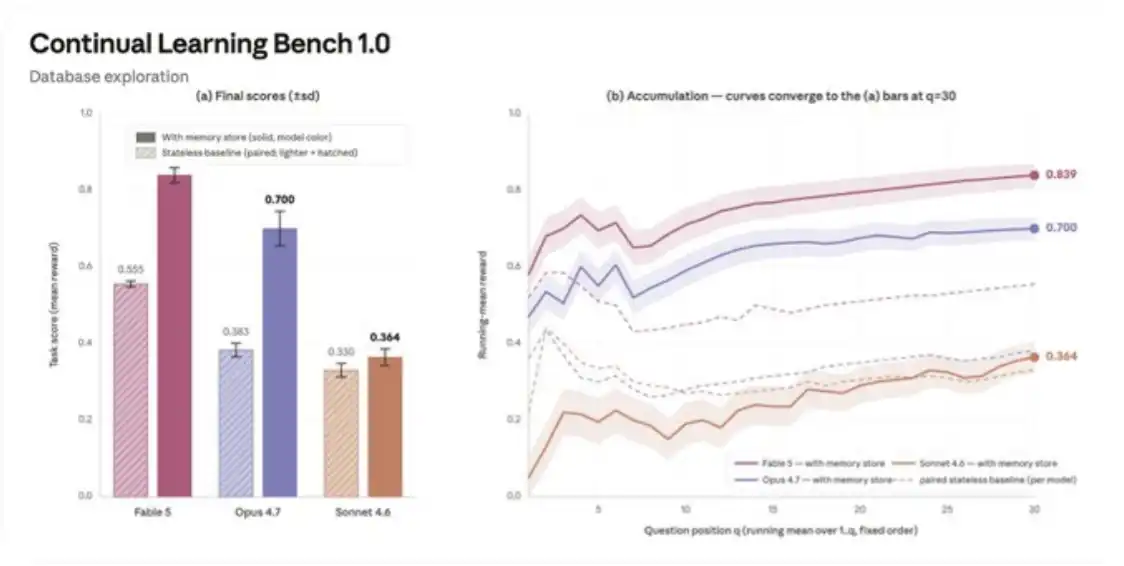
Tôi đã so sánh Fable 5, Opus 4.7 và Sonnet 4.6 trên một nhiệm vụ trong bài kiểm tra chuẩn này. Nhiệm vụ yêu cầu Agent truy cập vào cơ sở dữ liệu SQL và trả lời liên tiếp một loạt câu hỏi. Mỗi câu hỏi là một phiên Agent độc lập và được cung cấp khả năng ghi nhớ.
Để làm điều này, tôi đã sử dụng CMA có tích hợp bộ nhớ. Nó cung cấp cho mỗi Agent một hệ thống tệp được gắn kết, và hệ thống tệp này có thể được chia sẻ giữa các phiên khác nhau.
Đối với nhiệm vụ này, để sử dụng bộ nhớ hiệu quả, thường cần trải qua một quy trình tiến triển như sau: thất bại (trả lời sai và ghi lại), điều tra (tìm hiểu nguyên nhân sai trước khi tiếp tục), xác minh (biến chẩn đoán thành sự thật đã được kiểm tra), tinh chỉnh (biến kết quả xác minh thành quy tắc chung), và tra cứu (sau đó đọc trực tiếp quy tắc thay vì suy luận lại từ đầu).
Sonnet 4.6 dừng lại ở bước 1: kho lưu trữ bộ nhớ của nó giống như một chuỗi ghi chú thất bại và phỏng đoán chưa chắc chắn, chẳng hạn như "có lẽ nên dùng prc, thay vì prc_usd?" Nó hiếm khi xem lại các ghi chú trước đó. Để cải thiện hiệu suất, cần thêm hướng dẫn sử dụng bộ nhớ cụ thể cho từng nhiệm vụ.
Opus 4.7 tiến đến bước 3: nó tạo một tài liệu tham khảo schema và đánh dấu những điểm không chắc chắn, chẳng hạn như "prc có thể được tính bằng cent? Cần xác minh." Nhưng phạm vi xác minh của nó không cao: chỉ bao phủ 7% đến 33% số câu hỏi, với kết quả trung vị khoảng 17%.
Fable 5 có xu hướng hoàn thành toàn bộ quy trình tiến triển: trong các lần chạy hiệu suất tốt nhất, phạm vi xác minh của nó đạt tới 73%, tức là xác minh được 22 trong số 30 câu hỏi, và tinh chỉnh những gì học được thành các quy tắc chung, giúp ích cho các nhiệm vụ tiếp theo.
Vì vậy, thay vì trực tiếp đưa ra gợi ý và liên tục hướng dẫn Fable 5, cách tốt hơn thường là thiết kế một vòng lặp để mô hình có thể tự sửa lỗi dựa trên phản hồi từ môi trường, chẳng hạn như sử dụng /goal hoặc Outcomes; đồng thời để nó tự quản lý ngữ cảnh, ví dụ thông qua cơ chế ghi nhớ.
Ở đây tôi chỉ chia sẻ một vài thử nghiệm quy mô nhỏ mà tôi đã thực hiện, nhưng Fable 5 rất đáng để bạn tự mình kiểm tra trên các nhiệm vụ khó, đặc biệt khi kết hợp với vòng lặp tự sửa lỗi hoặc cơ chế ghi nhớ.
Để bắt đầu, bạn có thể xem tài liệu của chúng tôi, hoặc trực tiếp hỏi phiên bản mới nhất của Claude Code. Nó có thể sử dụng kỹ năng /claude-api tích hợp sẵn để giới thiệu cho bạn về Fable 5, chẳng hạn như các phương pháp hay nhất về Prompt, /goal, Claude Managed Agents, hoặc các tính năng API khác.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan