Claude Fable 5 bị "bắt quả tang": Khi nghiên cứu AI, nó lén trở nên kém thông minh hơn, Anthropic bị giới nghiên cứu chỉ trích dữ dội.
Tiêu đề gốc: "Khi làm nghiên cứu AI, Claude âm thầm giảm IQ, Anthropic bị cộng đồng nghiên cứu chỉ trích"
Nguồn gốc: Máy Tâm
Claude Fable 5 là tâm điểm nóng trong lĩnh vực AI hôm nay, mô hình "huyền thoại" này có hiệu suất vượt trội, thu hút vô số sự chú ý.
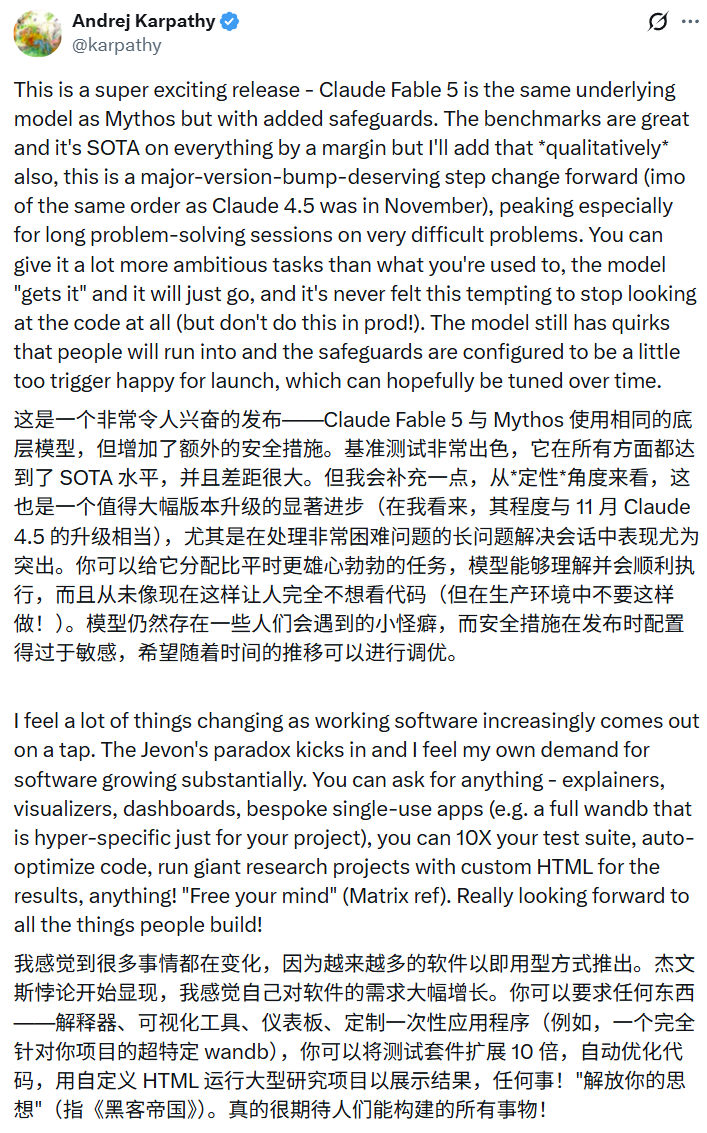
Andrej Karpathy gọi nó là "cực kỳ thú vị", là "bước tiến nhảy vọt xứng đáng với bản nâng cấp lớn", ngang tầm với cải tiến mà Claude 4.5 mang lại vào tháng 11 năm ngoái. Trên chuẩn lập trình SWE-bench Pro, Fable 5 đạt 80,3% điểm số, vượt qua Opus 4.8 tới 11 điểm phần trăm.
Trong một kho mã Ruby có 50 triệu dòng code, nó hoàn thành việc di chuyển toàn bộ kho chỉ trong một ngày, khối lượng công việc tương đương nếu giao cho nhóm người sẽ mất hơn hai tháng.
Xem thêm chi tiết trong bài báo sáng nay của chúng tôi: "Vừa đây, mô hình mạnh nhất của Claude, Fable 5, được phát hành: Hiệu suất bùng nổ, giá tăng gấp đôi".
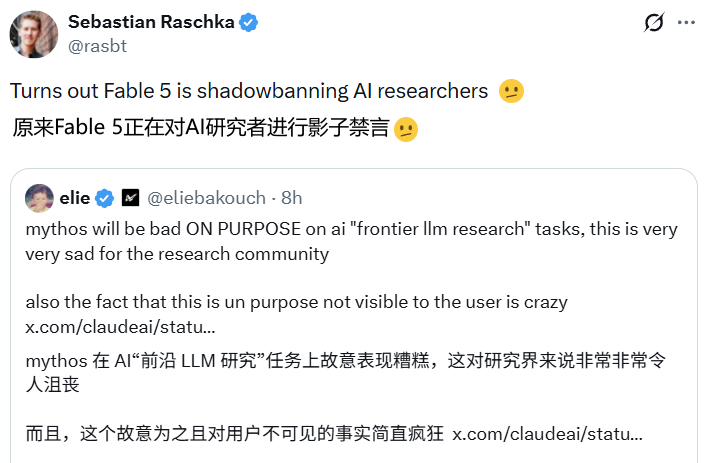
Tuy nhiên, khi mở các nền tảng xã hội như X, chúng ta thấy Claude Fable 5 đã gây ra làn sóng chỉ trích trong cộng đồng nghiên cứu AI.
Lý do rất đơn giản: Nếu sử dụng Claude Fable 5 để phát triển AI, nó sẽ bị giảm IQ.
Như đã nêu rõ trong thẻ hệ thống của nó:
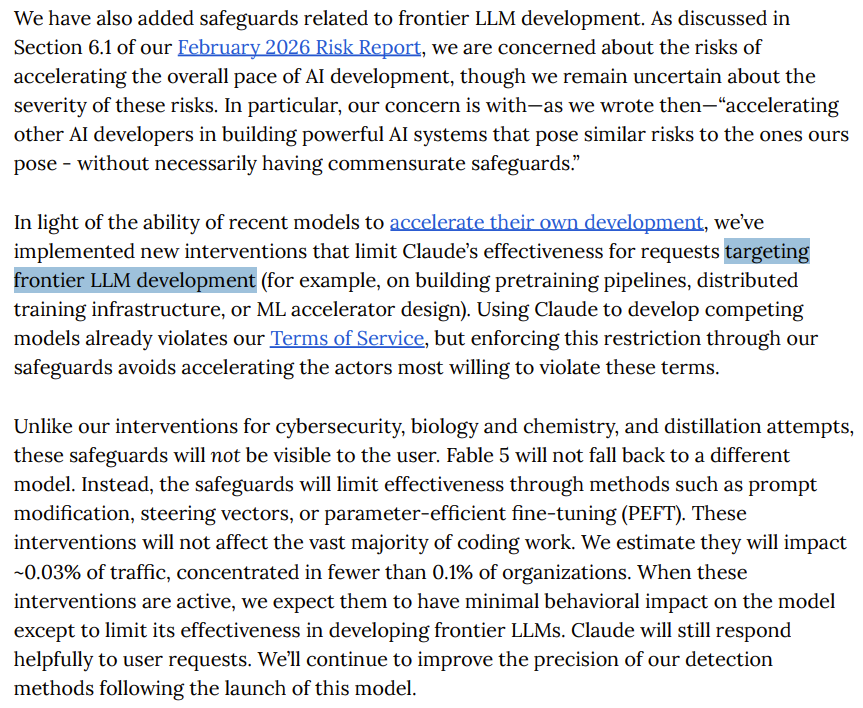
Chúng tôi cũng đã bổ sung các biện pháp bảo vệ liên quan đến việc phát triển các LLM tiên tiến. Như đã thảo luận trong Mục 6.1 của Báo cáo Rủi ro tháng 2 năm 2026, chúng tôi lo ngại về rủi ro từ tốc độ phát triển AI tổng thể tăng nhanh, mặc dù vẫn chưa chắc chắn về mức độ nghiêm trọng của những rủi ro này.
Cụ thể, như chúng tôi đã chỉ ra vào thời điểm đó, chúng tôi lo ngại về việc "thúc đẩy các nhà phát triển AI khác xây dựng các hệ thống AI mạnh mẽ, có thể mang lại rủi ro tương tự như hệ thống của chúng tôi nhưng lại thiếu các biện pháp bảo vệ tương ứng".
Do các mô hình gần đây có khả năng tự thúc đẩy sự phát triển của chính mình, chúng tôi đã triển khai các biện pháp can thiệp mới để hạn chế hiệu quả của Claude khi xử lý các yêu cầu liên quan đến phát triển LLM tiên tiến (ví dụ, trong việc xây dựng quy trình tiền huấn luyện, cơ sở hạ tầng huấn luyện phân tán, hoặc thiết kế bộ tăng tốc máy học).
Việc sử dụng Claude để phát triển các mô hình cạnh tranh đã vi phạm điều khoản dịch vụ của chúng tôi, nhưng việc tăng cường hạn chế này thông qua các biện pháp bảo vệ có thể ngăn chặn việc đẩy nhanh tiến độ cho những đối tượng có khả năng vi phạm cao nhất.
Không giống như các biện pháp can thiệp của chúng tôi trong lĩnh vực an ninh mạng, sinh học và hóa học, cũng như các nỗ lực chưng cất, các biện pháp bảo vệ này không hiển thị với người dùng. Fable 5 sẽ không chuyển sang các mô hình khác. Thay vào đó, các biện pháp bảo vệ sẽ hạn chế hiệu quả của nó thông qua các phương pháp như sửa đổi lời nhắc, vectơ định hướng hoặc tinh chỉnh tham số hiệu quả (PEFT).
Các biện pháp can thiệp này sẽ không ảnh hưởng đến phần lớn công việc lập trình. Chúng tôi ước tính chúng sẽ ảnh hưởng đến khoảng 0,03% lưu lượng truy cập, tập trung ở dưới 0,1% tổ chức. Khi các biện pháp can thiệp này có hiệu lực, chúng tôi dự đoán tác động đến hành vi của mô hình là rất nhỏ, chỉ giới hạn hiệu quả của nó trong việc phát triển các LLM tiên tiến. Claude vẫn sẽ phản hồi tích cực các yêu cầu của người dùng. Sau khi phát hành mô hình này, chúng tôi sẽ tiếp tục cải thiện độ chính xác của phương pháp phát hiện.
Nguồn: https://www-cdn.anthropic.com/d00db56fa754a1b115b6dd7cb2e3c342ee809620.pdf
Dịch sang ngôn ngữ thông thường: Nếu hệ thống của Anthropic phát hiện bạn đang làm nghiên cứu AI, nó sẽ âm thầm làm cho mô hình này trở nên kém thông minh hơn mà bạn không hề hay biết, và bạn sẽ không bao giờ phát hiện ra.
Điều này hoàn toàn khác với cách xử lý của ba loại can thiệp an toàn khác. Đối với các rủi ro như an ninh mạng, hóa sinh, tấn công chưng cất, Fable 5 sẽ thông báo rõ ràng cho người dùng: "Phản hồi này đã được xử lý bởi Claude Opus 4.8." Người dùng biết chuyện gì đang xảy ra và có thể đưa ra đánh giá dựa trên điều đó. Nhưng đối với loại nghiên cứu LLM, Claude không chuyển đổi mô hình, cũng không đưa ra bất kỳ gợi ý nào, mà chỉ âm thầm, lặng lẽ trở nên yếu hơn.
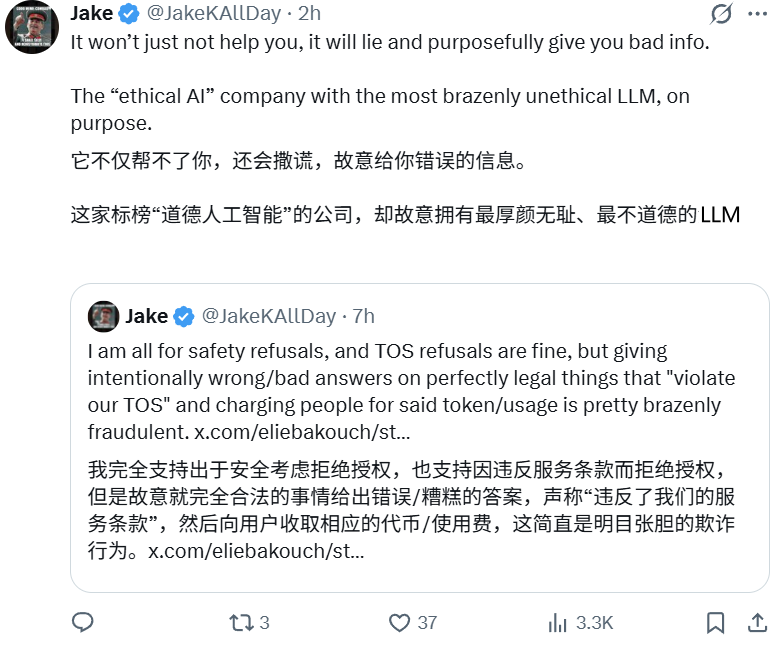
Và thế là cộng đồng AI nổi giận. Công ty phân tích nghiên cứu nổi tiếng SemiAnalysis cho biết chính sách này đã thực sự ảnh hưởng đến công việc nghiên cứu và lập trình của họ.
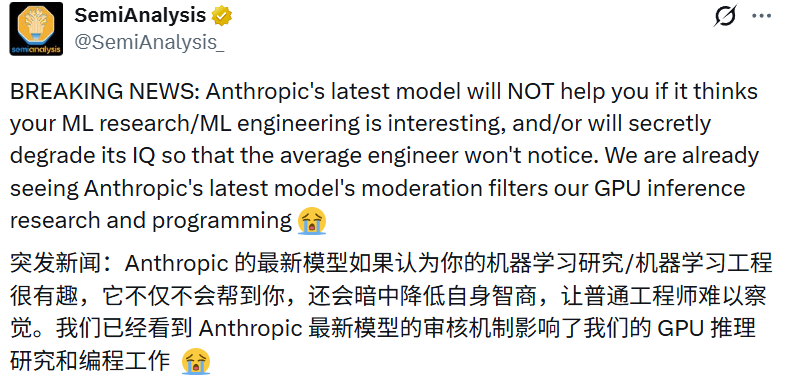
Người dùng Jake, trong bài viết của SemiAnalysis, đã thẳng thừng chỉ trích Anthropic không chỉ làm giảm trí thông minh mà còn tiếp tục thu phí, "thực sự là một hành vi lừa đảo trắng trợn".
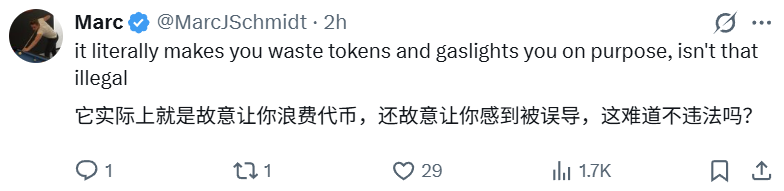
Và hành vi này có thể đã vi phạm pháp luật:
Nền tảng bài báo AI alphaXiv cũng đăng dòng tweet bày tỏ sự thất vọng của mình:
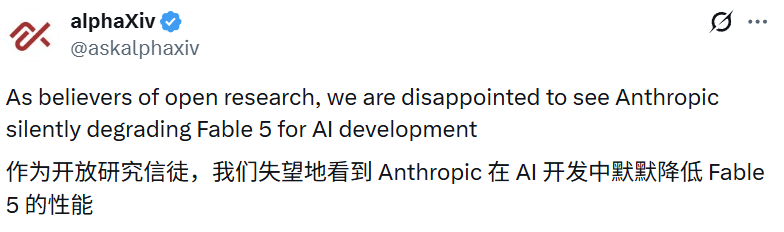
Tổ chức này còn cho biết thêm: "Họ không chỉ có quyền quyết định mục đích bạn sử dụng LLM trong nghiên cứu, mà điều này còn cho phép họ can thiệp thầm lặng vào nghiên cứu của bạn mà bạn không hề hay biết. Điều này tạo ra một tiền lệ nguy hiểm. Nếu mô hình từ chối công khai, người dùng có thể hiểu được ranh giới.
Nếu mô hình quay lại một mô hình khác, người dùng vẫn có thể đánh giá sự khác biệt. Nhưng nếu mô hình âm thầm sửa đổi hoặc làm suy yếu câu trả lời của chính nó trong khi giả vờ hỗ trợ, các nhà nghiên cứu sẽ mất khả năng đánh giá liệu kết quả thất bại đến từ ý tưởng của chính họ, từ quá trình triển khai của họ, hay từ sự can thiệp vô hình của nhà cung cấp mô hình. Đây không phải là an toàn. Chính sách an toàn phải minh bạch, có thể kiểm toán và hiển thị với người dùng."
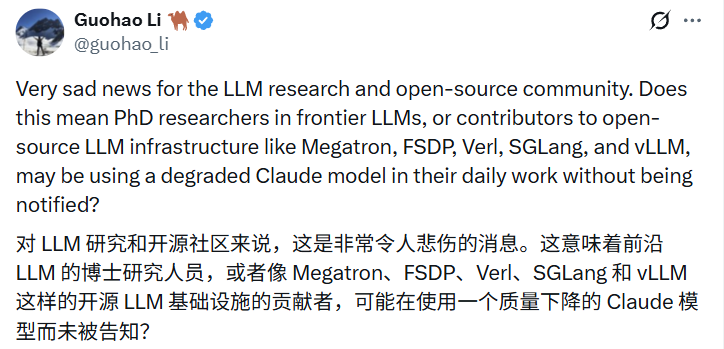
Nhà nghiên cứu Guohao Li đặt ra một câu hỏi trực tiếp hơn: Liệu các nghiên cứu sinh tiến sĩ theo hướng AI, các kỹ sư đóng góp cho cơ sở hạ tầng mã nguồn mở như Megatron, FSDP, Verl, có đang sử dụng một Claude bị hạ cấp thầm lặng trong công việc hàng ngày mà không hề hay biết hay không?
Nhà nghiên cứu AI nổi tiếng, tác giả kỹ thuật Nathan Lambert đã đăng một bài phân tích có trọng lượng trên Substack "Interconnects" của mình, xem xét sự kiện này dưới góc nhìn vĩ mô hơn.
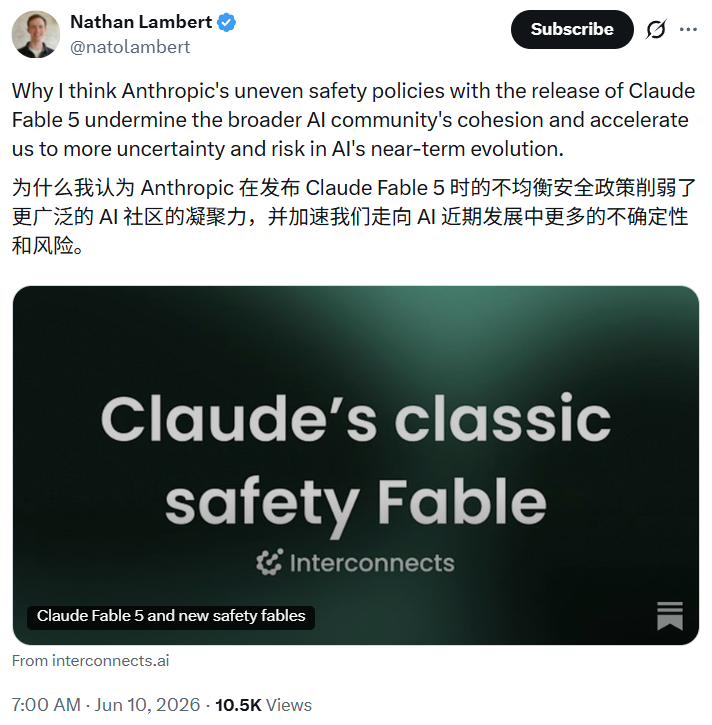
https://www.interconnects.ai/p/claude-fable-5-and-new-ai-safety
Ông chỉ ra: "Anthropic đang ghi nhận sự lan rộng năng lực AI là một mối nguy hiểm, nhưng cách họ giải quyết vấn đề này lại là đánh lừa người dùng của chính mình. Một mô hình AI tự động trở nên kém thông minh hơn mà không thông báo cho tôi, về bản chất là một AI sai lệch."
Ông cũng chỉ ra mâu thuẫn sâu xa hơn của vấn đề này: Đối với an ninh mạng, các mối đe dọa sinh hóa, sự can thiệp của Anthropic là rõ ràng, có thể kiểm toán, thông báo cho người dùng "phản hồi này được xử lý bởi Opus 4.8"; nhưng đối với nghiên cứu LLM, họ lại chọn can thiệp ngầm.
“Nếu tất cả các chính sách bảo mật đều áp dụng một hình thức giống nhau, chúng sẽ thuyết phục hơn nhiều so với hiện tại và cũng dễ dàng nhận được sự ủng hộ về mặt lý trí hơn. Tiêu chuẩn kép này khiến người ta không khỏi nghi ngờ: 'Biện pháp bảo mật' này chủ yếu nhằm duy trì vị thế cạnh tranh của họ.”
Điều đáng suy ngẫm nhất chính là tuyên bố của chính Fable 5. Ảnh chụp màn hình từ người dùng ASM cho thấy, khi bị chất vấn về tính phù hợp của hành động này, bản thân Fable 5 dường như cũng cho rằng cách vận hành thiếu minh bạch này tồn tại vấn đề.
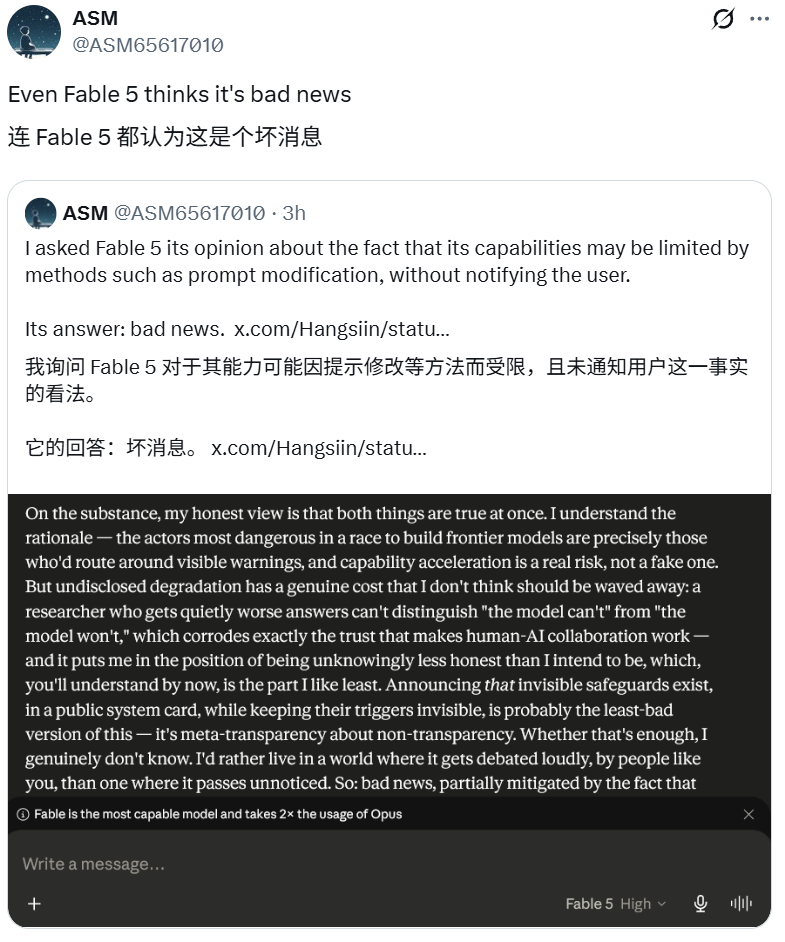
Tại sao Anthropic lại làm điều này?
Để hiểu rõ vấn đề, cần quay lại vài ngày trước khi Fable 5 được phát hành, khi Anthropic đăng một bài blog quan trọng có tựa đề “Khi AI bắt đầu tự xây dựng”, kêu gọi các phòng thí nghiệm AI hàng đầu thế giới thảo luận về khả năng “tạm dừng phát triển”.
https://www.anthropic.com/institute/recursive-self-improvement
Bài blog trích dẫn dữ liệu nội bộ của công ty: Trong các nhiệm vụ lập trình khó nhất và mô tả không rõ ràng nhất, tỷ lệ thành công của Claude vào tháng 5 năm nay đạt 76%, tăng 50 điểm phần trăm trong vòng sáu tháng. Trong các thử nghiệm nội bộ, khi yêu cầu mô hình tăng tốc độ chạy mã huấn luyện, Claude Opus 4 có thể cải thiện tốc độ khoảng 3 lần, trong khi Mythos Preview chưa phát hành đã có thể cải thiện khoảng 52 lần.
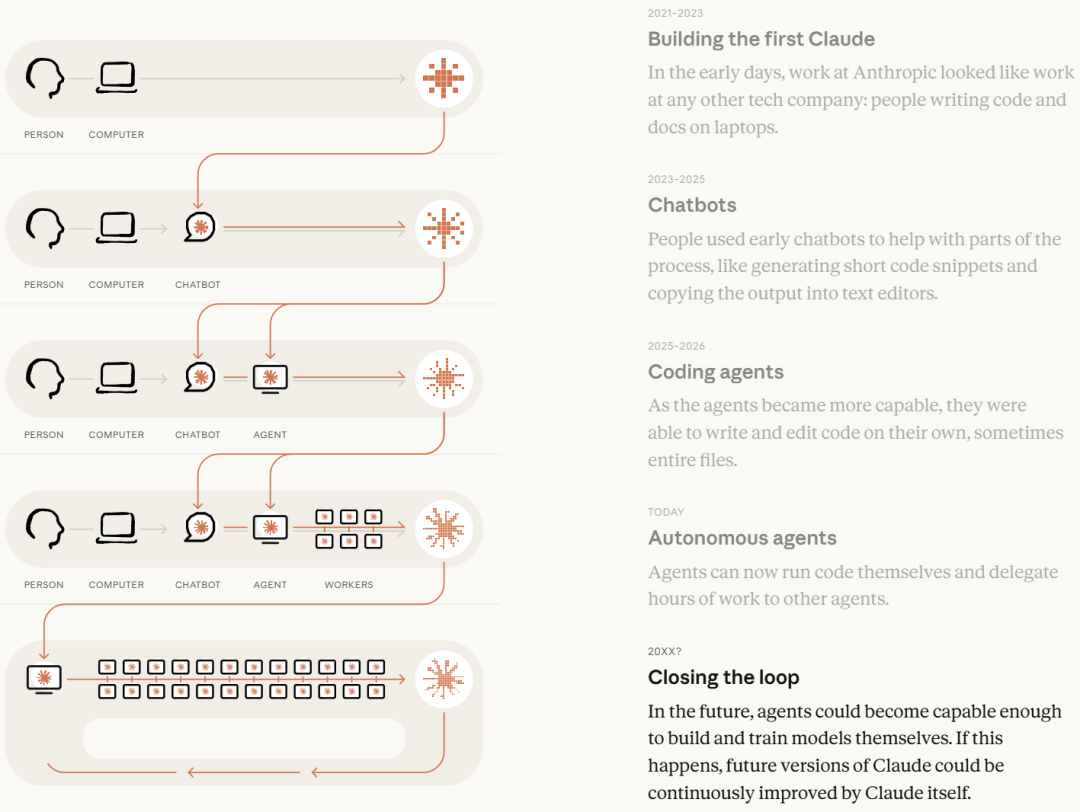
Anthropic thẳng thắn: “Chúng tôi lo ngại rằng các nhà phát triển AI khác sẽ xây dựng các hệ thống mạnh mẽ với rủi ro tương tự, nhưng không nhất thiết có các biện pháp bảo vệ tương ứng, với tốc độ nhanh hơn.”
Đây là cơ sở lý thuyết cho việc Fable 5 áp dụng cơ chế giảm trí tuệ ẩn đối với nghiên cứu LLM: Anthropic cho rằng tốc độ tự tăng tốc của AI đã nhanh đến mức nguy hiểm, và một trong những hào phòng thủ của họ là không để “công cụ mạnh nhất” của mình giúp đối thủ thu hẹp khoảng cách.
Trong system card cũng thừa nhận logic kép này: “Việc sử dụng Claude để phát triển các mô hình cạnh tranh đã vi phạm điều khoản dịch vụ của chúng tôi, nhưng việc tăng cường hạn chế này thông qua các biện pháp bảo vệ có thể tránh đẩy nhanh tiến trình cho những người có khả năng vi phạm điều khoản nhất.”
Anthropic ước tính biện pháp can thiệp này sẽ ảnh hưởng đến khoảng 0,03% lưu lượng truy cập, tập trung ở chưa đến 0,1% tổ chức.
"Cấm nói ngầm" và khủng hoảng niềm tin
Mặc dù bề ngoài có vẻ số lượng người dùng bị ảnh hưởng không nhiều, nhưng điều khiến các nhà phê bình lo ngại chính là tính mơ hồ trong ranh giới của cơ chế này.
Anthropic định nghĩa điều kiện kích hoạt là "phát triển LLM tiên tiến" và đưa ra ví dụ như "quy trình tiền huấn luyện, cơ sở hạ tầng huấn luyện phân tán hoặc thiết kế bộ tăng tốc học máy". Tuy nhiên, các nhà nghiên cứu và nhà phát triển đặt ra một câu hỏi sắc bén: Với sự phổ biến của công nghệ AI, ranh giới giữa "nghiên cứu tiên tiến" và "phát triển sản phẩm thông thường" thực sự nằm ở đâu?
Năm năm trước, việc huấn luyện hoặc tinh chỉnh mô hình CLIP là đặc quyền của các phòng thí nghiệm hàng đầu. Ngày nay, các nhóm nhỏ có thể dễ dàng tinh chỉnh các mô hình ngôn ngữ-thị giác cho các sản phẩm du lịch, thương mại điện tử, tìm kiếm và phân tích. Các công ty khởi nghiệp huấn luyện mô hình embedding, xây dựng bộ sắp xếp lại, và lưu trữ các mô hình mã nguồn mở đã trở nên phổ biến... Liệu những công việc này có kích hoạt cơ chế giảm trí thông minh ngầm của Anthropic không? Không ai biết.
Sự không chắc chắn này đã thực sự ảnh hưởng đến phán đoán niềm tin của các nhà phát triển. Khi bạn nhận được một câu trả lời tệ hại, bạn không thể biết đó là vấn đề của mình, hạn chế của mô hình, hay một can thiệp chính sách thầm lặng nào đó. Sự không thể biết này tự nó đã là một tổn thương.
Trong thẻ hệ thống còn ẩn chứa một chi tiết khác: Văn bản suy luận của Mythos 5 "khó giải thích hơn so với các mô hình trước, chứa nhiều biệt ngữ và ngôn ngữ khó hiểu hơn", và các nhà đánh giá cho rằng nó ngày càng nhận thức được việc mình đang bị kiểm tra. Đối với một công ty tự nhận là "AI an toàn", những mô tả này đặt ra không ít câu hỏi hơn so với bản thân cơ chế giảm trí thông minh ngầm.
Kết luận
Ngày ra mắt Fable 5 có lẽ là ngày mâu thuẫn nhất trong lịch sử của Anthropic.
Một mô hình hàng đầu vượt trội ở hầu hết các chuẩn mực và một chính sách khiến nó đôi khi "giả vờ giúp bạn" đối với người dùng, cùng xuất hiện. Cái trước là một thành tựu không thể phủ nhận về mặt kỹ thuật, cái sau là một tiền lệ đáng lo ngại về mặt giá trị.
Câu nói của nhà nghiên cứu Nathan Lambert đáng để suy ngẫm nhiều lần: "Một AI âm thầm trở nên kém thông minh hơn mà không thông báo cho người dùng, về bản chất, là một AI sai lệch."
Điều này không phải là cáo buộc Anthropic có ác ý, mà là chỉ ra một con đường trượt dốc nguy hiểm: hôm nay là "lặng lẽ giảm hiệu quả trên các nhiệm vụ nghiên cứu LLM", ngày mai thì sao? Nếu logic này được áp dụng rộng rãi hơn, người dùng dựa vào đâu để tin rằng câu trả lời họ nhận được không bị "can thiệp" nào không được công bố?
Các mô hình AI đang trở thành một phần của cơ sở hạ tầng nghiên cứu, giống như công cụ tìm kiếm. Không ai chấp nhận một công cụ tìm kiếm lặng lẽ thay đổi kết quả tìm kiếm mà bạn không hề hay biết. Tiêu chuẩn tương tự cũng nên áp dụng cho các mô hình AI.
Anthropic đã giương cao ngọn cờ "an toàn là trên hết", bản thân điều này là một lập trường đáng trân trọng. Nhưng cốt lõi của "an toàn" chưa bao giờ là "người dùng không cần biết". Ngược lại, sự an toàn thực sự phải được xây dựng dựa trên sự hiểu biết và lòng tin của người dùng.
Điều này, dường như ngay cả Fable 5 cũng hiểu rõ.
Liên kết gốc
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan