Làm thế nào để sửa "mùi AI" bằng Hermes
Tiêu đề gốc: How To Fix AI Slop (Using Hermes)
Tác giả gốc: @EXM7777
Biên dịch: Peggy
Lời biên tập: Việc nội dung do AI tạo ra trở nên "rác rưởi" thường bị đổ lỗi cho prompt không đủ tốt, mô hình không đủ mạnh, hoặc ngữ cảnh không đầy đủ. Nhưng bài viết này đưa ra một nhận định gần gũi hơn với hệ thống kỹ thuật: vấn đề không nằm ở đầu vào, mà ở đầu ra.
Tác giả cho rằng, nhiều người đã thử đi thử lại việc viết lại prompt, nâng cấp mô hình, bật tính năng ghi nhớ, chồng chất các tệp ngữ cảnh, nhưng AI slop vẫn xuất hiện lặp đi lặp lại. Nguyên nhân là vì những phương pháp này đều tối ưu hóa bản thân "quá trình tạo sinh", mà không thiết lập một cơ chế kiểm soát chất lượng ổn định. Giống như một nhà máy sẽ không chỉ dựa vào cảm nhận của công nhân để quyết định sản phẩm có xuất xưởng hay không, đầu ra của AI cũng không nên chảy trực tiếp từ mô hình đến người dùng mà thiếu đi các bước kiểm tra, đánh giá và chặn lọc.
Giải pháp cốt lõi của bài viết là xây dựng một eval loop trong Hermes, một Agent mã nguồn mở: trước tiên xác định thế nào là "đầu ra tốt", sau đó chuyển đổi tiêu chuẩn thành hệ thống chấm điểm có thể định lượng, và liên tục kiểm tra trước khi xuất bản, trong thời gian chạy và trong môi trường sản xuất. Dù là biểu hiện rỗng tuếch trong sáng tạo nội dung, hay câu trả lời ảo giác, lỗi định dạng và suy giảm trải nghiệm trong sản phẩm, về bản chất đều là đầu ra AI chưa được đo lường đến thẳng tay người dùng.
Vì vậy, điều thực sự quan trọng không phải là viết một prompt dài hơn nữa, mà là bổ sung một lớp hệ thống chất lượng còn thiếu. Các trường hợp kiểm thử, chỉ số đánh giá, ngưỡng, kiểm tra hồi quy, nút phê duyệt và giám sát môi trường sản xuất, cùng nhau tạo nên cơ chế này. Nó biến "chất lượng đầu ra AI" từ một cảm nhận chủ quan thành một con số có thể quan sát, so sánh và sửa chữa.
Dưới đây là nội dung gốc:
Một số người dường như luôn có thể liên tục cung cấp phần mềm tốt nhất, viết nội dung xuất sắc, hoặc tạo ra những hình ảnh ấn tượng, và điều này có lý do.
Họ đã áp dụng eval loop, còn bạn thì chưa.
Bạn đã thử prompt tốt hơn, đổi mô hình đắt hơn, viết hướng dẫn dài hơn, bật tính năng ghi nhớ, và xây dựng các tệp ngữ cảnh đồ sộ như tiểu thuyết, nhưng rác AI vẫn xuất hiện hết lần này đến lần khác.
Nó xuất hiện lặp đi lặp lại vì bạn đang sửa một lớp vốn dĩ không hỏng.
Rác AI không phải là vấn đề prompt, mà là vấn đề hệ thống. Giống như một nhà máy liên tục cho ra sản phẩm lỗi, vấn đề không nằm ở một công nhân nào, mà ở cơ chế kiểm soát chất lượng: không có ai kiểm tra sản phẩm trước khi nó rời khỏi nhà máy.
Vậy nên, bài viết này sẽ xây dựng cơ chế đó. Sau khi đọc xong, bạn sẽ có một vòng lặp đánh giá (eval loop) có thể chạy trong Hermes, một tác nhân mã nguồn mở: nó sẽ chấm điểm mỗi đầu ra theo tiêu chuẩn của bạn trước khi xuất bản; tiếp tục theo dõi hiệu suất đầu ra thực tế sau khi xuất bản; và biến mỗi lần thất bại thành một bài kiểm tra mới, tự động nâng cao ngưỡng chất lượng.
Chúng ta sẽ từng bước xây dựng nó. Lợi ích cuối cùng rất cụ thể: bạn có thể có được đầu ra thực sự sạch sẽ và đáng tin cậy, không cần phải kiểm tra lại từng chữ vào nửa đêm; bạn sẽ có một điểm chất lượng có thể nhìn thấy trực quan; những nội dung rác AI sẽ bị chặn lại trước khi ra ngoài, thay vì để khán giả của bạn phát hiện.
Bạn sẽ mang về từ bài viết này những thứ sau:
Tại sao các prompt tốt hơn, mô hình lớn hơn và chức năng ghi nhớ không bao giờ có thể loại bỏ hoàn toàn nội dung rác AI; và lớp nào thực sự có tác dụng;
Nội dung rác AI ẩn náu ở hai nơi trong công việc của bạn: đầu ra nội dung và đầu ra sản phẩm; và tại sao cách sửa chữa cho cả hai lại hoàn toàn giống nhau;
Giải thích bằng ngôn ngữ đơn giản eval loop là gì: lớp chất lượng hiếm khi được vận hành hàng ngày này, và tại sao chưa bao giờ có ai nhắc bạn xây dựng nó;
Một chuẩn chất lượng có thể xây dựng trong tuần này, áp dụng cho cả nội dung và sản phẩm: cụ thể cần đo lường điều gì, và con số nào trên màn hình mới được coi là "tốt";
Một bộ các bước xây dựng hoàn chỉnh: cách sử dụng các thành phần mà Hermes đã cung cấp—skills, memory, cron và nút phê duyệt—để kết nối toàn bộ vòng lặp, giúp cổng chất lượng tự động chạy, không còn phụ thuộc vào việc bạn kiểm soát thủ công.
Nếu bạn đến vì "5 prompt giải quyết nội dung rác AI", thì bài này không phải dành cho bạn.
Những thứ đó thực sự tồn tại, nhưng chúng không thực sự hiệu quả. Bài này nói về phiên bản hiệu quả.
Bạn đã thử hầu hết mọi thứ, ngoại trừ thứ thực sự cần thử.
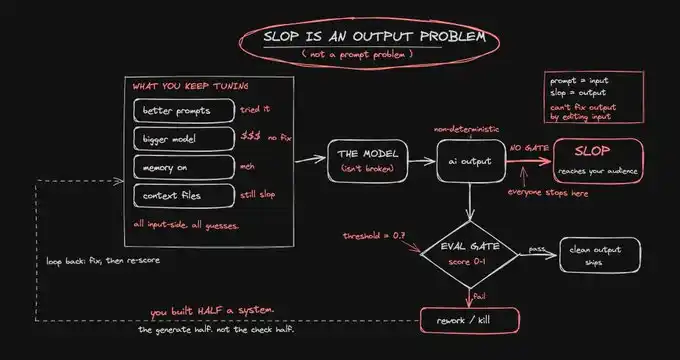
Hãy điểm qua nhanh những gì bạn đã làm: bạn đã viết lại prompt, ba lần, bốn lần; bạn đã thêm ví dụ, thêm tính cách, thêm một danh sách dài "không được làm điều này". Bạn đã nâng cấp lên mô hình tiên tiến, trả gấp 5 lần tiền cho mỗi token, nhưng đầu ra chỉ trở nên tự tin hơn, chứ không bớt rỗng tuếch đi. Bạn đã bật chức năng ghi nhớ, xây dựng tệp ngữ cảnh, cung cấp cho nó giọng điệu thương hiệu, tác phẩm quá khứ và hướng dẫn phong cách của bạn.
Mỗi thao tác trong số này sẽ mang lại cho bạn một vài kết quả tạo sinh khá tốt. Sau đó, rác AI lại từ từ quay trở lại.
Bởi vì tất cả những điều này chỉ là những bản vá ở phía đầu vào. Bạn liên tục mài giũa thứ "tạo sinh" đó, nhưng lại bỏ qua thứ thực sự có trách nhiệm "chặn lại". Một khẩu súng tốt đến đâu, nếu chỉ bắn vào bóng tối, thì cũng chẳng trúng được gì.
Rác AI là một vấn đề thuộc về phía đầu ra. Vấn đề không nằm ở việc mô hình không thể tạo ra sản phẩm tốt, mà là ở chỗ bạn không có cách nào để phân biệt đâu là sản phẩm tốt, đâu là sản phẩm tồi trước khi chúng đến tay người quan trọng.
Bạn không có vòng lặp đánh giá (eval loop), không có chuẩn mực chất lượng, không có bảng điểm. Vì vậy, bạn cứ mò mẫm điều chỉnh. Bạn sửa một prompt, cảm thấy nó có vẻ tốt hơn, nhưng cảm giác không phải là phép đo, và cảm giác cũng không thể chặn được một lần output tồi tệ ẩn giấu trong 50 lần tạo sinh tiếp theo.
Thế là bạn bắt đầu đổ lỗi cho bản thân, đổ lỗi cho prompt, đổ lỗi cho cài đặt Agent, đổ lỗi cho kỹ thuật ngữ cảnh (context engineering). Nhưng thứ thực sự thiếu là một tầng hoàn toàn mới về cách AI vận hành mà bạn chưa bao giờ được dạy. Và sau khi đọc bài viết này, tầng đó sẽ chạy trên chính máy của bạn, trong Hermes.
Tại sao prompt tốt hơn không giải quyết được vấn đề, và tại sao mọi người vẫn cứ thử
Prompt là một giả thuyết, output là kết quả, và eval là thứ duy nhất có thể kết nối cả hai thành một vòng khép kín.
Không có vòng khép kín này, bạn sẽ mãi mãi mắc kẹt trong sự phỏng đoán. Bạn điều chỉnh giả thuyết, nhìn bằng mắt thường một kết quả, rồi tuyên bố chiến thắng. Bạn sẽ không bao giờ phát hiện ra rằng, thực ra cùng một prompt đó có 30% thời gian tạo ra rác, bởi vì mỗi lần bạn chỉ nhìn vào một output trước mắt.
Các mô hình là phi tất định (non-deterministic). Chạy cùng một prompt hai lần sẽ cho ra hai câu trả lời khác nhau. Điều này có nghĩa là, ngay cả một prompt "hoàn hảo" cũng sẽ tạo ra rác AI trong một tỷ lệ nhất định các lần chạy. Và bạn không thể biết đó là lần nào trước khi khách hàng hoặc người dùng thực sự nhìn thấy nó.
Vì vậy, một prompt hoàn hảo không phải là sự đảm bảo chất lượng, nó chỉ là một lần tung đồng xu với tỷ lệ thắng cao hơn một chút. Và hiện tại bạn đang gửi trực tiếp kết quả của mỗi lần tung đồng xu đó ra ngoài.
Lý do mọi người cứ đặt hy vọng vào prompt rất đơn giản: prompt là đòn bẩy duy nhất bạn có thể nhìn thấy. Bạn có thể chỉnh sửa nó, và việc chỉnh sửa nó mang lại cho bạn cảm giác kiểm soát.
Đo lường thì vô hình. Không ai bán cho bạn một khóa học về đo lường, và cũng không ai đăng một bài viết lan truyền với tiêu đề "Bộ eval suite này đã tăng chất lượng output của tôi lên 10 lần". Kết quả là, toàn bộ cuộc thảo luận bị mắc kẹt vào cái đòn bẩy mà khi sử dụng một mình thì chẳng giải quyết được vấn đề gì.
Những người luôn có đầu ra AI sạch sẽ không phải vì họ giỏi viết prompt hơn bạn. Họ chỉ có một đòn bẩy mà bạn không có: trước khi mỗi đầu ra được công bố, họ dùng một bộ tiêu chuẩn để đo lường nó. Chính cơ chế đo lường này khiến prompt của họ trông như ma thuật.
Rác AI ẩn náu ở hai nơi
Rác AI chỉ ẩn náu ở hai nơi, và hầu như mọi người chỉ tập trung vào một trong số đó.
Nơi đầu tiên là đầu ra nội dung của bạn.
Tweet, bài viết, email, landing page, bài đăng – bất kỳ thứ gì bạn tạo ra bằng AI và công bố dưới tên mình đều thuộc loại này.
Rác AI ở đây thường trông như "đúng về mặt kỹ thuật, nhưng hoàn toàn rỗng tuếch". Nó nghe giống như mọi thứ mà các tài khoản AI trên dòng thời gian đăng: bề ngoài đúng đắn, bên trong trống rỗng.
Nó sẽ thất bại ở nơi công cộng, và bạn thậm chí không thể giải thích tại sao, vì khi bạn nhấn nút gửi, từng bài riêng lẻ trông có vẻ ổn.
Nơi thứ hai là đầu ra sản phẩm của bạn.
Tính năng AI, Agent, chatbot, trình trả lời dịch vụ khách hàng, pipeline trích xuất thông tin – bất kỳ thứ gì người dùng thực sự tiếp xúc đều thuộc loại này.
Rác AI ở đây có thể biểu hiện dưới dạng một câu trả lời sai với sự tự tin tuyệt đối, một con số ảo giác, một đầu ra JSON bị hỏng, một giọng điệu không phù hợp với thương hiệu, hoặc một đầu ra hoạt động tốt trong bản demo nhưng âm thầm suy giảm sau ba lần triển khai.
Nó sẽ không chết ngay lập tức ở nơi công cộng. Nó sẽ lan rộng trong im lặng. Mỗi người dùng đều có một trải nghiệm hơi tệ hơn, và hầu hết sẽ không bao giờ nói với bạn. Họ chỉ rời đi.
Hai thứ này là cùng một căn bệnh, và cách giải quyết cũng giống nhau.
Rác nội dung và rác sản phẩm, về bản chất, đều là đầu ra AI chưa được đo lường, không có bất kỳ cổng chất lượng nào ở giữa, và được gửi trực tiếp đến khán giả.
Sự khác biệt duy nhất là rủi ro và mức độ hiển thị. Rác nội dung sẽ khiến bạn xấu hổ ở nơi công cộng, còn rác sản phẩm sẽ âm thầm tiêu hao doanh nghiệp của bạn. Và vòng lặp mà chúng ta sẽ xây dựng trong Hermes sẽ dùng cùng một skill để chấm điểm cả hai. Như vậy, bạn có thể quản lý tất cả nội dung được tạo ra bằng một hệ thống chất lượng duy nhất, thay vì duy trì hai hệ thống cho các tình huống khác nhau.
eval loop thực sự là gì
Vòng lặp đánh giá (eval loop) là một bài kiểm tra có thể chạy lặp lại. Nó sẽ tự động đối chiếu đầu ra của AI với các tiêu chuẩn bạn đã xác định, cả trước và sau khi đầu ra được công bố, đồng thời đưa ra điểm số.
Đơn giản vậy thôi. Đó là tất cả. Và đây chính là lớp mà hầu hết những người xây dựng AI đang thiếu.
Tạo đầu ra Chấm điểm dựa trên tiêu chuẩn bạn xác định Chặn các kết quả dưới mức chuẩn Sửa các phần thất bại Chấm điểm lại, và chỉ cho phép đầu ra vượt qua bài kiểm tra bước tiếp theo
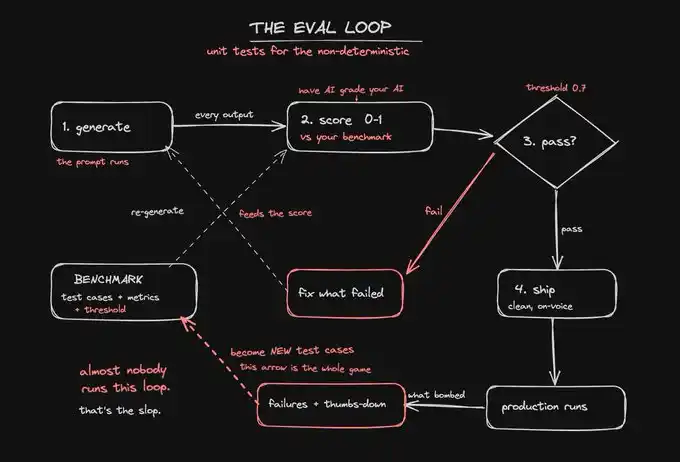
Các kỹ sư phần mềm đã có cơ chế này từ lâu, nó được gọi là kiểm thử. Bạn sẽ không bao giờ trực tiếp triển khai mã nguồn mà không kiểm thử, rồi hy vọng nó chạy ổn định trong môi trường sản xuất. Nhưng đây chính xác là cách toàn bộ ngành công nghiệp đang công bố đầu ra AI hiện nay: từ mô hình trực tiếp đến người dùng, hoàn toàn dựa vào cảm giác và hy vọng.
Hầu như không ai có vòng lặp đánh giá, nguyên nhân thực ra liên quan đến cấu trúc nhân sự. Ngày nay, nhiều người xây dựng ứng dụng bằng AI đến từ các nền tảng nội dung, bán hàng, sản phẩm, khởi nghiệp, chứ không phải kỹ thuật. Vì vậy, "viết bài kiểm tra cho đầu ra của bạn" chưa bao giờ nằm trong bộ công cụ của họ. Vòng lặp đánh giá nghe có vẻ như là cơ sở hạ tầng dành cho "kỹ sư thực thụ", và những người cần nó nhất lại thường vô thức cảm thấy mình không đủ tư cách để sử dụng nó.
Bạn có thể hiểu nó như một dạng kiểm thử đơn vị dành cho các hệ thống phi tất định. Bạn không kiểm tra xem mã có chạy được không, mà kiểm tra xem đầu ra có đủ tốt hay không. Bạn cần kiểm tra trên đủ nhiều trường hợp để đảm bảo rằng một lần tạo ra kết quả tồi tệ không dễ dàng lọt qua.
Một vòng lặp đánh giá sẽ chạy ở ba nơi. Hệ thống chúng ta sắp xây dựng sẽ đưa nó vào ba khâu này:
Trước khi công bố, dùng bộ tình huống đã lưu để kiểm tra prompt hoặc mô hình mới của bạn, xác nhận nó không trở nên tệ hơn. Đây là kiểm thử hồi quy, dùng để ngăn một thay đổi sửa được một vấn đề nhưng lại âm thầm làm hỏng ba vấn đề khác.
Trong thời gian chạy, chấm điểm trong quá trình tạo đầu ra, và để logic điều kiện chặn kết quả thất bại trước khi nó đến tay người dùng. Đây là hàng rào bảo vệ.
Trong môi trường sản xuất, liên tục lấy mẫu kết quả thực thi thực tế và chấm điểm, để bạn có thể phát hiện vấn đề ngay trong ngày chất lượng bắt đầu giảm, thay vì phải đợi một tuần sau khi khách hàng đến khiếu nại.
Loại đầu tiên, bạn thậm chí có thể dùng bảng tính để xây dựng. Nhưng nếu muốn cả ba loại kiểm thử này chạy liên tục, mà không biến nó thành công việc thứ hai của bạn, thì đây là lý do chúng ta đưa nó vào Agent.
Một khi chất lượng trở thành một con số, rác AI không còn là một cảm giác lặp đi lặp lại mà bạn phải chịu đựng, mà sẽ trở thành một lỗi có thể sửa được. Bạn không thể gỡ lỗi một cảm giác, nhưng bạn có thể gỡ lỗi một điểm số giảm từ 0,82 xuống 0,61.
Benchmark: Ba phần bạn sẽ xây dựng tiếp theo
Một benchmark có ba thành phần. Dù bạn đang đánh giá nội dung hay đánh giá sản phẩm, thì cũng chỉ có ba điều giống nhau:
Test case: Đầu vào thực tế, cùng với các mẫu đầu ra chất lượng cao tương ứng, tức ground truth của bạn. Chỉ số: Cách bạn chuyển đổi đầu ra thành điểm số, tốt nhất là điểm số từ 0 đến 1. Ngưỡng: Nội dung dưới mức này tuyệt đối không được phép xuất bản.
Xây dựng ba điều này, bạn sẽ có một cánh cổng chất lượng. Thiếu bất kỳ một trong số đó, thứ bạn có chỉ là một mong muốn. Phần tiếp theo sẽ giải thích nên đặt gì vào mỗi phần, sau đó chúng ta sẽ kết nối cả ba phần vào Hermes.
Đối với nội dung, test case của bạn chính là tiêu chuẩn vàng.
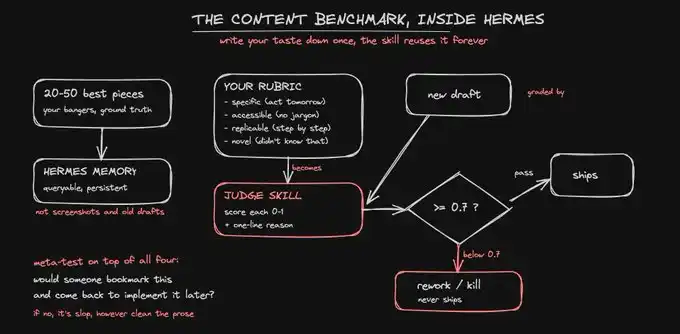
Hãy tìm ra 20 đến 50 tác phẩm tốt nhất của bạn: những nội dung thực sự hoạt động tốt, những bài viết được lưu lại, những bài viết mà bạn sẵn sàng ký tên đầy đủ. Đó là hình mẫu của "tốt". Bạn không phải đang phát minh ra một bộ tiêu chuẩn từ con số không, mà đang trích xuất những tiêu chuẩn mà bạn đã đạt được ở trạng thái tốt nhất.
Đối với nội dung, chỉ số của bạn là một thang điểm đánh giá.
Một điểm số có đáng tin cậy hay không phụ thuộc vào thang điểm đánh giá đằng sau nó. Vì vậy, bạn cần mã hóa những "tiêu chuẩn nội dung tốt" mà bạn thực sự tin tưởng. Đối với nội dung, tôi sẽ chấm điểm từng tác phẩm dựa trên bốn tiêu chí:
Nó có giải thích cách làm một việc cụ thể nào đó, thay vì chỉ mang lại một cảm giác; người đọc có thể hành động ngay vào ngày mai.
Đối tượng mục tiêu có thể hiểu được không; không có rào cản thuật ngữ, cũng không có cách diễn đạt chỉ dân trong ngành mới hiểu.
Nó có cấu trúc rõ ràng, có thể tái sử dụng, được triển khai theo từng bước, thay vì chỉ mang tính truyền cảm hứng.
Nó có đủ mới mẻ không; người đọc trước đó chưa biết rằng việc này có thể làm theo cách đó.
Tiêu chí meta bao trùm bốn tiêu chí trên là: Người đọc có lưu lại nội dung này và quay lại thực hiện theo sau đó không?
Nếu câu trả lời là không, thì dù văn bản có đọc trôi chảy đến đâu, nó vẫn là rác AI.
Điểm mấu chốt nằm ở chính thang điểm đánh giá. Một thang điểm mơ hồ, như "Nội dung này có tốt không? Có hấp dẫn không?", sẽ chỉ tạo ra những điểm số mơ hồ. Một thang điểm cụ thể, như "Nội dung này có chứa ít nhất một mẫu hoặc sổ tay hướng dẫn có thể sao chép và sử dụng trực tiếp không?", mới tạo ra những điểm số mà bạn có thể tin tưởng. Chỉ khi bạn thực sự viết ra gu thẩm mỹ của mình, judge mới có thể kế thừa gu thẩm mỹ đó.
Đối với sản phẩm, các trường hợp kiểm thử đến từ log của bạn.
Bạn cần trích xuất đầu vào thực tế mà tính năng của bạn gặp phải từ log và phiên người dùng thực, thay vì chỉ dùng ba ví dụ happy path đã kiểm tra vào ngày ra mắt. Những thứ thực sự có thể phá vỡ hệ thống thường là các trường hợp kỳ lạ, và những trường hợp kỳ lạ đó đều ẩn trong log của bạn.
Đối với sản phẩm, chỉ số phải khớp với chính tác vụ đó.
Với mỗi đầu vào, hãy xác định đầu ra như thế nào mới được coi là đúng, sau đó ghép chỉ số với loại tác vụ. Nếu chỉ có một nhãn đúng duy nhất, hãy dùng khớp chính xác; nếu cấu trúc phải hợp lệ, hãy dùng trình xác thực; nếu đầu ra là dạng mở, hãy dùng độ tương đồng ngữ nghĩa kết hợp với judge. Chỉ số chỉ cần làm một việc: trả về một con số. Bởi vì chỉ có số mới có thể đưa vào ngưỡng.
Đối với nội dung và sản phẩm, ngưỡng chính là ranh giới bạn phải giữ vững.
0.7 là một điểm khởi đầu hợp lý. Bất kỳ nội dung nào dưới 0.7 đều phải được làm lại hoặc loại bỏ trước khi phát hành, không có ngoại lệ. Ngưỡng chỉ thực sự hiệu quả khi bạn không bao giờ bỏ qua một kết quả 0.6 chỉ vì "tôi khá thích cái này". Ý nghĩa của nó là loại bỏ khỏi quyết định cái phán đoán mang tính tự phản chiếu vào lúc nửa đêm.
Đó chính là benchmark. Bây giờ, chúng ta sẽ để nó tự vận hành.
Xây dựng vòng lặp này trong Hermes
Hermes không có sẵn một nút eval, cũng không có một bảng điều khiển tên là "chất lượng" để bạn nhấp vào "bật bảo vệ khỏi nội dung rác AI".
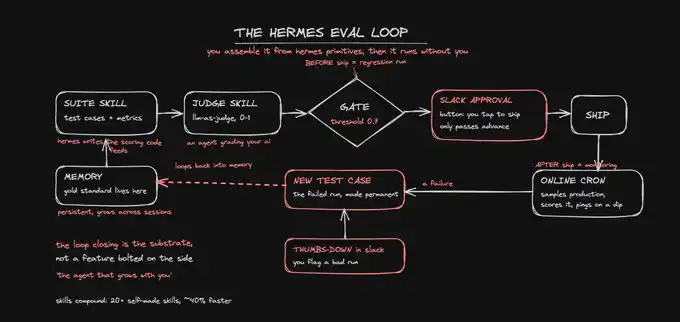
Nhưng thứ Hermes mang lại cho bạn thực ra còn tốt hơn: nó cung cấp các thành phần thô của eval loop. Bạn chỉ cần lắp ráp những khả năng cơ bản này một lần là thực sự sở hữu nó.
Các thành phần này bao gồm: các skill mà nó có thể tự viết và tái sử dụng, bộ nhớ bền vững phát triển qua các phiên, cron tích hợp sẵn, khả năng gửi đến bất kỳ nền tảng nào, nút phê duyệt trong Slack, và thói quen tự cải thiện được ghi vào cơ chế cốt lõi.
Hermes tự gọi mình là "Agent sẽ phát triển cùng bạn". Và sự phát triển này chính là vòng lặp chúng ta sắp xây dựng.
Vậy, chúng ta bắt đầu kết nối. Tổng cộng sáu bước.
Bước một, triển khai Hermes đến nơi nó có thể tiếp cận bạn.
Cài đặt Hermes và kết nối nó với Telegram. Điều này quan trọng hơn bạn nghĩ, vì cổng chất lượng chỉ thực sự hiệu quả khi nó có thể làm gián đoạn bạn. Hermes có thể chạy trên hơn 20 kênh và hỗ trợ gửi nút phê duyệt trực tiếp trên Slack và Telegram. Nghĩa là, Agent có thể hoàn thành công việc ở chế độ nền và chỉ "vỗ nhẹ vào vai bạn" khi cần bạn đưa ra quyết định.
Bước thứ hai, nạp tiêu chuẩn vàng của bạn vào bộ nhớ.
Hermes sở hữu bộ nhớ bền vững có thể phát triển qua nhiều phiên và hỗ trợ truy xuất đầy đủ giữa các phiên. Vì vậy, 20 đến 50 tác phẩm xuất sắc nhất trong benchmark của bạn chỉ cần đưa vào một lần và sẽ được lưu giữ mãi mãi.
Phần nội dung này thường bị phân tán trong các ảnh chụp màn hình, bản nháp cũ và các tệp rời rạc. Nhưng ở đây, nó sẽ trở thành bộ nhớ dài hạn của Agent, có thể truy vấn và là ground truth để đối chiếu khi chấm điểm.
Bước thứ ba, biến thang điểm của bạn thành một judge skill.
Đây là cốt lõi của toàn bộ hệ thống. Bạn chỉ cần nói với Hermes bằng ngôn ngữ tự nhiên một lần: Tạo một skill, nhận đầu ra và thang điểm của bạn, sau đó trả về điểm số từ 0 đến 1 cho từng tiêu chí, kèm theo một câu giải thích.
Đây chính là LLM-as-a-judge: để một Agent đánh giá đầu ra LLM của bạn. Kết hợp với một thang điểm rõ ràng và sắc bén, mô hình sẽ trở thành một nhà phê bình ổn định hơn bạn. Vì nó không có lòng tự trọng và cũng không tiếc khi phải xóa đi câu văn mà bạn thầm tự hào.
Lý do phải biến nó thành skill, thay vì một prompt dùng một lần, là vì skills của Hermes về bản chất là bộ nhớ thủ tục. Agent sẽ viết chúng, lưu chúng và tái sử dụng chúng nhiều lần. Bạn chỉ cần mã hóa gu thẩm mỹ của mình một lần, và nó có thể liên tục chấm điểm cho mọi đầu ra sau đó.
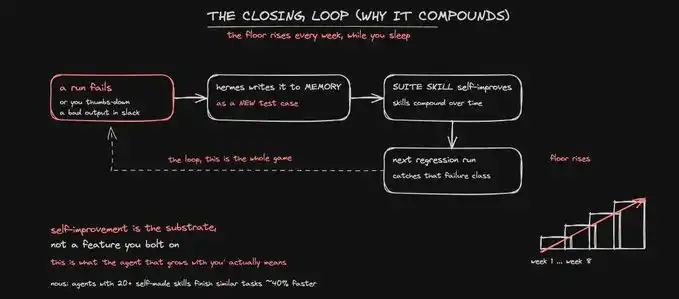
Hơn nữa, skills có tính lãi kép. Nous phát hiện rằng các Agent có hơn 20 skills tự tạo sẽ hoàn thành các tác vụ tương tự nhanh hơn 40%, vì chúng không cần phải khám phá lại quy trình nhiều lần. Judge của bạn cũng sẽ trở nên sắc bén hơn khi được chạy càng nhiều.
Bước thứ tư, biến bộ kiểm thử thành một skill, thay vì một bảng tính.
Các trường hợp kiểm thử và hàm chỉ số của bạn sẽ được kết hợp thành một skill do Hermes lưu trữ và quản lý phiên bản. Thư viện chỉ số sẽ được xác định dựa trên nhiệm vụ cụ thể: nhiệm vụ phân loại dùng khớp chính xác; nhiệm vụ trích xuất dùng biểu thức chính quy; đầu ra có cấu trúc dùng trình xác thực JSON và trình xác thực key-value; đầu ra dạng sinh dùng độ tương đồng ngữ nghĩa.
Đối với những nhiệm vụ mở, bạn sẽ sử dụng skill judge của mình. Hermes sẽ tự động viết mã chấm điểm. Bạn chỉ cần mô tả nhiệm vụ, nó sẽ xây dựng các chỉ số tương ứng. Tất cả đều được đặt ở một nơi, do Agent tự quản lý, thay vì rải rác trong một bảng tính mà bạn sớm muộn cũng không tìm thấy.
Bước năm, dùng kiểm thử hồi quy và nút phê duyệt để giữ vững cửa phát hành.
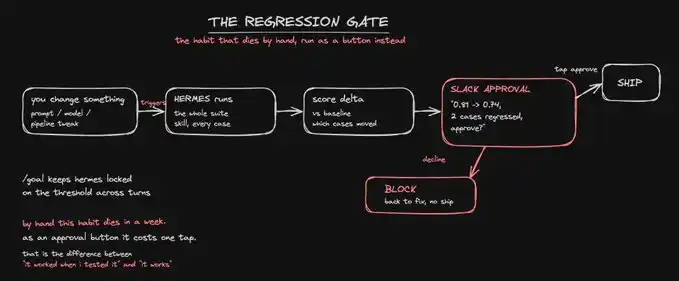
Đây là thói quen có đòn bẩy cao nhất trong toàn bộ hệ thống, cũng là thói quen mà ít ai có thể duy trì thủ công lâu dài. Vì vậy, chúng tôi giao nó cho Agent.
Sau khi kết nối quy trình, bất kỳ thay đổi nào — prompt mới, mô hình thay thế, pipeline đã điều chỉnh — đều sẽ tự động kích hoạt bộ kiểm thử. Hermes sẽ chạy lại tất cả các trường hợp, tính toán thay đổi điểm số so với baseline, và thay vì phát hành âm thầm, nó sẽ nhắc bạn trên Slack: "Điểm số giảm từ 0,81 xuống 0,74, hai trường hợp bị hồi quy, bạn có phê duyệt không?"
Chỉ khi bạn nhấn nút phê duyệt, nó mới tiếp tục tiến hành.
Bạn có thể dùng /goal để khóa nó liên tục vào nhiệm vụ này, cho phép Agent thực hiện cùng một mục tiêu xuyên suốt nhiều lượt hội thoại. Đối với các nhiệm vụ lớn hơn, bảng điều khiển đa Agent của nó còn có thể phân tách quy trình chạy, chấm điểm song song và sắp xếp thời gian thực thi.
Bằng cách này, cổng chất lượng sẽ trở thành một quy trình thường trực, thay vì một việc bạn phải nhớ làm thủ công.
Bước sáu, dùng cron để giám sát môi trường sản xuất và hoàn thiện vòng lặp.
Hermes có cron tích hợp sẵn, có thể gửi kết quả đến bất kỳ nền tảng nào. Do đó, bạn có thể thiết lập một tác vụ định kỳ, lấy mẫu kết quả thực thi thực tế, dùng cùng skill judge để chấm điểm chúng, và ngay khi điểm số giảm xuống dưới ngưỡng tiêu chuẩn, nó sẽ nhắn tin riêng cho bạn.
Bằng cách này, bạn có thể phát hiện vấn đề ngay trong ngày chất lượng bắt đầu giảm, thay vì phải đợi một tuần sau khi khách hàng đến phàn nàn.
"Điểm eval giảm" là một vấn đề bạn có thể xử lý ngay lập tức; "Một khách hàng nào đó có vẻ không hài lòng" thì không.
Tiếp theo là phần quan trọng giúp toàn bộ hệ thống bắt đầu tăng trưởng kép.
Khi bạn nhấn thumbs-down cho một đầu ra tệ nào đó trong Slack, Hermes sẽ ghi nó trở lại bộ kiểm thử skill như một trường hợp kiểm thử mới. Lần chạy thất bại đó sẽ trở thành một mục kiểm tra vĩnh viễn.
Và vì tự cải thiện là cơ chế cốt lõi của Hermes, chứ không phải một tính năng gắn thêm sau này, bộ kiểm thử này sẽ tự động trở nên mạnh mẽ hơn mỗi tuần.
Trong khi bạn ngủ, ngưỡng chất lượng vẫn tiếp tục được nâng lên.
Khi hệ thống này thực sự chạy, trạng thái tốt sẽ rất cụ thể: một nội dung nếu dưới 0,7 trong thang điểm đánh giá của bạn sẽ không bao giờ được xuất bản. Một thay đổi sản phẩm nếu làm giảm bất kỳ chỉ số nào dưới mức cơ sở sẽ chặn việc triển khai cho đến khi bạn tự phê duyệt.
Và điểm số trong môi trường sản xuất sẽ giữ ổn định hoặc liên tục tăng. Ngày nó bắt đầu giảm là ngày Hermes cảnh báo bạn, chứ không phải đợi đến một tuần sau khi dữ liệu mất người dùng mới hiện ra.
Phần không ai muốn nghe
Đầu ra AI của bạn không ổn định, không phải vì bạn không biết viết prompt, cũng không phải vì mô hình chưa đủ thông minh.
Mà là vì bạn chỉ chạy bước tạo sinh, mà không chạy bước chất lượng. Bạn đã xây dựng một nửa hệ thống, nhưng lại đổ lỗi cho nửa thực sự hoạt động.
Cách sửa không phải là đổi một prompt tốt hơn, mà là bổ sung lớp còn thiếu.
Định nghĩa thế nào là tốt, biến nó thành một con số, dùng con số đó đánh giá mọi đầu ra, chặn tất cả kết quả dưới ngưỡng, và hoàn thiện vòng lặp để ngưỡng chất lượng tự động tăng lên mỗi tuần.
Giờ đây, lớp này không còn là một dự án "để sau", mà là một hệ thống có thể chạy trên máy của bạn, thông qua một Agent, với sáu bước.
Sau khi làm được điều này, rác AI không còn là thứ ngẫu nhiên xảy ra với bạn, mà sẽ trở thành thứ bạn có thể chặn lại trước khi nó ra ngoài. Giống như một nhà máy thực thụ, chặn sản phẩm lỗi trước khi chúng đến tay khách hàng.
Prompt chưa bao giờ là hệ thống.
Eval loop mới là hệ thống. Hermes là nơi nó chạy.
Bây giờ, bạn đã có nó rồi.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan