黃仁勛最新播客:NVIDIA 的护城河能否持续?
Tiêu đề video: Jensen Huang: - Có bền vững vũng nước của Nvidia không?
Tác giả video: Dwarkesh Patel
Dịch thuật: Peggy, BlockBeats
Chú thích biên tập: Khi bên ngoài vẫn đang thảo luận về việc "Vũng nước của Nvidia có đến từ chuỗi cung ứng" hay không, cuộc trò chuyện này cho rằng, điều thực sự khó sao chép không phải là vi mạch chính nó, mà là khả năng hệ thống toàn diện chuyển đổi "điện tử thành Token" - tức là khả năng hợp tác giữa kiến trúc tính toán, hệ thống phần mềm và sinh thái phát triển viên.
Bài viết này được dịch từ cuộc trò chuyện giữa Dwarkesh Patel và Jensen Huang. Dwarkesh Patel là một trong những người dẫn chương trình podcast công nghệ được chú ý nhất ở thung lũng Silicon hiện nay, điều hành kênh YouTube Dwarkesh Podcast, chuyên về phỏng vấn sâu rộng, thảo luận lâu dài với các nhà nghiên cứu trí tuệ nhân tạo và nhân vật lõi của ngành công nghệ.
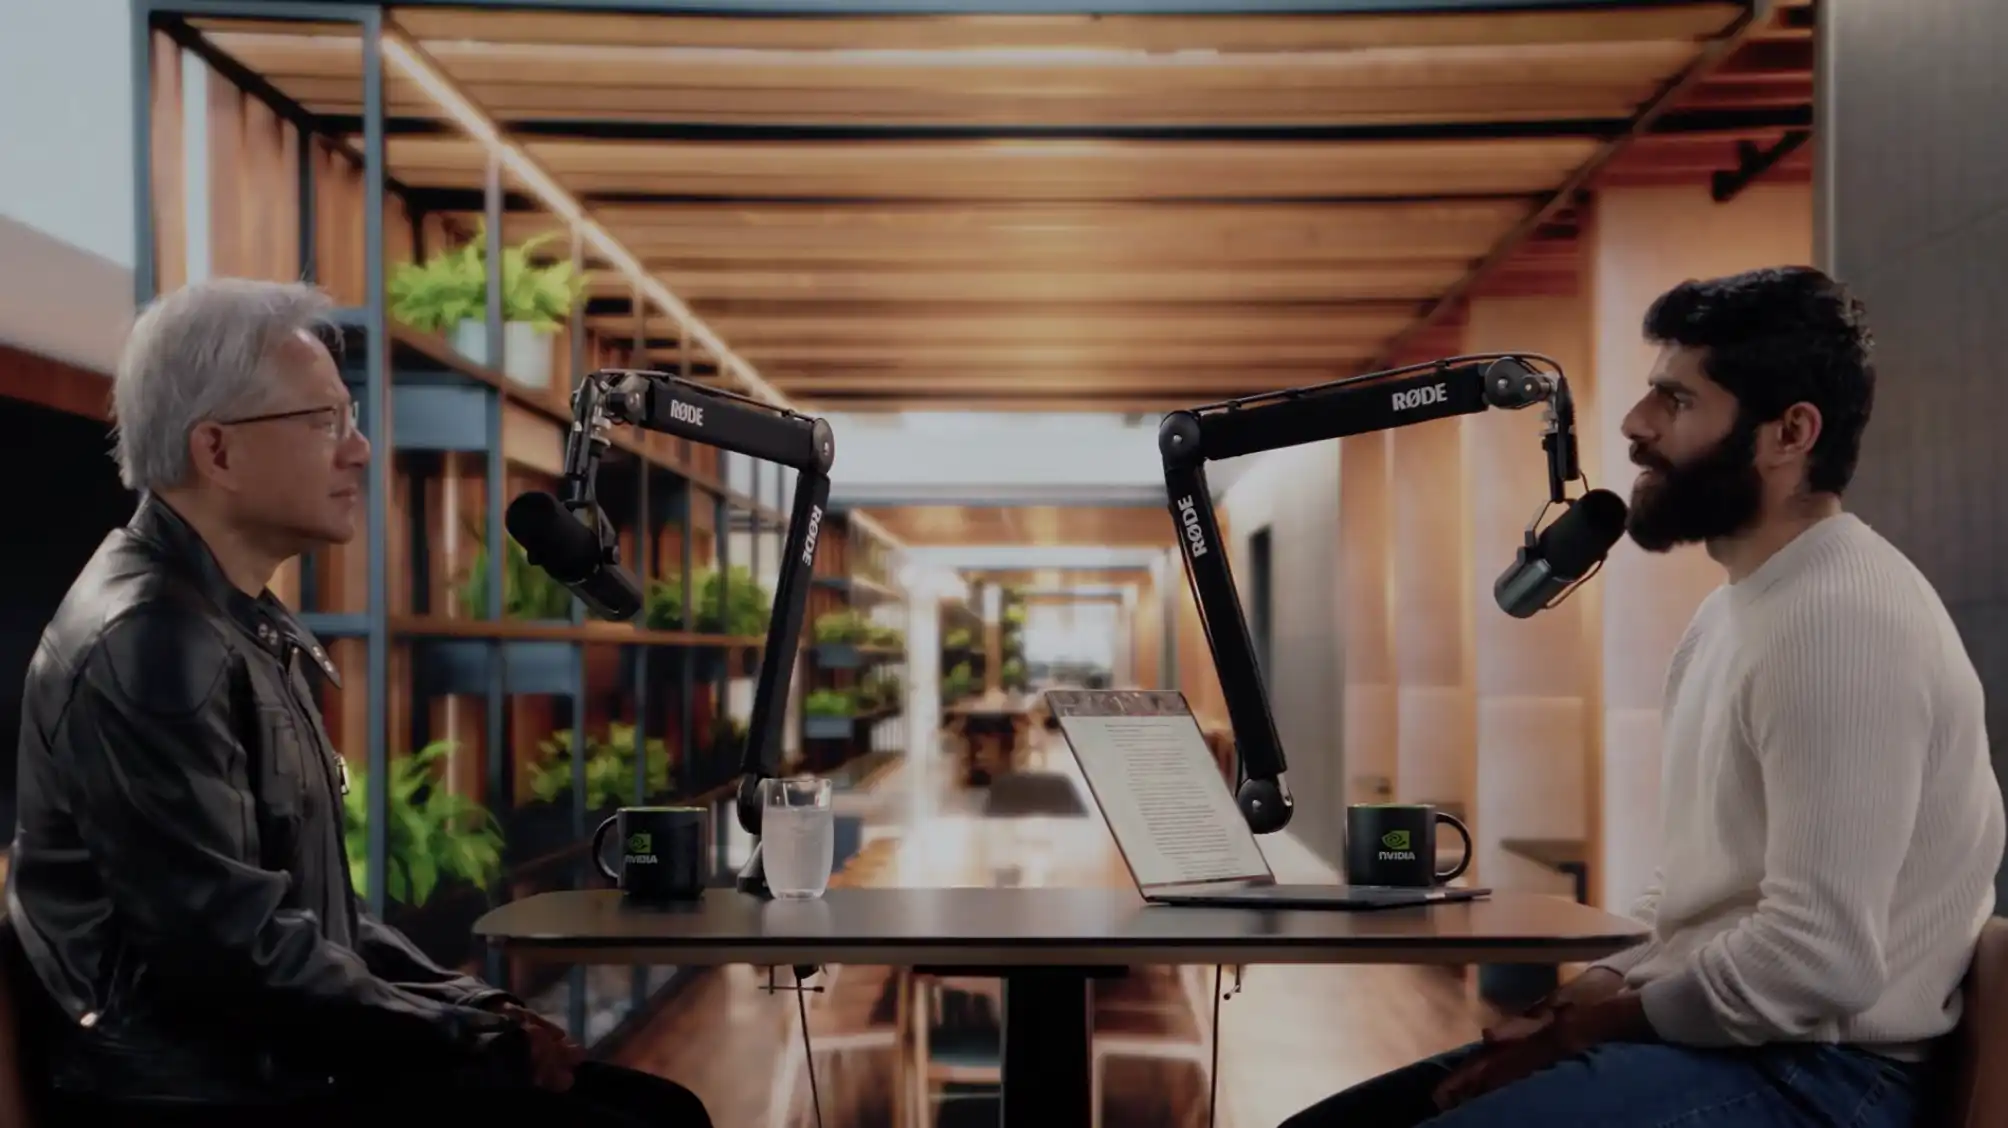
Bên phải là Dwarkesh Patel, bên trái là Jensen Huang
Xoay quanh điều này, cuộc trò chuyện này có thể được hiểu từ ba khía cạnh.
Thứ nhất, là sự thay đổi về công nghệ và cấu trúc ngành.
Ưu điểm của Nvidia không chỉ đến từ hiệu suất phần cứng, mà còn từ sinh thái phát triển viên mà CUDA mang lại, cùng với sự phụ thuộc vào đường dẫn xung quanh ngăn xếp tính toán đã hình thành. Trong hệ thống này, khả năng tính toán không còn là biến số duy nhất, các thuật toán, kỹ thuật hệ thống, mạng lưới và hiệu suất năng lượng cùng nhau quyết định tốc độ tiến triển của trí tuệ nhân tạo. Điều này cũng mở ra một nhận định quan trọng: phần mềm sẽ không bị "công cụ hóa" một cách đơn giản với AI, ngược lại, với sự phổ biến của Agent, việc gọi công cụ sẽ tăng một cách mũi nhọn, và giá trị của phần mềm sẽ được phóng to thêm.
Thứ hai, là ranh giới kinh doanh và lựa chọn chiến lược.
Đối diện với chuỗi cung ứng trí tuệ nhân tạo ngày càng mở rộng, Nvidia chọn "làm mọi thứ cần thiết, nhưng không làm tất cả". Họ không bước vào tính toán đám mây, cũng không thực hiện tích hợp dọc quá mức, mà thay vào đó thông qua đầu tư và hỗ trợ sinh thái để phát triển quy mô toàn cầu. Sự kiềm chế này giúp họ vừa giữ quyền kiểm soát chủ chốt, vừa tránh trở thành người thay thế trong sinh thái, từ đó đưa thêm nhiều bên tham gia vào hệ thống công nghệ của mình.
Thứ ba, là về sự khác biệt về sự lan truyền công nghệ và cấu trúc ngành.
Phần đầy căng thẳng nhất của cuộc trò chuyện không nằm ở kết luận cụ thể, mà nằm ở cách hiểu "rủi ro" chính bản thân. Một quan điểm nhấn mạnh vào ưu thế về tính toán dẫn đầu, trong khi quan điểm khác tập trung hơn vào quá trình lan truyền công nghệ với sự thuộc về lâu dài của sinh thái và tiêu chuẩn. So với sự chênh lệch năng lực ngắn hạn, vấn đề quan trọng hơn có lẽ là: tương lai của mô hình trí tuệ nhân tạo và các nhà phát triển sẽ hoạt động trên hệ thống công nghệ nào.
Nói cách khác, màn kết thúc của cuộc đua này không chỉ là "ai tạo ra mô hình mạnh mẽ hơn trước", mà còn là "ai định nghĩa cơ sở hạ tầng cho việc chạy mô hình".
Ở ý nghĩa này, vai trò của NVIDIA không chỉ còn là một công ty chip, mà gần giống như một "nhà cung cấp hệ điều hành cơ bản cho thời đại AI" — họ đang cố gắng đảm bảo rằng, dù khả năng tính toán được mở rộng như thế nào, con đường tạo ra giá trị vẫn xoay quanh chính họ.
Dưới đây là nội dung gốc (đã được sắp xếp lại để dễ đọc và hiểu):
TL;DR
· Hẻm núi của NVIDIA không nằm ở "chip" mà ở "bộ năng lực toàn diện từ điện tử đến Token". Cốt lõi không phải là hiệu suất phần cứng, mà là khả năng chuyển đổi tính toán thành giá trị của toàn bộ ngăn xếp (kiến trúc + phần mềm + sinh thái).
· Ưu thế cơ bản của CUDA không phải là công cụ, mà là sinh thái phát triển AI lớn nhất thế giới. Nhà phát triển, framework, mô hình đều ràng buộc trong cùng một bộ công nghệ, tạo thành một sự phụ thuộc vào con đường khó thay thế.
· Khóa cuộc chiến AI không chỉ nằm ở sức mạnh tính toán mà còn ở sự kết hợp của "ngăn xếp tính toán × thuật toán × kỹ thuật hệ thống". Cải tiến do kiến trúc, mạng lưới, hiệu quả năng lượng, sự cộng tác phần mềm mang lại vượt xa so với sự tiến bộ đơn thuần trong quy trình sản xuất.
· Chướng ngại về sức mạnh tính toán chỉ là vấn đề ngắn hạn, cung cấp sẽ được bổ sung dựa trên tín hiệu cầu hỏi trong 2–3 năm tới. Rào cản lâu dài thực sự không phải là chip mà là năng lượng và cơ sở hạ tầng.
· Phần mềm AI sẽ không được hàng hóa hóa, mà sẽ tăng trưởng mạnh mẽ về việc sử dụng công cụ do sự bùng nổ của Agent. Tương lai không phải là phần mềm rẻ tiền, mà là số lần gọi phần mềm tăng đột biến.
· Không làm điện toán đám mây là chiến lược cốt lõi của NVIDIA: làm "mọi thứ cần thiết", nhưng không phủ đầy chuỗi giá trị. Thông qua đầu tư và hỗ trợ sinh thái, không phải là tích hợp dọc mà là làm lớn tổng thể thị trường.
· Rủi ro chiến lược thực sự không phải là đối thủ có sức mạnh tính toán mà là sinh thái AI toàn cầu không còn dựa trên ngăn xếp công nghệ của Mỹ. Khi mô hình và nhà phát triển chuyển đổi, tiêu chuẩn công nghệ dài hạn và quyền lực của ngành sẽ chuyển giao theo đuổi.
Nội dung Phỏng Vấn
Hẻm núi của NVIDIA ở đâu: Chuỗi cung ứng, hay quyền kiểm soát từ "điện tử đến Token"?
Dwarkesh Patel (Người dẫn chương trình):
Chúng ta đã thấy, giá trị của nhiều công ty phần mềm giảm đi vì mọi người dự đoán AI sẽ biến phần mềm thành một mặt hàng tiêu chuẩn. Còn một cách hiểu có vẻ hơi ngây thơ, đó là: bạn nhìn, từ tệp thiết kế (GDS2) được chuyển giao cho TSMC, TSMC chịu trách nhiệm sản xuất chip logic, wafer, xây dựng mạch công tắc, sau đó ghép bộ nhớ HBM của SK Hynix, Micron, Samsung mà sản xuất vào, cuối cùng gửi đến ODM để lắp ráp thành khung máy hoàn chỉnh."
Chú Ý: HBM (High Bandwidth Memory, Bộ Nhớ Băng Thông Cao) là một loại công nghệ bộ nhớ tiên tiến được thiết kế đặc biệt cho tính toán hiệu năng cao và trí tuệ nhân tạo; ODM (Original Design Manufacturer, Nhà Sản Xuất Thiết Kế Gốc) đề cập đến các nhà sản xuất gốc không chỉ chịu trách nhiệm sản xuất mà còn chịu trách nhiệm thiết kế sản phẩm.
Do đó, từ góc độ này, Nvidia bản chất là đang thực hiện phần mềm, trong khi việc sản xuất được thực hiện bởi người khác. Nếu phần mềm được hóa thương mại, Nvidia cũng sẽ được hóa thương mại.
Jensen Huang (CEO Nvidia):
Nhưng cuối cùng, phải có một quá trình chuyển đổi điện tử thành mã thông tin. Từ điện tử thành mã thông tin, và làm cho những mã thông tin này trở nên có giá trị hơn theo thời gian, tôi nghĩ rằng quá trình chuyển đổi này rất khó có thể được hóa thương mại hoàn toàn.
Quá trình chuyển đổi từ điện tử thành mã thông tin, chính nó đã là một quá trình rất phi thường. Và làm cho một mã thông tin trở nên có giá trị hơn, giống như làm cho một phân tử có giá trị hơn một phân tử khác, đó là làm cho một mã thông tin có giá trị hơn một mã thông tin khác.
Trong quá trình này, bao gồm rất nhiều nghệ thuật, kỹ thuật, khoa học và sáng chế, mới khiến cho mã thông tin này có giá trị.
Rõ ràng, chúng ta đang theo dõi mọi thứ diễn ra trong thời gian thực. Vì vậy, quá trình chuyển đổi này, quá trình sản xuất, và tất cả các tín hiệu liên quan, thực ra vẫn chưa được hiểu rõ hoàn toàn, chặng đường này cũng chưa kết thúc. Vì vậy, tôi không nghĩ những tình huống đó sẽ xảy ra.
Tất nhiên, chúng tôi sẽ làm cho nó trở nên hiệu quả hơn. Trên thực tế, cách bạn vừa mô tả vấn đề, đó thực sự là một mô hình tư duy của tôi về Nvidia: đầu vào là điện tử, đầu ra là mã thông tin, và phần ở giữa đó chính là Nvidia.
Công việc của chúng tôi là "làm ít nhất có thể những việc cần thiết, đồng thời làm ít nhất có thể những việc không cần thiết", để thực hiện quá trình chuyển đổi này và làm cho nó có khả năng cực kỳ cao.
Khi tôi nói về "làm ít nhất có thể", đó có nghĩa là mọi thứ chúng tôi không cần phải tự làm, chúng tôi sẽ hợp tác với người khác và đưa nó vào hệ sinh thái của chúng tôi. Nếu bạn nhìn vào Nvidia ngày nay, chúng tôi có thể sở hữu một trong những hệ sinh thái hợp tác lớn nhất ở cả chuỗi cung ứng nguồn gốc và chuỗi cung ứng hậu cần. Từ nhà sản xuất máy tính, nhà phát triển ứng dụng, đến nhà phát triển mô hình - bạn có thể xem trí tuệ nhân tạo như một "Chiếc bánh gato năm lớp". Và chúng tôi đã có bố trí hệ sinh thái trên năm tầng này.
Đọc thêm: "Bài viết mới nhất của Jensen Huang Nvidia: "Chiếc bánh gato" của Trí Tuệ Nhân Tạo"
Vì vậy, chúng tôi cố gắng làm ít nhất có thể, nhưng phần công việc chúng ta phải làm thực sự rất khó khăn. Và tôi không nghĩ phần đó sẽ bị thương mại hóa.
Trên thực tế, tôi cũng không nghĩ rằng các công ty phần mềm doanh nghiệp cốt lõi đang làm "sản xuất công cụ" theo bản chất. Tuy nhiên, sự thật là, ngày nay đa số các công ty phần mềm đều là nhà cung cấp công cụ.
Đương nhiên có ngoại lệ, một số đang thực sự mã hóa và cố định hệ thống làm luồng công việc, nhưng nhiều công ty đều là công ty công cụ theo bản chất.
Ví dụ như Excel là công cụ, PowerPoint là công cụ, Cadence làm công cụ, Synopsys cũng là công cụ.
Jensen Huang:
Và theo tôi, xu hướng tôi nhìn thấy, hoàn toàn đối lập với nhiều người khác. Tôi tin rằng số lượng agent sẽ tăng theo cấp số mũ, cũng như số người sử dụng công cụ.
Số lượng trường hợp gọi các công cụ khác nhau rất có thể sẽ tăng mạnh. Chẳng hạn như số lần sử dụng của Synopsys Design Compiler, rất có thể sẽ tăng đáng kể.
Sẽ có rất nhiều agent sử dụng floor planner, công cụ layout, công cụ kiểm tra quy tắc thiết kế.
Ngày nay, chúng ta bị hạn chế bởi số lượng kỹ sư; và vào ngày mai, những kỹ sư này sẽ được hỗ trợ bởi rất nhiều agent, chúng ta sẽ khám phá không gian thiết kế một cách chưa từng có. Khi bạn bắt đầu sử dụng các công cụ ngày nay, sự thay đổi này sẽ rất rõ rệt.
Việc sử dụng công cụ sẽ thúc đẩy các công ty phần mềm này đạt được tăng trưởng bùng nổ. Nguyên nhân mà tình hình này chưa xảy ra là vì hiện tại các agent vẫn chưa giỏi sử dụng công cụ đủ tốt.
Vì vậy, hoặc các công ty này tự mình xây dựng những agent, hoặc agent chính nó trở nên đủ mạnh mẽ để có thể sử dụng các công cụ này. Tôi tin rằng cuối cùng sẽ là sự kết hợp của cả hai.
Dwarkesh Patel:
Tôi nhớ trong bài phát biểu mới nhất của anh, anh đã cam kết mua gần 100 tỷ USD cho các thành phần biên, bộ nhớ, và đóng gói. Và báo cáo của SemiAnalysis nói rằng con số này có thể lên đến 250 tỷ USD.
Một cách hiểu khác là, pháo đài của NVIDIA nằm ở chỗ anh đã khóa chặt cung cấp cho những thành phần khan hiếm này trong nhiều năm tương lai. Nghĩa là, người khác có thể tạo ra bộ xử lý nhanh hơn, nhưng họ có thể có đủ bộ nhớ không? Hoặc đủ chip logic không?
Điều này có phải là ưu điểm cốt lõi của NVIDIA trong vài năm tới?
Jensen Huang:
Đây là điều chúng tôi có thể làm được, nhưng người khác rất khó để làm được. Lý do chúng tôi có thể cam kết mạnh mẽ ở phía trên dòng là một phần rõ ràng, cũng chính là những cam kết mua hàng mà bạn đã đề cập; một phần khác là ẩn dụ.
Ví dụ, rất nhiều đầu tư ở đầu nguồn thực tế là do đối tác chuỗi cung ứng của chúng tôi thực hiện, vì tôi sẽ nói với CEO của họ: Để tôi cho bạn biết ngành này sẽ lớn đến đâu, để tôi giải thích tại sao như vậy, để tôi cùng bạn suy luận, để tôi cho bạn biết những gì tôi đã nhìn thấy.
Thậm chí họ mới sẵn lòng đầu tư sau khi tôi đã đồng lòng với CEO của nhiều ngành công nghiệp đầu nguồn khác nhau, họ mới sẵn lòng thực hiện những khoản đầu tư này.
Vậy tại sao họ sẵn lòng đầu tư cho tôi, chứ không phải cho người khác? Vì họ biết, tôi có khả năng mua sạch sản lượng của họ và thông qua đối tác hậu cần để tiêu thụ nó. Chính là do nhu cầu hậu cần và quy mô chuỗi cung ứng lớn của NVIDIA đến như vậy, họ mới sẵn lòng đầu tư ở đầu nguồn.
Bạn hãy nhìn vào GTC, quy mô của hội nghị khiến nhiều người cảm thấy kinh ngạc. Nó về cơ bản là một Vũ trụ AI 360 độ, tập hợp cả ngành công nghiệp. Mọi người tập trung lại vì họ cần phải thấy nhau. Tôi đưa họ lại gần nhau, để đầu nguồn nhìn thấy hậu cần, hậu cần nhìn thấy đầu nguồn, đồng thời làm cho tất cả mọi người thấy sự tiến bộ của AI.
Quan trọng hơn, họ có thể tiếp xúc với các công ty gốc AI và các doanh nghiệp khởi nghiệp, thấy trực tiếp những đổi mới đang diễn ra, từ đó xác minh trực tiếp những nhận định mà tôi đã đưa ra.
Cho nên tôi đã dành rất nhiều thời gian, trực tiếp hoặc gián tiếp giải thích cơ hội hiện tại cho đối tác chuỗi cung ứng và sinh thái của chúng tôi. Rất nhiều người đã nói, bài diễn thuyết (keynote) của tôi không giống như một buổi ra mắt sản phẩm truyền thống, mà có một phần nghe có vẻ như đang "dạy học". Và sự thật là đó chính là mục đích của tôi.
Tôi cần đảm bảo toàn bộ chuỗi cung ứng — cả ở đầu nguồn lẫn hậu cần — đều hiểu rõ: Điều gì sẽ diễn ra tiếp theo, tại sao nó sẽ diễn ra, khi nào nó sẽ diễn ra, quy mô nó sẽ như thế nào, và có thể hệ thống hóa điều này một cách hệ thống như tôi.
Vì vậy, cái "hào phóng" mà bạn vừa nói đúng là tồn tại. Nếu thị trường này đạt mức tỷ đô trong vài năm tới, chúng tôi có khả năng xây dựng chuỗi cung ứng hỗ trợ nó. Giống như luồng tiền mặt, chuỗi cung ứng cũng có luồng và tuần hoàn. Nếu một doanh nghiệp thiết kế chuỗi cung ứng của mình không tuần hoàn đủ nhanh, không ai sẽ xây dựng chuỗi cung ứng cho nó. Chúng tôi có thể duy trì quy mô như vậy là vì nhu cầu hậu cần rất mạnh mẽ, và mọi người đều có thể nhìn thấy điều này.
Chính điều này giúp chúng tôi có thể làm những điều như hiện tại với quy mô như vậy.
Dwarkesh Patel
Tôi muốn hiểu rõ hơn về việc, liệu đầu nguồn có thể theo kịp không. Trong nhiều năm qua, doanh thu của bạn cơ bản đã tăng gấp đôi từng năm, quy mô sức mạnh toàn cầu cung cấp thậm chí còn tăng ba lần.
Jensen Huang:
Và và tiếp tục tăng gấp đôi dưới quy mô này.
Dwarkesh Patel
Đúng. Vì vậy nếu bạn nhìn vào chip logic, ví dụ như bạn là một trong những khách hàng lớn nhất trên quy trình sản xuất N3 của TSMC, và cũng là một trong những khách hàng chính trên N2.
Theo một số phân tích, AI có thể chiếm đến 60% năng lực sản xuất trên N3 trong năm nay, và có thể lên đến 86% vào năm sau.
Lưu ý: N3 chỉ quy trình 3 nanômét (3nm) của TSMC, có thể hiểu là một trong những công nghệ sản xuất chip tiên tiến nhất hiện tại của TSMC
Vậy trong bối cảnh bạn đã chiếm tỷ lệ lớn như vậy, bạn làm thế nào để tiếp tục tăng gấp đôi? Và thậm chí là tăng gấp đôi hàng năm? Liệu chúng ta có phải đối mặt với một giai đoạn mà sức mạnh tính toán của AI phải giảm tốc do hạn chế ở phía trên không thể vượt qua? Có cách nào để né tránh những hạn chế này không? Chúng ta phải làm thế nào để mỗi năm mở ra hai nhà máy xử lý tia?
Jensen Huang:
Đôi khi, nhu cầu tạm thời thực sự vượt quá cung cấp của toàn bộ ngành công nghiệp, cả ở phía trên lẫn phía dưới. Và trong một số trường hợp, chúng tôi thậm chí bị giới hạn bởi số lượng thợ sửa ống nước - đó là sự thật đã xảy ra.
Dwarkesh Patel:
Vậy GTC năm sau nên mời cả thợ sửa ống nước.
Jensen Huang:
Đúng, thực sự đây là một hiện tượng tốt. Bạn muốn ở trong một thị trường như vậy: nhu cầu tạm thời lớn hơn tổng cung của toàn ngành. Ngược lại điều đó dĩ nhiên không tốt.
Nếu khoảng cách giữa hai yếu tố này quá lớn, một phần tử cụ thể, một thành phần cụ thể trở thành rõ ràng là chướng ngại, toàn bộ ngành công nghiệp sẽ nỗ lực giải quyết vấn đề đó. Ví dụ, tôi đã nhận ra hiện nay mọi người đã không còn nói về CoWoS nhiều nữa. Lý do là trong hai năm vừa qua, chúng tôi đã đầu tư và mở rộng nó một cách lớn lao, tăng mức độ lên đến nhiều lần.
Bây giờ tôi nghĩ rằng tổng thể hiện đang ở trạng thái tương đối tốt. TSMC cũng đã nhận ra rằng cung cấp của CoWoS phải theo kịp nhu cầu của chip logic và bộ nhớ. Vì vậy họ đang mở rộng CoWoS, đồng thời mở rộng công nghệ đóng gói tiên tiến trong tương lai, và theo đúng nhịp điệu như mở rộng chip logic.
Điều này rất quan trọng, vì trong quá khứ, CoWoS và bộ nhớ HBM đều giống như một "khả năng đặc biệt," nhưng bây giờ không còn nữa. Bây giờ mọi người đã nhận ra rằng chúng là một phần của công nghệ tính toán chính thống.
Đồng thời, bây giờ chúng tôi có khả năng ảnh hưởng đến chuỗi cung ứng rộng lớn hơn. Trong quá khứ, khi cuộc cách mạng AI mới chỉ mới bắt đầu, những nhận định mà tôi đang nói bây giờ, thực ra đã được nói từ năm năm trước.
Một số người đã tin tưởng và đầu tư vào đó, ví dụ như nhóm Sanjay của Micron. Tôi vẫn nhớ rõ cuộc họp đó đến ngày hôm nay, khi đó tôi đã phác thảo rõ ràng về tương lai sẽ diễn ra như thế nào, tại sao sẽ diễn ra, và dự đoán về các kết quả ngày hôm nay. Khi đó, họ đã chọn cách gia tăng vốn đáng kể, chúng tôi cũng đã thiết lập mối quan hệ đối tác với họ. Trong nhiều lĩnh vực như LPDDR, HBM, họ đã đầu tư, và có vẻ như đã đạt được lợi ích lớn từ việc đó. Cũng có một số công ty tham gia sau này, nhưng hiện nay mọi người đều đã bước vào giai đoạn này.
Vì vậy, tôi cho rằng, mỗi thế hệ công nghệ, mỗi tình thế khó khăn, đều sẽ nhận được sự chú ý lớn. Và bây giờ, chúng ta đã 'dự trữ trước' các tình thế khó khăn vài năm. Ví dụ, chúng tôi đã hợp tác với Lumentum, Coherent, và toàn bộ hệ sinh thái silicon photonics. Trong những năm qua, chúng tôi thực sự đã tái tạo lại toàn bộ hệ sinh thái và chuỗi cung ứng.
Liên quan đến silicon photonics, chúng tôi đã thiết lập một chuỗi cung ứng đầy đủ xung quanh TSMC, hợp tác với họ để phát triển công nghệ, phát minh ra nhiều công nghệ mới, và cấp bằng sáng chế cho chuỗi cung ứng, duy trì tính mở của hệ sinh thái. Chúng tôi thông qua việc phát minh công nghệ mới, quy trình làm việc mới, thiết bị kiểm tra mới (bao gồm cả cảm biến kép), đầu tư vào các công ty liên quan, hỗ trợ mở rộng sản xuất cho họ, để chuẩn bị cho chuỗi cung ứng.
Vì vậy, bạn có thể thấy, chúng tôi đang tích cực định hình hệ sinh thái này, để chuỗi cung ứng có thể hỗ trợ quy mô tương lai.
Dwarkesh Patel:
Dường như có một số hạn chế dễ dàng giải quyết hơn những hạn chế khác. Ví dụ, so với việc mở rộng CoWoS, có những khía cạnh khó khăn hơn
Jensen Huang:
Thực sự thì tôi vừa nêu một ví dụ khó nhất.
Dwarkesh Patel:
Vấn đề là gì?
Jensen Huang:
Thợ sửa ống nước. Ừ, thật đấy. Tôi vừa nói về trường hợp khó nhất đó - thợ sửa ống nước và thợ điện. Lý do là, điều này khiến tôi hơi lo lắng về một số "người tiên tri ngày tận thế", họ luôn nói về việc công việc sẽ biến mất, vị trí sẽ bị thay thế. Nếu chúng ta cố khuyến khích mọi người không nên trở thành kỹ sư phần mềm vì điều đó, thì tương lai thật sự sẽ thiếu kỹ sư phần mềm.
Dự đoán tương tự đã xuất hiện cách đây 10 năm. Khi đó, có người nói: "Dù bạn làm gì đi nữa, đừng bao giờ trở thành bác sĩ chuyên khoa hình ảnh." Bạn vẫn có thể tìm thấy những video trực tuyến đó ngày nay, nói rằng chuyên khoa hình ảnh sẽ là ngành nghề đầu tiên bị loại bỏ, thế giới sẽ không còn cần bác sĩ chuyên khoa hình ảnh nữa. Nhưng sự thật là, ngày nay chúng ta lại thiếu bác sĩ chuyên khoa hình ảnh.
Dwarkesh Patel:
Được, quay lại vấn đề ban đầu: một số mắt xích có thể mở rộng, một số thì không. Vậy cụ thể, làm thế nào để gấp đôi khả năng sản xuất của vi mạch logic? Sau cùng, rõ ràng rằng mức độ đóng băng thực sự nằm ở đây, bộ nhớ và logic đều là yếu tố hạn chế. Vậy máy chiếu EUV thì sao? Làm sao mỗi năm bạn có thể gấp đôi số lượng máy chiếu đó?
Jensen Huang:
Những điều này không phải là không thể thực hiện. Thực tế, việc mở rộng sản xuất nhanh chóng không dễ dàng, nhưng thực hiện những điều này trong vòng hai đến ba năm không phải là khó khăn. Điều quan trọng là phải có tín hiệu yêu cầu rõ ràng. Một khi bạn có thể sản xuất ra một chiếc, bạn có thể sản xuất ra mười chiếc; một khi có thể sản xuất ra mười chiếc, bạn có thể sản xuất ra một triệu chiếc. Vì vậy, những thứ này về bản chất không phải là khó sao chép.
Dwarkesh Patel:
Vậy bạn sẽ truyền đạt quyết định này vào chuỗi cung ứng tới đâu? Ví dụ, liệu bạn có sẽ tiếp cận ASML và nói: Nếu nhìn vào phía trước trong ba năm tới, để doanh thu hàng năm của NVIDIA đạt 20 nghìn tỷ USD, chúng ta cần thêm nhiều máy khắc phát xạ EUV không?
Jensen Huang:
Một số điều tôi sẽ thực hiện trực tiếp, một số sẽ thúc đẩy gián tiếp. Nếu tôi có thể thuyết phục TSMC, thì ASML tự nhiên cũng sẽ được thuyết phục. Vì vậy, chúng ta phải xác định các điểm nút quan trọng. Nhưng chỉ cần TSMC tin vào xu hướng này, vài năm sau bạn sẽ có đủ thiết bị EUV.
Tôi muốn nói là, không có bất kỳ điểm nút nào kéo dài quá hai đến ba năm, không có bất kỳ điểm nút nào.
Trong khi đó, chúng tôi cũng đang nâng cao hiệu quả tính toán. Từ Hopper đến Blackwell, đã tăng khoảng 10 lần, 20 lần, đôi khi thậm chí là 30 đến 50 lần. Chúng tôi cũng liên tục đưa ra thuật toán mới. Bởi vì CUDA đủ linh hoạt, chúng tôi có thể phát triển ra nhiều phương pháp mới, đồng thời tăng cường hiệu suất trong quá trình mở rộng sản xuất.
Vì vậy, những điều này không khiến tôi lo lắng. Điều thực sự làm tôi lo lắng, là những yếu tố bên ngoài luồng gió chi phối của chúng ta như chính sách năng lượng. Không có năng lượng, bạn sẽ không thể mở rộng; không có năng lượng, bạn sẽ không thể xây dựng một ngành công nghiệp; không có năng lượng, bạn sẽ không thể xây dựng một hệ thống sản xuất hoàn toàn mới.
Hiện nay chúng tôi muốn thúc đẩy việc công nghiệp hóa lại ở Mỹ, mang sản xuất chip về Mỹ, mang sản xuất máy tính về Mỹ, đồng thời xây dựng xe điện, robot và những ngành công nghiệp mới thông qua việc xây dựng nhà máy AI. Khi chúng tôi đang xây dựng một nhà máy AI, điều này không thể thiếu năng lượng, và quá trình xây dựng liên quan đến năng lượng kéo dài rất lâu. So với đó, việc tăng cường khả năng sản xuất chip chỉ là một vấn đề trong hai ba năm; tăng cường khả năng sản xuất CoWoS cũng là một vấn đề trong hai ba năm.
Dwarkesh Patel:
Thú vị. Tôi cảm thấy một số khách mời tôi đã phỏng vấn, quan điểm họ đưa ra chính ngược lại. Chỉ là trên vấn đề này, tôi thực sự thiếu kiến thức kỹ thuật đủ để đưa ra quyết định.
Jensen Huang:
Tuy nhiên, điều tốt là bạn đang trò chuyện với các chuyên gia.
TPU của Google có làm lung lay vị thế của NVIDIA không?
Dwarkesh Patel:
Đúng vậy. Tôi muốn hỏi về đối thủ của bạn. Nếu nhìn vào TPU, có thể nói rằng trong ba mô hình lớn toàn cầu hiện nay, hai trong số đó - Claude và Gemini - đã được huấn luyện bằng TPU. Điều này có ý nghĩa gì đối với tương lai của NVIDIA?
Nhận xét: TPU (Tensor Processing Unit, Đơn vị Xử lý Tensor) là một loại chip chuyên dùng do Google thiết kế đặc biệt cho trí tuệ nhân tạo (đặc biệt là học sâu)
Jensen Huang:
Chúng tôi đang làm hoàn toàn một điều khác. NVIDIA xây dựng là "tăng tốc tính toán" (accelerated computing), chứ không phải là đơn vị xử lý Tensor (TPU).
Tăng tốc tính toán có thể được sử dụng cho nhiều nhiệm vụ khác nhau, chẳng hạn như động học phân tử, mô hình màu lượng tử; cũng được sử dụng cho xử lý dữ liệu, khung dữ liệu, dữ liệu cấu trúc, dữ liệu không cấu trúc, cũng được sử dụng cho lực học lưu, vật lý hạt cơ bản, chắc chắn cũng bao gồm trí tuệ nhân tạo. Vì vậy, phạm vi ứng dụng của tăng tốc tính toán rộng hơn nhiều.
Mặc dù cuộc trò chuyện của mọi người hiện tập trung vào trí tuệ nhân tạo, trí tuệ nhân tạo thực sự rất quan trọng và có ảnh hưởng lớn, nhưng phạm vi của "tính toán" chính mình rộng lớn hơn nhiều so với trí tuệ nhân tạo. Những gì NVIDIA đang làm là tái phát minh cách tính từ tính sang tăng tốc tính toán. Phạm vi thị trường của chúng tôi rộng lớn hơn rất nhiều so với bất kỳ TPU hoặc bất kỳ bộ tăng tốc chuyên dụng nào có thể bao quát được.
Nếu nhìn vào vị trí của chúng tôi, chúng tôi là một trong những công ty duy nhất có thể tăng tốc mọi loại ứng dụng. Chúng tôi có hệ sinh thái lớn mạnh, nhiều khung dữ liệu và thuật toán đều có thể chạy trên nền tảng NVIDIA. Hơn nữa, hệ thống máy tính của chúng tôi được thiết kế để "do người khác vận hành". Bất kỳ người vận hành nào cũng có thể mua hệ thống của chúng tôi để sử dụng.
Đa số các hệ thống tự phát triển không được thiết kế để người khác sử dụng, bạn gần như phải tự mình vận hành chúng vì chúng đã không được thiết kế từ đầu đủ linh hoạt để người khác sử dụng. Vì chúng tôi làm cho hệ thống của mình có thể người khác vận hành, chúng tôi đã tiếp cận tất cả các nền tảng chính, bao gồm Google, Amazon, Azure, OCI và nhiều nền tảng khác.
Dù bạn muốn cho thuê khả năng tính toán để vận hành hệ thống hay tự mình sử dụng hệ thống, nếu bạn muốn thực hiện doanh nghiệp cho thuê, bạn phải có một hệ sinh thái khách hàng quy mô lớn bao gồm nhiều ngành để đáp ứng những yêu cầu này. Nếu bạn muốn tự mình vận hành hệ thống, chúng tôi tất nhiên cũng có khả năng giúp bạn hoàn thành công việc này. Ví dụ, Elon với xAI.
Bởi vì chúng tôi có thể cho phép người vận hành của mọi ngành, của mọi công ty có thể sử dụng hệ thống của chúng tôi, bạn có thể sử dụng để xây dựng siêu máy tính cho các công ty như Lilly, dùng cho nghiên cứu khoa học và phát hiện dược phẩm. Chúng tôi có thể giúp họ vận hành siêu máy tính của mình và sử dụng nó cho các ứng dụng trong toàn bộ lĩnh vực nghiên cứu dược phẩm và khoa học sinh học, những lĩnh vực mà chúng tôi có thể tăng tốc.
Vì vậy chúng ta có thể áp dụng vào nhiều tình huống ứng dụng khác nhau, điều mà TPU không thể làm được. CUDA được phát triển bởi NVIDIA, cũng có thể tự mình là một nền tảng xử lý tensor tuyệt vời, nhưng nó không chỉ dừng lại ở đó, nó bao gồm toàn bộ quá trình xử lý dữ liệu, tính toán, trí tuệ nhân tạo và nhiều hơn nữa. Vì vậy, cơ hội thị trường của chúng tôi lớn hơn nhiều và phạm vi áp dụng cũng rộng hơn. Ngoài ra, vì chúng tôi hiện đang hỗ trợ hầu hết mọi loại ứng dụng trên toàn cầu, bạn có thể triển khai hệ thống NVIDIA ở bất kỳ đâu và chắc chắn sẽ có khách hàng sử dụng nó.
Vì vậy, bản chất của điều này hoàn toàn khác biệt.
Dwarkesh Patel:
Câu hỏi này sẽ hơi dài một chút.
Doanh thu hiện tại của bạn rất ấn tượng và thu nhập chủ yếu không đến từ ngành dược phẩm hoặc tính toán lượng tử. Bạn không kiếm được 600 tỷ đô la Mỹ mỗi quý từ các ngành này, mà là bởi vì Trí tuệ Nhân tạo là một công nghệ chưa từng có và đang phát triển với tốc độ chưa từng có.
Vì vậy câu hỏi là: Nếu chỉ nhìn vào Trí tuệ Nhân tạo, giải pháp tốt nhất là gì? Tôi không phải là người làm việc ở mức cấp thấp, nhưng tôi đã trò chuyện với một số bạn bè nghiên cứu Trí tuệ Nhân tạo, họ sẽ nói: Khi tôi sử dụng TPU, đó là một mảng lớn, rất phù hợp cho việc nhân ma trận; trong khi GPU linh hoạt hơn, phù hợp cho việc xử lý các nhánh lớn và truy cập bộ nhớ không đều.
Nhưng nếu bạn nhìn vào Trí tuệ Nhân tạo, thực chất, liệu đó có phải là lặp đi lặp lại, phép nhân ma trận rất dễ dự đoán không? Vì vậy, thực tế, bạn không cần dành diện tích chip cho việc warp scheduling, chuyển đổi luồng, bộ nhớ bank và các tính năng khác. Vì vậy, trong làn sóng tăng cường sức mạnh tính toán này và tăng trưởng doanh thu, TPU được tối ưu hóa cao cho các tình huống ứng dụng chính.
Bạn nghĩ sao về quan điểm này?
Jensen Huang:
Phép nhân ma trận thực sự là một phần quan trọng trong Trí tuệ Nhân tạo, nhưng nó không phải là toàn bộ của Trí tuệ Nhân tạo.
Nếu bạn muốn đề xuất một cơ chế attention mới, hoặc sử dụng cách tính khác; nếu bạn muốn thiết kế một kiến trúc hoàn toàn mới, chẳng hạn như hybrid SSM; nếu bạn muốn xây dựng một mô hình kết hợp giữa diffusion và autoregressive — điều bạn cần là một kiến trúc có thể lập trình chung, và chúng tôi có thể chạy bất kỳ điều gì bạn có thể nghĩ đến.
Đây là ưu thế của chúng tôi, nó làm cho việc phát minh thuật toán mới trở nên dễ dàng hơn nhiều. Chính vì đây là một hệ thống có thể lập trình, và việc liên tục phát minh thuật toán mới, là lý do mà Trí tuệ Nhân tạo có thể tiến triển với tốc độ nhanh như vậy.
TPU cũng giống như bất kỳ phần cứng nào khác, đều chịu ảnh hưởng từ Định lý Moore. Chúng tôi biết rằng Định lý Moore mang lại khoảng 25% sự tiến bộ mỗi năm. Vì vậy, nếu bạn muốn đạt được bước nhảy 10 lần, 100 lần, cách duy nhất là thay đổi hoàn toàn thuật toán và cách tính toán của nó hàng năm.
Đó chính là ưu điểm cốt lõi của NVIDIA.
Lý do chúng tôi có thể đạt được cải tiến đáng kể so với Hopper - tôi đã nói là 35 lần - khi tôi lần đầu tiên công bố rằng hiệu suất tiêu thụ năng lượng của Blackwell sẽ tăng 35 lần so với Hopper, không ai tin vào đó.
Sau đó, Dylan đã viết một bài báo, nói rằng thực ra tôi còn kín đáo, sự cải tiến thực sự gần 50 lần hơn và điều này không thể chỉ dựa vào Định lý Moore để thực hiện. Phương pháp chúng tôi giải quyết vấn đề này là thông qua việc giới thiệu cấu trúc mô hình mới, chẳng hạn như MoE, và thực hiện tính toán theo cách song song, phân rã, xử lý phân tán, mở rộng ra toàn bộ hệ thống tính toán. Nếu không có khả năng tiếp cận từng tầng cấp phát, phát triển các nhân bản tính toán mới bằng CUDA, những điều này thậm chí là khó khăn để thực hiện.
Lưu ý: Dylan Patel chỉ số phân tích nổi tiếng trong lĩnh vực cơ sở hạ tầng Bán dẫn và Trí tuệ Nhân tạo, người sáng lập tổ chức nghiên cứu SemiAnalysis.
Vì vậy, ưu điểm của chúng tôi nằm ở chỗ: tính linh hoạt của kiến trúc, cũng như NVIDIA là một công ty thiết kế cộng tác cao. Chúng tôi thậm chí có thể chuyển một phần tính toán sang kiến trúc kết nối, chẳng hạn như NVLink, hoặc tầng mạng, chẳng hạn như Spectrum-X. Điều đó có nghĩa là, chúng tôi có thể đẩy mạnh sự thay đổi đồng thời ở mức xử lý, hệ thống, kết nối, thư viện phần mềm, thuật toán. Tất cả những điều này đều diễn ra đồng thời. Nếu không có CUDA để hỗ trợ tất cả điều đó, thậm chí tôi không biết nên bắt đầu từ đâu.
Dwarkesh Patel:
Điều này cũng mở ra một vấn đề về cấu trúc khách hàng của NVIDIA: Nếu 60% doanh thu của bạn đến từ năm nhà cung cấp đám mây siêu lớn này (hyperscalers), trong một thời đại khác, đối mặt với loại khách hàng khác, chẳng hạn như các giáo sư thực nghiệm, họ sẽ hoàn toàn phụ thuộc vào CUDA. Họ không thể sử dụng bất kỳ bộ tăng tốc nào khác, chỉ có thể sử dụng PyTorch + CUDA, và tất cả phải được tối ưu hóa.
Nhưng nếu đó là các nhà cung cấp dịch vụ đám mây siêu lớn này, họ có khả năng tự viết kernel của họ. Trên thực tế, họ cũng phải làm như vậy để khai thác tối đa 5% cuối cùng của hiệu suất. Anthropic, Google nhiều lần đang sử dụng bộ tăng tốc do chính họ phát triển hoặc TPU để huấn luyện. Thậm chí OpenAI, khi sử dụng GPU, cũng sẽ sử dụng Triton, họ sẽ nói: Chúng tôi cần kernel của chính mình. Vì vậy họ sẽ viết trực tiếp CUDA C++, thay vì sử dụng cuBLAS, NCCL những thư viện này, và xây dựng ngăn xếp phần mềm của riêng họ, thậm chí có thể biên dịch vào các bộ tăng tốc khác.
Vì vậy, đối với đa số khách hàng của anh/chị, họ thực sự có thể và đang thay thế CUDA. Vậy CUDA thực sự đóng vai trò quan trọng như thế nào trong việc đẩy mạnh trí tuệ nhân tạo tiên tiến mà vẫn phải phụ thuộc vào NVIDIA?
Jensen Huang:
Đầu tiên, CUDA là một hệ sinh thái rất phong phú. Nếu anh/chị muốn phát triển trên bất kỳ máy tính nào, bắt đầu từ CUDA là một lựa chọn rất khôn ngoan. Bởi vì hệ sinh thái này rất phong phú, chúng tôi hỗ trợ tất cả các framework phổ biến.
Nếu anh/chị cần viết kernel tùy chỉnh, như Triton chẳng hạn, chúng tôi đã đóng góp nhiều công nghệ của NVIDIA vào phần backend của Triton, và chúng tôi rất sẵn lòng giúp đỡ các framework khác trở nên tốt hơn. Hiện nay có rất nhiều framework, như Triton, vLLM, SG Lang, và nhiều hơn nữa.
Với sự phát triển của sau huấn luyện (post-training) và học tăng cường, lĩnh vực này đang mở rộng nhanh chóng. Ví dụ, anh/chị có Vairal, NeMo RL, cũng như một loạt các framework mới. Nếu anh/chị muốn phát triển trên một kiến trúc nào đó, bắt đầu từ CUDA là lựa chọn hợp lý nhất, vì anh/chị biết rằng hệ sinh thái đã chín chắn. Khi gặp vấn đề, khả năng cao là do mã của anh/chị có vấn đề, chứ không phải do mã cơ bản đó dài loằng ngoằng.
Đừng quên, quy mô mã nguồn mà các hệ thống này đứng sau là rất lớn. Khi hệ thống gặp vấn đề, anh/chị muốn biết vấn đề là ở phần của anh/chị, hay là ở nền tảng tính toán chính.
Anh/chị chắc chắn muốn vấn đề nằm ở phía của mình, chứ không phải ở nền tảng tính toán. Tất nhiên, chúng tôi cũng có nhiều lỗi, nhưng hệ thống của chúng tôi đã rất chín chắn, anh/chị ít nhất có thể tiếp tục xây dựng trên một nền tảng đáng tin cậy.
Thứ hai, là quy mô cơ sở cài đặt. Nếu anh/chị là nhà phát triển, bất kể anh/chị đang làm gì, điều quan trọng nhất là "cài đặt cơ sở" (install base). Anh/chị muốn phần mềm của mình chạy trên càng nhiều máy tính càng tốt. Anh/chị không phải làm phần mềm cho bản thân mình, mà là phải làm phần mềm cho cả cụm của mình, thậm chí là cho toàn bộ ngành, vì anh/chị là một nhà phát triển framework.
Hệ sinh thái CUDA của NVIDIA, về bản chất, là tài sản quan trọng nhất của chúng tôi. Hiện nay trên toàn thế giới đã có hàng tỷ GPU. Tất cả các nhà cung cấp đám mây đều có, từ V100, A100, H100, H200, L series, P series, có hầu hết mọi cấu hình.
Và chúng tồn tại dưới nhiều hình thái khác nhau. Nếu anh/chị là một công ty robot, anh/chị muốn CUDA có thể chạy trực tiếp trên thân máy robot. Chúng ta gần như ở mọi nơi.
Điều này có nghĩa là, khi anh/chị phát triển phần mềm hoặc mô hình, nó có thể được sử dụng ở bất kỳ nơi nào. Vì vậy giá trị của cơ sở cài đặt này chính nó là cực kỳ lớn.
Điểm cuối cuối cùng là tính linh hoạt trong việc triển khai vị trí. Chúng tôi hiện diện trên tất cả các nền tảng đám mây, điều này khiến chúng tôi trở nên độc đáo. Với vai trò là một công ty trí tuệ nhân tạo hoặc nhà phát triển, bạn không chắc chắn rằng cuối cùng sẽ hợp tác với nhà cung cấp đám mây nào, cũng như không chắc rằng hệ thống của bạn sẽ chạy ở đâu. Nhưng chúng tôi có thể chạy ở mọi nơi, bao gồm triển khai cục bộ (on-prem).
Vì vậy, sự phong phú của hệ sinh thái, quy mô cài đặt cơ sở và tính linh hoạt trong việc triển khai vị trí, ba yếu tố này kết hợp lại là rất có giá trị.
Dwarkesh Patel:
Điều đó rất hợp lý. Nhưng điều tôi thực sự tò mò là, những lợi ích này có thực sự quan trọng đối với các khách hàng chính của bạn không. Thật sự có rất nhiều người sẽ hưởng lợi từ những ưu điểm này, nhưng những người có thể xây dựng ngăn xếp phần mềm của riêng họ - cũng chính là nhóm khách hàng đóng góp phần lớn doanh thu của bạn - đặc biệt là trong một thế giới ngày càng mạnh mẽ với AI trong nhiệm vụ "vòng lặp phản hồi có thể xác minh" như tăng cường học, nơi các kịch bản chú ý hoặc tối ưu kernel như attention hoặc MLP thật sự là một chu trình phản hồi có thể xác minh rất dễ dàng.
Vậy các nhà cung cấp đám mây siêu lớn như vậy, liệu họ hoàn toàn có thể tự viết những kernel này không? Tất nhiên, họ có thể vẫn chọn Nvidia vì hiệu năng giá trị. Nhưng vấn đề đặt ra là, liệu tỷ suất lợi nhuận này có thể được duy trì nếu hầu hết khách hàng có thể tự xây dựng ngăn xếp phần mềm của riêng mình mà không cần phụ thuộc vào CUDA.
Jensen Huang:
Số lượng kỹ sư chúng tôi bỏ vào các phòng thí nghiệm AI này thực sự đáng kinh ngạc, làm việc cùng họ, giúp họ tối ưu hóa toàn bộ ngăn xếp công nghệ. Lý do là không ai hiểu kiến trúc của chúng tôi hơn chúng tôi. Và những kiến trúc này không phải là tổng quát như CPU.
CPU giống như một "chiếc xe gia đình" một chút, bạn có thể hiểu nó như một chiếc xe du lịch, không chạy nhanh, nhưng mọi người đều có thể lái tốt, có chế độ du lịch điều chỉnh tốt, mọi thứ đều đơn giản. Nhưng bộ tăng tốc độ GPU của Nvidia giống như một chiếc xe đua F1. Tôi có thể tưởng tượng mỗi người đều có thể đưa nó lên 100 dặm mỗi giờ, nhưng để đẩy nó đến giới hạn thực sự, cần có khả năng chuyên môn khá lớn.
Và chúng tôi sử dụng rất nhiều trí tuệ nhân tạo để tạo ra những kernel này. Tôi rất chắc chắn, trong một khoảng thời gian khá dài, chúng tôi vẫn là không thể thiếu. Khả năng chuyên môn của chúng tôi có thể giúp đối tác phòng thí nghiệm AI này, dễ dàng nâng cao hiệu suất của họ một cách lớn. Rất nhiều lúc, sau khi tối ưu hóa ngăn xếp công nghệ hoặc một phần kernel nào đó của họ, mô hình của họ có thể tăng tốc 3 lần, 2 lần, thậm chí là 50%. Điều này là một bước tiến rất lớn, đặc biệt là khi bạn cân nhắc rằng họ sở hữu nhiều cụm Hỗn và Blackwell.
Nếu bạn cải thiện hiệu suất kép lên gấp đôi, điều đó đồng nghĩa với việc doanh thu tăng gấp đôi. Điều này trực tiếp liên quan đến doanh thu. Kho lưu trữ tính toán của NVIDIA thể hiện hiệu suất/TCO (Tổng Chi phí Sở hữu) tốt nhất trên toàn cầu, không có đối thủ nào. Không có công ty nào có thể chứng minh cho tôi, nền tảng nào vượt trội hơn chúng tôi về hệ số hiệu suất/TCO. Không có chỗ nào cả. Và những bài kiểm tra chuẩn này là công khai.
Dylan nói đúng. Inference Max là công khai, bất kỳ ai cũng có thể sử dụng. Nhưng không có đội TPU nào sẵn lòng sử dụng nó để thể hiện ưu thế về chi phí suy luận của họ. Điều này rất khó thực hiện, không ai muốn lên tiếng để chứng minh.
Cũng với MLPerf. Tôi rất hoan nghênh họ đến để chứng minh ưu thế 40% mà họ luôn tuyên bố. Tôi rất muốn thấy họ chứng minh ưu thế về chi phí suy luận của TPU. Đối với tôi, điều này vô lý, từ cơ bản mà nói không thể hiểu được. Hoàn toàn không thể hiểu được.
Vì vậy, tôi nghĩ rằng, lý do chúng tôi thành công, nguyên do căn bản là TCO của chúng tôi rất xuất sắc.
Một điểm khác, bạn nói rằng 60% khách hàng của chúng tôi đến từ năm công ty lớn nhất, nhưng đa số doanh nghiệp này thực sự phục vụ khách hàng bên ngoài. Ví dụ, trên AWS, phần lớn sức mạnh tính toán của NVIDIA được cung cấp cho khách hàng bên ngoài, không phải do AWS sử dụng. Trên Azure, khách hàng của chúng tôi hầu hết cũng là khách hàng bên ngoài; trên OCI cũng vậy. Họ chọn chúng tôi vì phạm vi của chúng tôi rất rộng.
Chúng tôi có thể đưa khách hàng chất lượng cao nhất trên toàn cầu đến với họ, và những khách hàng này thường xây dựng trên nền tảng NVIDIA. Và họ xây dựng trên NVIDIA vì phạm vi và tính linh hoạt của chúng tôi rất mạnh mẽ.
Do đó, tôi nghĩ rằng, cánh cửa này đang có tác dụng: cơ sở cài đặt, tính lập trình của kiến trúc, tích lũy liên tục trong hệ sinh thái. Cộng với sự xuất hiện hàng ngàn công ty trí tuệ nhân tạo trên toàn cầu bây giờ. Nếu bạn là một trong những công ty trí tuệ nhân tạo khởi nghiệp, bạn sẽ chọn kiến trúc nào? Bạn sẽ chọn kiến trúc phổ biến nhất, có cơ sở cài đặt lớn nhất, có hệ sinh thái phong phú nhất. Đó chính là lý do của cánh cửa này.
Vì vậy lý do là:
· Thứ nhất, hiệu suất theo đơn vị chi phí (performance per dollar) của chúng tôi rất cao, do đó chi phí Token thấp nhất;
· Thứ hai, hiệu suất theo đơn vị công suất (performance per watt) của chúng tôi là cao nhất trên thế giới; nếu đối tác xây dựng một Trung tâm dữ liệu 1GW, nó phải tạo ra số lượng Token lớn nhất, tức là doanh thu lớn nhất. Và kiến trúc của chúng tôi có thể tạo ra số lượng Token lớn nhất theo đơn vị công suất.
· Thứ ba, nếu mục tiêu của bạn là cho thuê công suất tính toán, chúng tôi có số lượng khách hàng lớn nhất trên toàn cầu.
Đó chính là lý do Flywheel thành lập.
Dwarkesh Patel:
Rất thú vị. Tôi nghĩ rằng vấn đề cốt lõi nằm ở cấu trúc thị trường này là như thế nào. Dù có nhiều công ty, có khả năng hoàn toàn có thể xảy ra trường hợp: có hàng nghìn công ty AI, chúng chia sẻ công suất tính toán một cách công bằng.
Nhưng nếu thực tế là, thông qua những nhà cung cấp điện toán đám mây quy mô lớn, các công ty mẫu cơ bản như Anthropic, OpenAI mới thực sự sử dụng công suất tính toán, và chúng có khả năng làm cho tất cả các bộ gia tốc khác đều hoạt động.
Jensen Huang:
Tôi nghĩ rằng tiền đề của bạn đó là sai.
Dwarkesh Patel:
Có lẽ đúng. Vậy tôi đặt câu hỏi theo cách khác, nếu các lập luận về hiệu suất và chi phí đó đều đúng, vậy tại sao các công ty như Anthropic lại mới đây thông báo hợp tác cấp độ Gigawatt với Broadcom, Google? Và hầu hết công suất của họ đều từ các hệ thống này. Đối với Google, TPU chính là nguồn công suất chính. Vì vậy, nếu nhìn những công ty AI lớn như vậy, trước đây toàn bộ chỉ sử dụng NVIDIA, nhưng giờ không còn.
Nếu những ưu điểm này khi lý thuyết đúng, vậy tại sao họ lại chọn bộ gia tốc khác?
Jensen Huang:
Anthropic là một ví dụ khá đặc biệt. Nếu không có Anthropic, sự tăng trưởng của TPU gần như không tồn tại. Sự tăng trưởng của TPU gần như toàn bộ đến từ Anthropic. Tương tự, nếu không có Anthropic, yêu cầu đào tạo cũng gần như không tăng lên.
Đó là một sự thật rất rõ ràng. Không có nhiều cơ hội tương tự, thực tế chỉ có một Anthropic.
Dwarkesh Patel:
Nhưng OpenAI cũng hợp tác với AMD, họ đang phát triển bộ gia tốc Titan riêng của mình.
Lưu ý: AMD (Advanced Micro Devices) là một công ty bán dẫn người Mỹ, chủ yếu thiết kế chip tính toán, là đối thủ cạnh tranh quan trọng của NVIDIA và Intel
Jensen Huang:
Nhưng họ vẫn chủ yếu sử dụng NVIDIA. Chúng tôi cũng sẽ tiếp tục hợp tác mạnh mẽ. Tôi không hề cảm thấy bực bội vì người khác thử nghiệm các phương án khác. Nếu họ không thử các phương án khác, làm sao họ biết phương án của chúng tôi tốt đến mức nào?
Đôi khi thực sự cần phải qua so sánh để tái xác nhận điều này. Và chúng ta cũng phải liên tục chứng minh rằng chúng ta xứng đáng với vị trí hiện tại.
Trên thị trường luôn có đủ loại tuyên bố. Bạn có thể xem xem có bao nhiêu dự án ASIC đã bị hủy bỏ. Chỉ vì bạn bắt đầu làm ASIC không có nghĩa là bạn có thể tạo ra sản phẩm tốt hơn Nvidia.
Thực tế là điều này không dễ dàng. Thậm chí có thể nói, về mặt lý trí, điều này không thực sự hợp lý. Trừ khi Nvidia thực sự đã mắc lỗi nghiêm trọng ở một số khía cạnh. Nhưng khi xem xét về quy mô của chúng ta, về tốc độ của chúng ta — chúng ta là công ty duy nhất trên thế giới thực hiện những bước nhảy lớn mỗi năm.
Dwarkesh Patel:
Lý do của họ là: Không cần phải tốt hơn Nvidia, chỉ cần không kém Nvidia 70% là được, vì họ nghĩ rằng tỷ suất lợi nhuận của bạn là 70%.
Jensen Huang:
Nhưng đừng quên, thậm chí các ASIC, tỷ suất lợi nhuận thực sự cũng rất cao. Tỷ suất lợi nhuận của Nvidia khoảng 60%–70%, trong khi tỷ suất lợi nhuận của ASIC cũng có thể lên đến 65%. Vậy bạn đã tiết kiệm được bao nhiêu thực sự?
Bạn luôn phải trả tiền cho một bên nào đó. Vì vậy dựa vào những gì tôi thấy, tỷ suất lợi nhuận của các doanh nghiệp cơ bản này (ASIC) thực sự cũng rất cao, và họ cũng có cùng quan điểm, và họ tự hào về điều đó.
Rất lâu trước, chúng tôi thực sự không có khả năng làm điều này. Và thực sự mà nói, vào thời điểm đó tôi không thực sự hiểu rõ, xây dựng một phòng thí nghiệm mô hình cơ bản như OpenAI hay Anthropic thực sự khó khăn như thế nào. Cũng không ý thức hoàn toàn rằng, họ thực sự cần sự hỗ trợ đầu tư quy mô lớn từ nhà cung cấp.
Vào thời điểm đó, chúng tôi không có khả năng thực hiện đầu tư hàng chục tỷ USD đó, như đầu tư cho Anthropic, để họ sử dụng năng lực tính toán của chúng tôi. Nhưng Google và AWS có thể, họ đã đầu tư số tiền lớn từ ban đầu, và như một phần trả lại, Anthropic sử dụng năng lực tính toán của họ.
Chúng tôi không có khả năng làm điều đó vào thời điểm đó, và tôi phải nói, đây là một trong những sai lầm của tôi: Tôi không thực sự ý thức được rằng, họ thực sự không có lựa chọn nào khác. Các công ty rủi ro không thể đầu tư 50 tỷ, 100 tỷ USD để hỗ trợ một phòng thí nghiệm AI, và kỳ vọng nó phát triển thành Anthropic.
Đây là sự nhầm lẫn của tôi. Nhưng ngay cả khi tôi nhận ra ở thời điểm đó, tôi cũng không nghĩ rằng chúng ta có khả năng làm điều đó ở giai đoạn đó.
Nhưng tôi sẽ không mắc phải sai lầm giống như thế nữa. Tôi rất vui lòng có thể đầu tư vào OpenAI, cũng như hân hạnh giúp họ mở rộng, tôi nghĩ điều này là cần thiết. Khi Anthropic đến tìm chúng tôi sau đó, tôi cũng rất vui lòng trở thành nhà đầu tư, giúp họ phát triển.
Chỉ đơn giản vào thời điểm đó, chúng tôi thực sự không thể làm được. Nếu có thể quay lại, nếu lúc đó NVIDIA đã mạnh mẽ như hiện tại, tôi rất sẵn lòng thực hiện những việc đó.
Tại sao NVIDIA không tham gia vào lĩnh vực "Điện toán đám mây"?
Dwarkesh Patel:
Điều này rất thú vị. Suốt nhiều năm, NVIDIA luôn là công ty "bán xẻng để kiếm tiền" trong lĩnh vực Trí tuệ Nhân tạo, và họ đã kiếm được rất nhiều tiền. Và bây giờ bạn bắt đầu đầu tư số tiền đó vào các công ty. Có báo cáo cho biết bạn đã đầu tư 300 tỷ đô la vào OpenAI, 100 tỷ đô la vào Anthropic. Và giá trị của những công ty này vẫn tiếp tục tăng.
Vì vậy, nếu nhìn lại những năm qua, bạn đã cung cấp họ sức mạnh tính toán, cũng nhìn thấy xu hướng, trong khi giá trị của họ chỉ là mười phần một so với bây giờ, thậm chí còn thấp hơn rất nhiều so với mức hiện tại một năm trước. Và lúc đó, bạn đã có một lượng lớn tiền mặt.
Trong thực tế, có một khả năng tồn tại: NVIDIA tự mình trở thành một công ty mô hình cơ sở, hoặc đầu tư vào quy mô lớn hơn từ rất sớm, tương tự như những gì bạn đang làm bây giờ.
Vì vậy, tôi thực sự rất tò mò, tại sao không thực hiện điều này sớm hơn?
Jensen Huang:
Chúng tôi chỉ làm khi "có khả năng làm được". Nếu lúc đó có thể, tôi sẽ làm sớm hơn. Khi Anthropic cần sự hỗ trợ của chúng tôi lúc đầu, tôi sẽ làm. Nhưng vào thời điểm đó, chúng tôi thực sự không có khả năng đó.
Điều đó không nằm trong khả năng của chúng tôi, cũng không nằm trong thói quen ra quyết định của chúng tôi.
Dwarkesh Patel:
Là vấn đề về vốn, phải không?
Jensen Huang:
Đúng, là vấn đề quy mô đầu tư. Lúc đó, chúng tôi gần như không có truyền thống đầu tư bên ngoài, chưa kể đến việc đầu tư ở mức độ đó. Và chúng tôi cũng không nhận ra rằng điều đó là cần thiết.
Suy nghĩ của tôi vào thời điểm đó là, họ có thể hoàn toàn tìm kiếm vốn đầu tư rủi ro, giống như các công ty khác. Nhưng những gì họ muốn thực hiện, thực sự không phải là điều mà vốn đầu tư rủi ro có thể hỗ trợ.
Điều này là điều tôi nhận ra sau này. Nhưng đó chính là sự thông minh của họ. Họ đã nhận ra ngay từ thời điểm đó, phải đi đúng con đường đó. Tôi rất vui mừng về điều này. Ngay cả khi chúng tôi không tham gia vào thời điểm đó, dẫn đến Anthropic phải chuyển hướng đối tác khác, tôi vẫn nghĩ rằng đó là điều tốt. Sự tồn tại của Anthropic là điều tốt cho cả thế giới, tôi hạnh phúc vì điều đó. Một số nuối tiếc là có thể chấp nhận được.
Dwarkesh Patel:
Vấn đề quay trở lại một điểm: Khi hiện tại bạn đã có rất nhiều tiền mặt và vẫn tiếp tục tăng, vậy NVIDIA nên sử dụng số tiền này như thế nào?
Một cách tiếp cận là, hiện nay có một hệ sinh thái trung gian xuất hiện, giúp các phòng thí nghiệm AI chuyển đổi chi phí vốn (capex) thành chi phí hoạt động (opex), cho họ có thể thuê sức mạnh tính toán.
Vì GPU rất đắt đỏ, nhưng với sự tiến bộ của mô hình, chúng có thể liên tục tạo ra giá trị mã token cao hơn trong vòng đời. Và NVIDIA chính mình có khả năng chịu trách nhiệm cho các chi phí vốn ban đầu này. Ví dụ, đã có báo cáo cho biết, bạn đã cung cấp hỗ trợ lên đến 6,3 tỷ đô la cho CoreWeave và đã đầu tư 20 tỷ đô la.
Vậy tại sao NVIDIA không tự trở thành một nhà cung cấp dịch vụ đám mây? Tại sao không trở thành một hyperscaler, tự xây dựng đám mây và cho thuê sức mạnh tính toán? Cuối cùng, bạn có khả năng tiền mặt cho điều đó.
Jensen Huang:
Điều này là một vấn đề triết học của công ty, và tôi tin rằng đó là một triết lý khôn ngoan: Chúng ta nên làm "nhiều công việc cần thiết nhất có thể, đồng thời làm ít công việc nhất có thể".
Điều này có nghĩa là, với việc xây dựng nền tảng tính toán này, nếu chúng ta không làm, tôi thực sự tin rằng điều đó sẽ không hoàn thành.
Nếu chúng ta không chịu trách nhiệm với các rủi ro này, không xây dựng NVLink, không xây dựng toàn bộ phần mềm cơ bản, không xây dựng hệ sinh thái này, không dành 20 năm để phát triển CUDA (trong đó hầu hết thời gian thậm chí là lỗ), nếu chúng ta không làm những điều này, không ai sẽ làm. Nếu chúng ta không đi xây dựng các thư viện chuyên biệt trên lĩnh vực CUDA-X này — cho dù đó là theo dõi ánh sáng, tạo hình ảnh, hoặc mô hình AI sớm, xử lý dữ liệu, xử lý dữ liệu cấu trúc, xử lý dữ liệu vector — nếu chúng ta không làm, những thứ đó sẽ không tồn tại.
Tôi hoàn toàn tin vào điều này. Chúng ta thậm chí đã phát triển một thư viện cho phần cứng phát quang gọi là cuLitho, nếu chúng ta không làm, cũng không ai sẽ làm.
Vì vậy, lý do mà tính toán tăng tốc có thể phát triển đến mức này ngày nay, là vì chúng ta đã làm những điều này. Đó chính là phần mà chúng ta nên áp đặt tất cả sự nỗ lực để làm.
Nhưng đồng thời, trên thế giới đã có rất nhiều nhà cung cấp dịch vụ đám mây. Ngay cả khi chúng ta không làm, sẽ vẫn có người đến và làm. Vì vậy, dựa trên "làm nhiều công việc cần thiết nhất có thể, nhưng làm ít công việc nhất có thể" nguyên tắc, ý tưởng này luôn tồn tại trong công ty. Mỗi quyết định tôi đưa ra, đều bắt đầu từ góc nhìn này.
Trong lĩnh vực đám mây này, nếu ban đầu chúng ta không hỗ trợ CoreWeave, các đám mây AI mới này có lẽ sẽ không tồn tại. Nếu chúng ta không hỗ trợ họ, họ sẽ không phát triển đến quy mô hiện tại. Như Nscale, Nebius cũng vậy, nếu không có sự hỗ trợ từ chúng tôi, họ sẽ không phát triển đến hiện tại. Và bây giờ, họ đều phát triển rất mạnh mẽ.
Nhưng liệu đây có phải là một lĩnh vực mà chúng ta nên tham gia cá nhân không? Không phải. Chúng tôi vẫn tuân thủ nguyên tắc đó: làm những việc cần thiết, tránh làm nhiều nhất có thể. Vì vậy, chúng tôi sẽ đầu tư vào hệ sinh thái, bởi vì tôi hy vọng toàn bộ hệ sinh thái có thể phát triển mạnh mẽ. Tôi muốn kiến trúc của chúng ta có thể kết nối nhiều ngành công nghiệp nhất có thể, nhiều quốc gia nhất có thể, để cho trí tuệ nhân tạo có thể được xây dựng toàn cầu và dựa trên các công nghệ tại Hoa Kỳ.
Đó là tầm nhìn chúng tôi đang tiến triển.
Đồng thời, như bạn vừa đề cập, hiện nay có rất nhiều công ty mô hình cơ bản xuất sắc, chúng tôi sẽ cố gắng đầu tư vào họ.
Một điều nữa là, chúng tôi sẽ không "lựa chọn người chiến thắng". Chúng tôi muốn hỗ trợ tất cả mọi người. Điều này không chỉ là cần thiết cho doanh nghiệp của chúng tôi mà còn là điều chúng tôi sẵn lòng thực hiện. Vì vậy, khi tôi đầu tư vào một công ty, tôi cũng sẽ đầu tư vào các công ty khác.
Dwarkesh Patel:
Vậy tại sao bạn lại chủ định không lựa chọn người chiến thắng?
Jensen Huang:
Vì điều đó không phải là trách nhiệm của chúng tôi. Đó là điểm đầu tiên.
Điểm thứ hai, khi NVIDIA mới thành lập, có khoảng 60 công ty đồ họa, 60 công ty làm đồ họa 3D. Cuối cùng chỉ có chúng tôi sống sót. Nếu bạn đã chọn một công ty từ 60 công ty đó sẽ thành công, NVIDIA rất có thể là công ty ít ai kỳ vọng nhất.
Điều này diễn ra trước thời đại của bạn, nhưng khi ấy kiến trúc đồ họa của NVIDIA hoàn toàn sai lầm. Đó không phải là một chút nghịch lý, mà là sai từ gốc rễ. Chúng tôi đã thiết kế một kiến trúc mà các nhà phát triển gần như không thể hỗ trợ, nó đã được dự định không thể thành công. Chúng tôi đã suy luận dựa trên nguyên lý cơ bản rất hợp lý, nhưng cuối cùng đi đến một lời giải sai.
Tất cả mọi người đều nghĩ rằng chúng tôi không thể thành công, nhưng cuối cùng chúng tôi vẫn sống sót. Vì vậy, tôi đủ khiêm tốn để nhận ra điều đó, không chọn người chiến thắng. Hãy để họ phát triển tự nhiên, hoặc hãy hỗ trợ tất cả mọi người.
Dwarkesh Patel:
Có một điều tôi vẫn chưa hiểu rõ. Bạn nói rằng bạn không có ý tự ý ưu tiên hỗ trợ các nhà cung cấp đám mây mới này, nhưng bạn vừa nói nếu không có NVIDIA, chúng có lẽ không tồn tại. Vậy làm sao hai điều này có thể xảy ra đồng thời?
Jensen Huang:
Trước hết, họ phải tự muốn tồn tại và tự mình tiếp cận chúng tôi để tìm kiếm sự trợ giúp. Khi họ có ý định rõ ràng, có kế hoạch kinh doanh, có năng lực, có đam mê—tất nhiên, họ cũng phải có một số năng lực nhất định—nếu họ cần một số hỗ trợ đầu tư ở giai đoạn đầu, chúng tôi sẽ ở đó.
Nhưng điều quan trọng là, họ phải sớm xây dựng được bánh xe quay của riêng mình. Câu hỏi bạn vừa đặt ra là, liệu chúng tôi có muốn tham gia vào kinh doanh tài chính hay không? Câu trả lời là không. Chúng tôi không muốn trở thành một tổ chức tài chính. Trên thị trường đã có nhiều người làm tài chính, chúng tôi sẵn lòng hợp tác với những tổ chức tài chính này hơn là tự mình đi làm tài chính.
Vì vậy, mục tiêu của chúng tôi là tập trung vào công việc của chúng tôi, giữ mô hình kinh doanh càng đơn giản càng tốt, đồng thời hỗ trợ toàn bộ hệ sinh thái.
Jensen Huang:
Khi một công ty như OpenAI cần vốn đầu tư lên đến 300 tỷ USD trước khi niêm yết công khai (IPO), và chúng tôi rất tin tưởng họ - cá nhân tôi rất tin tưởng rằng họ đã là một công ty xuất sắc và sẽ trở thành một công ty xuất sắc hơn nữa. Thế giới này cần họ tồn tại, mọi người cũng mong muốn họ tồn tại, và tôi cũng mong muốn họ tồn tại. Họ có tất cả yếu tố để trở thành người chiến thắng, vì vậy chúng tôi sẽ hỗ trợ họ, giúp họ mở rộng.
Vì vậy, chúng tôi sẽ tiến hành các loại đầu tư như vậy, vì họ thực sự cần chúng tôi thực hiện điều đó. Nhưng nguyên tắc của chúng tôi không phải là "hãy làm càng nhiều càng tốt", mà là "hãy làm ít nhất có thể".
Dwarkesh Patel:
Câu hỏi này có thể hơi dễ thấy, nhưng suốt nhiều năm qua, chúng ta luôn đối mặt với tình trạng thiếu hụt GPU, và khi các mô hình trở nên mạnh mẽ hơn, tình trạng này càng trở nên rõ rệt hơn.
Jensen Huang:
Đúng, chúng tôi thực sự đang mắc phải tình trạng thiếu hụt GPU.
Dwarkesh Patel:
Và NVIDIA được coi là không phải là công ty chỉ đơn giản phân phối các nguồn lực hiếm khi chia sẻ, mà họ cũng sẽ xem xét, chẳng hạn như đảm bảo sự tồn tại của các nhà cung cấp đám mây mới - cung cấp một số cho CoreWeave, một số cho Crusoe, một số cho Lambda.
Đầu tiên, anh đồng ý với quan điểm này không? Thứ hai, điều này mang lại lợi ích gì cho NVIDIA?
Jensen Huang:
Tôi nghĩ giả thiết của bạn là sai. Tất nhiên, chúng tôi sẽ rất cẩn trọng trong việc xem xét những vấn đề như vậy.
Đầu tiên, nếu bạn không có đơn đặt hàng mua hàng (PO), thì việc giao tiếp nhiều cũng không có ý nghĩa. Vì vậy, điều quan trọng đầu tiên là chúng tôi sẽ cùng tất cả các khách hàng nỗ lực để dự báo nhu cầu, vì chu kỳ sản xuất của các sản phẩm này rất dài và việc xây dựng trung tâm dữ liệu cũng rất dài. Chúng tôi sẽ căn cứ vào dự báo để cân bằng cung và cầu, đó là điều quan trọng nhất.
Thứ hai, chúng tôi sẽ cố gắng dự báo cùng với nhiều khách hàng có thể. Nhưng cuối cùng, bạn vẫn phải đặt hàng. Nếu bạn không đặt hàng, thì tôi cũng không thể làm gì hơn. Vì vậy, ở một giai đoạn nào đó, đó là "ai đặt hàng trước sẽ được phục vụ trước".
Ngoài ra, nếu trung tâm dữ liệu của bạn chưa sẵn sàng, hoặc một số thành phần chính chưa sẵn sàng, dẫn đến bạn tạm thời không thể triển khai hệ thống, chúng tôi có thể ưu tiên phục vụ các khách hàng khác. Điều này chỉ là để tối đa hóa hiệu suất lưu thông tổng thể của nhà máy của chúng tôi.
Ngoại trừ trường hợp này, nguyên tắc ưu tiên là "Người đến trước được phục vụ trước". Bạn phải đặt hàng. Nếu bạn không đặt hàng, thì không có cách nào.
Tất nhiên, có nhiều câu chuyện bên ngoài, ví dụ như có người nói Larry và Elon và tôi đã đi ăn cùng nhau và yêu cầu GPU - chúng tôi thực sự đã ăn cùng nhau, đó là một bữa tối rất vui vẻ, nhưng họ chưa bao giờ "yêu cầu" GPU. Họ chỉ cần đặt hàng là được. Khi đặt hàng, chúng tôi sẽ cố gắng hết sức mình để cung cấp năng lực sản xuất. Chuyện không phức tạp như vậy.
Dwarkesh Patel:
Vậy nghe có vẻ như một cơ chế đợi hàng, phụ thuộc vào việc bạn đặt hàng khi nào, trung tâm dữ liệu đã sẵn sàng chưa. Nhưng điều này vẫn không phải là "người đặt giá cao nhất chiến thắng", đúng không?
Jensen Huang:
Chúng tôi chưa từng làm như vậy.
Dwarkesh Patel:
Không phân bổ dựa trên giá cao nhất bao giờ?
Jensen Huang:
Không bao giờ. Vì đó là một thực hành kinh doanh tồi tệ.
Bạn đặt giá, khách hàng quyết định mua hay không. Tôi biết có một số công ty trong ngành sẽ tăng giá khi nhu cầu tăng lên, nhưng chúng tôi sẽ không làm như vậy. Điều này chưa bao giờ là cách làm của chúng tôi. Khách hàng có thể tin tưởng chúng tôi. Tôi muốn trở thành một đối tác đáng tin cậy, trở thành nền tảng của ngành. Bạn không cần phải đoán thay về việc giá cả sẽ thay đổi.
Nếu tôi đã đưa ra báo giá cho bạn, đó là giá cuối cùng. Ngay cả khi nhu cầu tăng lên mạnh mẽ, cũng sẽ không thay đổi.
Dwarkesh Patel:
Vậy đó cũng là một trong những lý do ổn định mối quan hệ giữa bạn và TSMC, phải không?
Jensen Huang:
NVIDIA và TSMC đã hợp tác gần 30 năm. NVIDIA và TSMC thậm chí không có hợp đồng pháp lý chính thức, mối quan hệ giữa họ hơn là một sự hiểu biết tổng thể công bằng. Đôi khi tôi đúng, đôi khi tôi sai; đôi khi tôi nhận được điều kiện tốt hơn, đôi khi không tốt bằng. Nhưng nhìn chung, mối quan hệ này rất tuyệt vời, tôi hoàn toàn tin tưởng họ, cũng như phụ thuộc hoàn toàn vào họ.
Và, với NVIDIA, có một điều bạn có thể chắc chắn: Năm nay, Rubin sẽ xuất sắc, năm sau Vera Rubin Ultra sẽ ra mắt, năm sau đó Feynman sẽ ra mắt, năm tiếp theo - tên đó tôi chưa tiết lộ. Nói cách khác, mỗi năm, bạn có thể tin tưởng chúng tôi. Bạn phải đi khắp thế giới để tìm một đội ASIC nào đó, xem có ai có thể làm bạn nói: Tôi có thể đặt cược cả công ty vào đây, tin rằng mỗi năm bạn sẽ ở đây ủng hộ tôi.
Chi phí của token của tôi sẽ giảm theo một hệ số mỗi năm, tôi có thể tin tưởng điều này giống như tôi tin vào một chiếc đồng hồ. Tôi đã nêu ý kiến tương tự về TSMC. Trong lịch sử, không có một nhà máy nào có thể làm cho bạn nói như vậy.
Nhưng ngày hôm nay, bạn có thể nói với NVIDIA như vậy. Bạn có thể tin tưởng vào chúng tôi mỗi năm.
Nếu bạn muốn mua công suất AI nhà máy trị giá 10 tỷ USD, không vấn đề; nếu bạn chỉ muốn mua 1 tỷ USD, cũng không vấn đề; nếu bạn chỉ muốn mua 10 triệu USD, hoặc thậm chí chỉ mua một cái rack, cũng không vấn đề; thậm chí nếu bạn chỉ muốn mua một chiếc card đồ hoạ, cũng không vấn đề. Nếu bạn muốn đặt hàng nhà máy AI trị giá thêm 1 nghìn tỷ USD, cũng không vấn đề.
Ngày hôm nay, chỉ có một công ty trên thế giới có thể nói như chúng tôi. Và tôi cũng có thể nói với TSMC như vậy: Tôi muốn mua 10 tỷ USD, không vấn đề. Chúng ta chỉ cần kế hoạch tốt, tuân thủ quy trình cần thiết, thực hiện những điều mà một doanh nghiệp chín muối sẽ thực hiện.
Vì vậy, tôi cho rằng NVIDIA có thể trở thành nền tảng của ngành công nghiệp AI toàn cầu, vị thế này chúng tôi đã mất vài thập kỷ để đạt được. Đằng sau đó là sự đầu tư lớn, sự tập trung lớn, và tính ổn định cũng như sự nhất quán của công ty rất quan trọng.
Tại sao NVIDIA từ chối "Chơi nhiều bài"
Dwarkesh Patel:
Điều này thực sự dẫn đến một câu hỏi rất thú vị. Trước đó, chúng ta đã nói về TSMC, về các rào cản như bộ nhớ. Bây giờ nếu chúng ta bước vào một thế giới như vậy: bạn đã chiếm phần lớn năng lực của N3, sau đó có thể sẽ chiếm phần lớn năng lực của N2. Liệu bạn có xem xét quay lại sử dụng sản lượng không sử dụng của các quy trình công nghệ cũ như 7 nanôm không?
Ví dụ, nhu cầu về AI quá lớn, mở rộng quy trình tiên tiến không thể đuổi kịp, sau đó bạn dùng tất cả kinh nghiệm hiện nay về tối ưu hóa số học, thiết kế hệ thống, làm lại một phiên bản Hopper hoặc Ampere hơn. Anh nghĩ bạn sẽ thấy tình huống như vậy xảy ra trước năm 2030 không?
Jensen Huang:
Không cần thiết. Lý do là, sự tiến bộ của mỗi thế hệ kiến trúc không chỉ đến từ việc thay đổi kích thước transistor. Bạn còn thực hiện nhiều công việc kỹ thuật trên việc gói, xếp chồng, hệ thống số hệ thống. Khi bạn đi đến bước này, quay lại và tạo một phiên bản trên nút công nghệ cũ đó, thì mức độ đầu tư nghiên cứu phát triển là không ai chịu nổi. Chúng tôi có thể chi trả tiếp tục tiến lên, nhưng tôi không nghĩ rằng chúng tôi có thể chi trả để quay trở lại.
Tất nhiên, nếu ta thực hiện một thử nghiệm tư duy: giả sử một ngày, toàn cầu đồng lòng nói rằng, khả năng sản xuất tiên tiến sẽ không bao giờ tăng thêm. Liệu tôi có quay lại ngay để sử dụng công nghệ 7 nanôm? Dĩ nhiên, tôi sẽ làm, không có vấn đề.
Dwarkesh Patel:
Tôi trước đó đã thảo luận với một người khác về một vấn đề: tại sao NVIDIA không tiến hành đồng thời nhiều dự án chip hoàn toàn khác nhau? Ví dụ, bạn có thể tạo ra một kiến trúc cấp wafer như Cerebras, có thể tạo ra một dạng đóng gói lớn như Dojo, và cũng có thể tạo ra một thứ không phụ thuộc vào CUDA.
Bạn có tài nguyên và có nhân tài kỹ thuật, có thể thực hiện song song các công việc này. Khi không ai biết rõ tương lai của AI hoặc kiến trúc sẽ đi về đâu, tại sao phải để tất cả trứng vào một rổ?
Jensen Huang:
Tất nhiên chúng tôi có thể làm như vậy. Chỉ là chúng tôi chưa thấy phương án tốt hơn. Chúng tôi đã mô phỏng tất cả những điều này, và rất có khả năng trong bộ mô phỏng của chúng tôi chúng đều kém hơn. Vì vậy chúng tôi không thực hiện. Những gì chúng tôi đang làm bây giờ, chính là những dự án chúng tôi thực sự muốn làm, và coi đó là đúng nhất.
Tất nhiên, nếu tải công việc trong tương lai thay đổi mạnh mẽ—tôi nói về việc tải công việc thực sự thay đổi, không phải thay đổi thuật toán, thì chúng tôi có thể thêm vào các loại bộ tăng tốc khác.
Ví dụ, gần đây chúng tôi đã thêm Grok, chúng tôi sẽ tích hợp Grok vào hệ sinh thái CUDA. Chúng tôi đang tiến hành công việc này. Điều này là do giá trị của mã thông báo đã trở nên rất cao, vì vậy cùng một mô hình, dựa trên thời gian phản hồi khác nhau, có thể tương ứng với các tầng giá khác nhau.
Một vài năm trước, mã thông báo gần như miễn phí, hoặc nói cách khác rất rẻ. Nhưng bây giờ, các khách hàng khác nhau yêu cầu mã thông báo theo cách khác nhau. Và những khách hàng này tự mình có thể kiếm được nhiều tiền từ đó. Ví dụ, với kỹ sư phần mềm, nếu tôi có thể cung cấp cho họ mã thông báo nhanh hơn, giúp họ hiệu quả hơn so với hiện tại, thì tôi sẵn lòng trả tiền đều được.
Nhưng loại thị trường này, thực sự chỉ mới xuất hiện gần đây. Vì vậy tôi nghĩ, lần đầu tiên bây giờ chúng tôi có khả năng làm cho cùng một mô hình dựa trên thời gian phản hồi tạo ra các tầng thị trường khác nhau.
Đây cũng là lý do tôi quyết định mở rộng biên Pareto này, để thực hiện một nhánh suy luận có "thời gian phản hồi nhanh hơn, nhưng thông lượng thấp hơn". Vì quá khứ, thông lượng cao luôn là quan trọng nhất. Nhưng chúng tôi hiện tại tin rằng, trong tương lai có thể xuất hiện một loại mã thông báo với ASP cao. Ngay cả khi thông lượng trên dây chuyền thấp đi, giá trên mỗi đơn vị đủ để bù đắp.
Đó chính là lý do chúng tôi thực hiện như vậy. Nhưng nếu chỉ nói về kiến trúc chính mình, tôi sẽ nói, nếu có thêm tiền, tôi sẽ đầu tư thêm tiền vào kiến trúc hiện tại.
Dwarkesh Patel:
Tôi nghĩ ý tưởng về "mã thông báo với áp điện cực cao" và tầng thị trường suy luận rất thú vị.
Câu hỏi cuối cùng. Giả sử Cuộc cách mạng Học sâu chưa bao giờ xảy ra, Nvidia sẽ làm gì vào ngày hôm nay?
Jensen Huang:
Tất nhiên, chúng tôi vẫn sẽ tiếp tục phát triển trò chơi, nhưng ngoài ra, chúng tôi sẽ tiếp tục tăng tốc tính toán. Đó luôn là điều chúng tôi đã làm, đây là lý do chúng tôi tồn tại.
Giả định cơ bản của công ty chúng tôi là: Định luật Moore sẽ chậm lại. Tính toán tổng quát hoạt động tốt cho nhiều thứ, nhưng không phải là phương án lý tưởng cho nhiều nhiệm vụ tính toán. Vì vậy, chúng tôi kết hợp kiến trúc GPU và CPU, để GPU tăng tốc khối lượng công việc của CPU. Các mã kernel khác nhau, các thuật toán khác nhau, có thể được chuyển sang GPU để chạy. Do đó, một ứng dụng có thể tăng tốc độ 100 lần, 200 lần.
Và nó có thể được sử dụng ở đâu? Tất nhiên là trong kỹ thuật, khoa học, vật lý, xử lý dữ liệu, đồ họa máy tính, tạo hình hình ảnh, và nhiều nơi khác.
Do đó, ngay cả khi AI không tồn tại ngày hôm nay, Nvidia vẫn sẽ là một công ty rất lớn. Lý do đằng sau thực sự rất cơ bản: khả năng mở rộng của tính toán tổng quát đã gần như tới đỉnh điểm. Và một cách tăng hiệu suất—không phải là cách duy nhất, nhưng là một cách quan trọng—đó là tạo ra các công cụ tăng tốc đặc biệt trong lĩnh vực cụ thể.
Chúng tôi bắt đầu với đồ họa máy tính, nhưng cũng có rất nhiều lĩnh vực khác. Ví dụ như các tính toán khoa học, vật lý hạt, mô phỏng dòng chảy, xử lý dữ liệu có cấu trúc và nhiều thứ khác, nhiều loại thuật toán khác nhau sẽ hưởng lợi từ CUDA.
Do đó, sứ mệnh của chúng tôi luôn là mang tính toán tăng tốc đến thế giới này, thúc đẩy các ứng dụng không thể được tính toán tổng quát thực hiện, hoặc không thể mở rộng đến mức độ hiệu suất cần thiết, tiếp tục phát triển, giúp các lĩnh vực khoa học đạt được bước đột phá. Các ứng dụng sớm nhất của chúng tôi gồm có động lực học phân tử, xử lý địa chấn trong khai thác năng lượng, và đương nhiên là xử lý hình ảnh.
Tất cả những lĩnh vực này, tính toán tổng quát đều không hiệu quả. Do đó, có thể nói rằng, nếu không có AI, tôi sẽ cảm thấy tiếc nuối. Nhưng chính vì sự tiến bộ về tính toán, chúng tôi đã làm cho Học sâu trở nên dân chủ hóa. Chúng tôi đã cho phép bất kỳ nhà nghiên cứu nào, bất kỳ nhà khoa học nào, bất kỳ sinh viên nào, ở bất kỳ nơi nào, đều có thể sử dụng một máy tính cá nhân, hoặc một card đồ hoạ GeForce, để thực hiện nghiên cứu khoa học đáng kinh ngạc. Và cam kết cơ bản nhất này, chưa bao giờ thay đổi, không chút nào.
Vì vậy, nếu bạn tham dự Hội nghị GTC, bạn sẽ nhận thấy rằng một phần lớn nội dung ban đầu thực sự không phải là AI. Dù đó là tính toán quang, hóa học lượng tử, hoặc xử lý dữ liệu, những điều đó không liên quan đến AI, nhưng vẫn rất quan trọng. Tôi biết rằng AI thú vị và hứng thú.
Nhưng vẫn còn rất nhiều người đang thực hiện công việc quan trọng mà không liên quan đến AI. Tensor không phải là phương thức tính toán duy nhất của họ. Và chúng tôi hy vọng có thể giúp đỡ tất cả những người đó.
Dwarkesh Patel:
Jensen, cảm ơn bạn rất nhiều.
Jensen Huang:
Không có gì, tôi rất thích cuộc trò chuyện lần này.
[Link gốc]
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan