Dữ liệu là tài sản: DataFi đang mở ra cơ hội phát triển mới
原文标题:《数据即资产:DataFi 正在开启新蓝海》
原文作者:anci_hu49074,Biteye 核心贡献者
「Chúng ta đang sống trong thời đại mà toàn cầu đang cạnh tranh xây dựng mô hình cơ sở tốt nhất. Mặc dù khả năng tính toán và kiến trúc mô hình quan trọng, nhưng bức tường thực sự là dữ liệu huấn luyện」
——Sandeep Chinchali, Chủ tịch AI chính của Story
Từ Scale AI, Thảo luận về Tiềm năng của Đường đua Dữ liệu AI
Để nói về trò chuyện lớn nhất trong cộng đồng AI trong tháng này, không gì bằng việc Meta thể hiện sức mạnh tài chính, với việc Mark Zuckerberg đang tìm kiếm tài năng và huy động một đội ngũ quyền lực của Meta AI tập trung chủ yếu vào các nhà nghiên cứu khoa học người Trung Quốc. Người dẫn đầu chính là Alexander Wang, 28 tuổi chỉ, người sáng lập Scale AI. Anh ấy đã tạo ra Scale AI từ đầu, hiện đang được định giá 290 tỷ đô la Mỹ, phục vụ không chỉ quân đội Mỹ mà còn các khổng lồ AI cạnh tranh như OpenAI, Anthropic, Meta và nhiều công ty khác, tất cả phải phụ thuộc vào dịch vụ dữ liệu mà Scale AI cung cấp, và dịch vụ cốt lõi của Scale AI chính là cung cấp dữ liệu được gắn nhãn chính xác lớn.
Tại sao Scale AI có thể nổi bật từ hàng loạt "con ngựa đơn sừng"?
Lý do là họ sớm nhận ra tầm quan trọng của dữ liệu trong ngành công nghiệp AI.
Khả năng tính toán, mô hình, và dữ liệu là ba trụ cột của mô hình AI. Nếu xem mô hình lớn như một con người, thì mô hình là cơ thể, sức mạnh tính toán là thức ăn, và dữ liệu, chính là tri thức/thông tin.
Trên quãng thời gian từ sự nổi lên của LLM đến nay, điểm tập trung của ngành đã trải qua sự chuyển đổi từ mô hình sang sức mạnh tính toán, hiện nay hầu hết các mô hình đã xác định transformer làm khung mô hình, đôi khi đổi mới với MoE hoặc MoRe và các kiến trúc khác; các gigant cường quốc đã xây dựng siêu cụm cảm lực để hoàn thành bức tường sức mạnh tính toán hoặc ký kết hợp đồng dài hạn với các dịch vụ đám mây mạnh mẽ như AWS; sau khi giải quyết cơ bản về sức mạnh tính toán, tầm quan trọng của dữ liệu dần trở nên rõ rệt.
Khác với các công ty lớn To B dữ liệu truyền thống như Palantir nổi tiếng trên thị trường hai cấp, công ty Scale AI như tên của nó, cam kết xây dựng cơ sở dữ liệu vững chắc cho mô hình AI, hoạt động của họ không chỉ dừng lại ở việc khai thác dữ liệu hiện có, mà còn mở rộng tầm nhìn đến kinh doanh tạo ra dữ liệu hơn, và cố gắng thông qua AI trainer team bao gồm chuyên gia chuyên môn từ nhiều lĩnh vực, cung cấp dữ liệu huấn luyện chất lượng hơn cho mô hình AI.
Nếu bạn không quan tâm đến doanh nghiệp này, chúng ta hãy xem xét trước mô hình được huấn luyện như thế nào.
Quá trình huấn luyện mô hình chia thành hai phần — huấn luyện trước và điều chỉnh fein.
Trong phần huấn luyện trước, một chút giống như quá trình trẻ em con người học nói, thông thường chúng ta cần cung cấp cho mô hình AI một lượng lớn văn bản, mã nguồn, và thông tin khác từ việc thu thập dữ liệu mạng, mô hình thông qua việc tự học từ những thông tin này, học được ngôn ngữ tự nhiên, có khả năng giao tiếp cơ bản.
Phần điều chỉnh fine-tuning, giống như việc đi học ở trường, thông thường có câu trả lời rõ ràng, phương án và hướng đi. Nhà trường sẽ phát triển học sinh thành các loại tài năng khác nhau dựa trên vị thế của họ. Chúng ta cũng sẽ thông qua một số tập dữ liệu được chuẩn bị trước, chuyên biệt, huấn luyện mô hình để có khả năng mà chúng ta mong muốn.
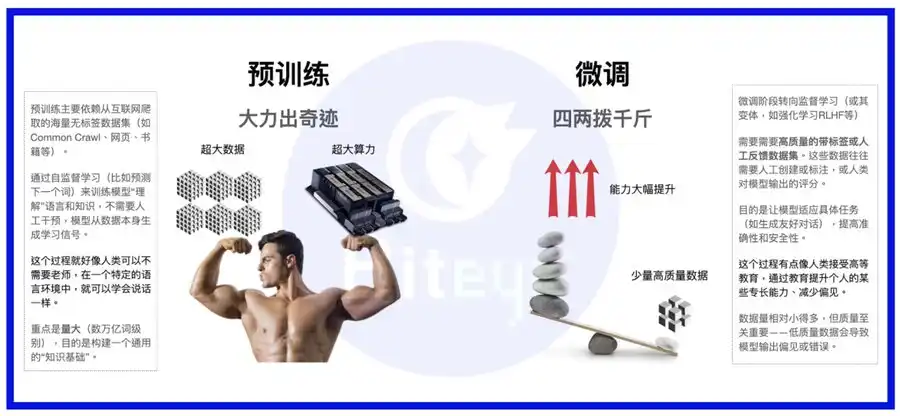
Đến đây, bạn có lẽ đã hiểu rằng chúng ta cần dữ liệu được chia thành hai phần.
· Một phần dữ liệu không cần qua quá nhiều xử lý, đủ lớn là đủ, thông thường đến từ các nguồn như Reddit, Twitter, Github, dữ liệu web crawler từ các nền tảng UGC lớn, cơ sở dữ liệu tài liệu công khai, cơ sở dữ liệu riêng của doanh nghiệp, v.v.
· Phần còn lại, giống như sách giáo trình chuyên ngành, cần thiết kế và lựa chọn cẩn thận, đảm bảo có khả năng phát triển các phẩm chất đặc biệt của mô hình, điều này yêu cầu chúng ta thực hiện một số công việc cần thiết như làm sạch dữ liệu, lựa chọn, gắn nhãn, phản hồi của con người, v.v.
Hai phần tập dữ liệu này cấu thành phần chính của hệ thống AI Data. Đừng coi thường những tập dữ liệu dường như không có nhiều giá trị kỹ thuật, quan điểm phổ biến hiện nay cho rằng, với việc Sự mất ưu thế của sức mạnh tính toán trong Scaling laws, dữ liệu sẽ trở thành hệ số chống chọi quan trọng nhất giữa các nhà sản xuất mô hình lớn khác nhau.
Với việc mô hình ngày càng được nâng cao, mọi loại dữ liệu huấn luyện chuyên sâu, chuyên sâu sẽ trở thành yếu tố biến đổi chính về khả năng của mô hình. Nếu chúng ta đưa việc huấn luyện mô hình như việc phát triển võ công của võ sư, thì tập dữ liệu chất lượng cao chính là bí kíp võ công tốt nhất (để hoàn thiện phong cách miêu tả này, bạn cũng có thể nói sức mạnh tính toán là thuốc Đan Tâm, mô hình là bản chất) của chính mình).
Xem theo chiều dọc, AI Data cũng là một loại chạy dài mang tính chiến lược, cùng với sự tích luỹ của công việc đầu tiên, tài sản dữ liệu cũng sẽ có khả năng chất lượng gia tăng, già càng càng trở nên có giá trị.
Web3 DataFi: Thổ Nhưỡng AI Data
So với đội ngũ gắn nhãn từ xa hàng trăm nghìn người ở Philippines, Venezuela mà Scale AI đã xây dựng, Web3 có lợi thế tự nhiên trong lĩnh vực dữ liệu AI, và cụm từ DataFi mới cũng ra đời theo đó.
Trong trường hợp lý tưởng, các lợi thế của Web3 DataFi như sau:
1. Chủ quyền dữ liệu, bảo mật và riêng tư được bảo vệ bởi hợp đồng thông minh
Trong giai đoạn dữ liệu công khai hiện có sắp cạn kiệt, làm cách nào để tiếp tục khai thác dữ liệu không công bố, thậm chí là dữ liệu riêng tư, là một hướng đi quan trọng để mở rộng nguồn dữ liệu. Điều này đặt ra vấn đề lựa chọn uy tín — bạn chọn bán dữ liệu của mình cho một tập đoàn trung ương thông qua một hợp đồng mua bán, hay bạn chọn cách tiếp tục nắm giữ quyền sở hữu dữ liệu của mình trên chuỗi khối, đồng thời còn có thể thông qua hợp đồng thông minh hiểu rõ ràng: dữ liệu của bạn sẽ được ai, lúc nào và với mục đích gì sử dụng.
Đồng thời, đối với thông tin nhạy cảm, còn có thể thông qua các phương thức như zk, TEE và cách khác, đảm bảo rằng dữ liệu riêng tư của bạn chỉ được máy móc giữ kín miệng và không bị rò rỉ.
2. Lợi thế tự nhiên về cơ hội nơi địa lý: Cơ sở phân tán tự do, thu hút sức lao động phù hợp nhất
Có lẽ đã đến lúc thách thức mối quan hệ sản xuất lao động truyền thống. Thay vì tìm kiếm sức lao động giá rẻ trên toàn thế giới như Scale AI, tại sao không tận dụng tính phân tán của chuỗi khối, và thông qua các biện pháp khuyến khích công khai, minh bạch được bảo vệ bởi hợp đồng thông minh, để cho phép sức lao động rải rác trên toàn thế giới tham gia vào việc đóng góp dữ liệu.
Đối với công việc gắn nhãn dữ liệu, đánh giá mô hình và các công việc tốn sức lao động khác, so với việc xây dựng một cách trung ương nhưng hình thành nhà máy dữ liệu, việc sử dụng cách thức của Web3 DataFi còn giúp cho sự đa dạng của người tham gia, điều này đối với việc tránh thiên nghiệm dữ liệu cũng có ý nghĩa lâu dài.
3. Lợi thế cụ thể về khuyến khích và giải quyết trên chuỗi khối
Làm thế nào để tránh bi kịch kiểu "Nhà máy giày da Jiangnan"? Rõ ràng là sử dụng hệ thống khuyến khích của hợp đồng thông minh, thay vì sự tối tâm con người.
Trong bối cảnh toàn cầu hóa không thể tránh khỏi, làm thế nào để tiếp tục thực hiện cơ hội tận dụng địa lý giá thấp? Sáng lập công ty trên toàn cầu trở nên khó khăn hơn, vậy tại sao không tránh qua rào cản của thế giới cũ, và hướng đến cách thức giải quyết trên chuỗi khối.
4. Hỗ trợ xây dựng thị trường dữ liệu "một cửa hàng" hiệu quả hơn, mở cửa hơn
"Người trung gian lợi nhuận khác biệt" là nỗi đau không bao giờ kết thúc đối với cả cung và cầu, thay vì để một công ty dữ liệu trung ương đóng vai trò người trung gian, hãy tạo ra một nền tảng trên chuỗi, thông qua một thị trường công bằng như taobao, để hai bên cung và cầu dữ liệu có thể kết nối một cách minh bạch, hiệu quả hơn.
Với sự phát triển của hệ sinh thái trí tuệ nhân tạo trên chuỗi, nhu cầu dữ liệu trên chuỗi sẽ trở nên cao hơn, chi tiết hơn và đa dạng hơn, chỉ có thị trường phi tâm trung mới có thể hiệu quả hấp thụ nhu cầu này và chuyển đổi nó thành sự thịnh vượng của hệ sinh thái.
Đối với người tiêu dùng cuối, DataFi cũng là dự án trí tuệ nhân tạo phi tâm trung phù hợp nhất cho người dùng thông thường.
Mặc dù sự xuất hiện của các công cụ trí tuệ nhân tạo đã giảm thiểu mức độ khó khăn trong việc học hỏi, và mục đích ban đầu của trí tuệ nhân tạo phi tâm trung cũng là phá vỡ cấu trúc thống trị của các tập đoàn lớn hiện tại trong lĩnh vực trí tuệ nhân tạo; nhưng chúng ta phải nhận ra, nhiều dự án hiện tại đối với người tiêu dùng thông thường không hề dễ tham gia — việc tham gia khai thác mạng lực lượng tính toán phi tâm trung thường đi kèm với việc đầu tư ban đầu đắt đỏ vào phần cứng, và rào cản công nghệ của thị trường mô hình thường khiến người tham gia thông thường dễ chùn bước.
So với điều đó, đó là một trong số ít cơ hội mà người dùng thông thường có thể nắm bắt trong cuộc cách mạng trí tuệ nhân tạo — Web3 giúp bạn không cần ký kết một hợp đồng công việc dữ liệu như nhà máy máu dữ liệu, chỉ cần đăng nhập ví tiền bằng một cú nhấp chuột, bạn có thể tham gia bằng cách hoàn thành các nhiệm vụ đơn giản như: cung cấp dữ liệu, đánh giá mô hình dựa trên trực giác và bản năng con người, hoặc thậm chí sử dụng các công cụ trí tuệ nhân tạo để thực hiện một số công việc sáng tạo đơn giản, tham gia giao dịch dữ liệu, v.v. Đối với những người có kinh nghiệm chơi xấu, mức độ khó khăn gần như bằng không.
Dự án tiềm năng của Web3 DataFi
Tiền đi đâu, hướng sẽ ở đó. Ngoài việc Scale AI của thế giới Web2 nhận đầu tư 143 tỷ USD từ Meta và cổ phiếu của Palantir tăng 5 lần trong một năm, trong lĩnh vực tài trợ Web3, hiệu suất của DataFi cũng rất ấn tượng. Ở đây, chúng tôi sẽ giới thiệu ngắn gọn về những dự án này.
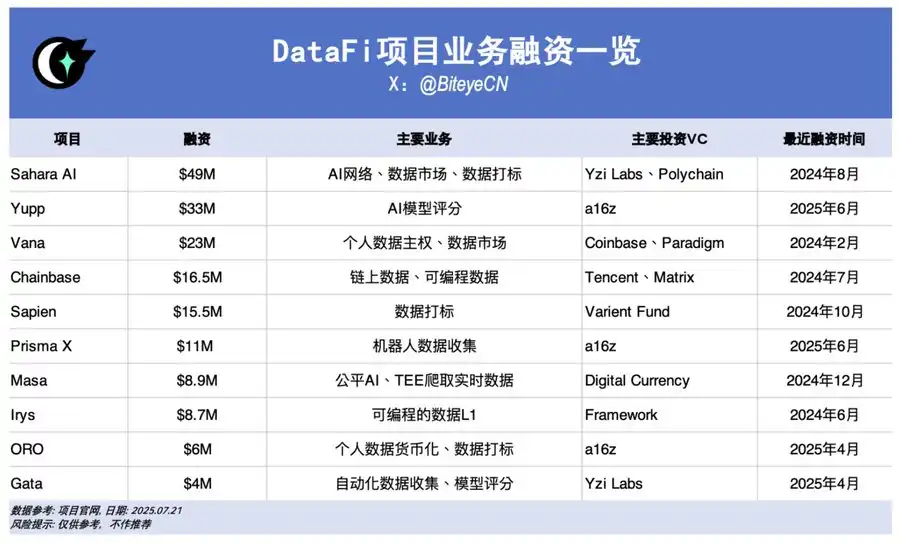
Sahara AI, @SaharaLabsAI, Tài trợ 49 triệu USD
Mục tiêu cuối cùng của Sahara AI là xây dựng cơ sở hạ tầng siêu trí tuệ nhân tạo phi tâm trung và thị trường giao dịch, phần đầu tiên mà họ thử nghiệm là Dữ liệu AI, phiên bản thử nghiệm công khai của nền tảng DSP (Data Services Platform, nền tảng dịch vụ dữ liệu) sẽ được phát hành vào ngày 22 tháng 7, người dùng có thể nhận được thưởng token bằng cách đóng góp dữ liệu, tham gia các nhiệm vụ như gán nhãn dữ liệu.
Liên kết: app.saharaai.com
Yupp, @yupp_ai, Tài trợ 33 triệu USD
Yupp là một nền tảng phản hồi mô hình trí tuệ nhân tạo, chủ yếu thu thập phản hồi từ người dùng về nội dung đầu ra của mô hình. Nhiệm vụ chính hiện tại là người dùng so sánh đầu ra của các mô hình khác nhau cho cùng một đầu vào, sau đó chọn ra mô hình họ cho là tốt nhất. Hoàn thành nhiệm vụ có thể nhận điểm Yupp, các điểm Yupp có thể được quy đổi thành USDC và các loại stablecoin khác.
Liên kết: https://yupp.ai/
Vana, @vana, Gọi vốn 23 triệu USD
Vana tập trung vào việc chuyển đổi dữ liệu cá nhân của người dùng (như hoạt động trên mạng xã hội, lịch sử duyệt web, v.v.) thành tài sản kỹ thuật số có thể tiền mã hóa. Người dùng có thể ủy quyền tải lên dữ liệu cá nhân của họ vào Pool DLP tương ứng trong DataDAOs, dữ liệu này sẽ được tổng hợp và sử dụng cho việc huấn luyện mô hình AI và các nhiệm vụ khác, người dùng cũng sẽ nhận được phần thưởng token tương ứng.
Liên kết: https://www.vana.org/collectives
Chainbase, @ChainbaseHQ, Gọi vốn 16,5 triệu USD
Chainbase tập trung vào dữ liệu trên chuỗi, hiện đã bao phủ hơn 200 chuỗi khối, chuyển hoạt động trên chuỗi thành dữ liệu cấu trúc, có thể xác minh và tiền mã hóa, cung cấp cho việc phát triển ứng dụng phi tập trung. Chainbase chủ yếu thu thập dữ liệu thông qua các phương tiện như chỉ mục đa chuỗi và xử lý dữ liệu thông qua hệ thống Manuscript và mô hình AI Theia của mình, hiện người dùng thông thường có độ tham gia không cao.
Sapien, @JoinSapien, Gọi vốn 15,5 triệu USD
Mục tiêu của Sapien là chuyển đổi kiến thức nhân loại thành dữ liệu đào tạo AI chất lượng cao trên quy mô lớn, bất kỳ ai cũng có thể tham gia gán nhãn dữ liệu trên nền tảng và thông qua xác minh đồng nghiệm, đảm bảo chất lượng dữ liệu. Đồng thời khuyến khích người dùng xây dựng uy tín dài hạn hoặc cam kết thông qua giao kèo, kiếm thêm phần thưởng.
Liên kết: https://earn.sapien.io/#hiw
Prisma X, @PrismaXai, Gọi vốn 11 triệu USD
Prisma X muốn trở thành lớp phối hợp mở cửa của robot, trong đó việc thu thập dữ liệu vật lý là rất quan trọng. Dự án này hiện đang ở giai đoạn sớm, dựa vào bài báo gần đây được công bố, có thể suy luận được các cách tham gia như đầu tư thu thập dữ liệu của robot, vận hành dữ liệu của robot từ xa, v.v. Hiện có hoạt động quiz dựa trên bài báo mở cửa, có thể tham gia để kiếm điểm.
Liên kết: https://app.prismax.ai/whitepaper
Masa, @getmasafi, Gọi vốn 8,9 triệu USD
Masa là một trong những dự án con hàng đầu của hệ sinh thái Bittensor, hiện đang điều hành mạng con dữ liệu số 42 và mạng con Agent số 59. Mạng con dữ liệu nhằm cung cấp truy cập dữ liệu thời gian thực, hiện chủ yếu là các thợ đào thông qua phần cứng TEE thu thập dữ liệu thời gian thực trên X/Twitter, đối với người dùng thông thường, mức độ tham gia và chi phí đều khá cao.
Irys,@irys_xyz,Quỹ vốn 870 triệu USD
Irys tập trung vào lưu trữ và tính toán dữ liệu có thể lập trình, nhằm cung cấp giải pháp hiệu quả, chi phí thấp cho trí tuệ nhân tạo (AI), ứng dụng phi tâm trung (dApps) và các ứng dụng tập trung dữ liệu khác. Ở mặt động góp dữ liệu, hiện tại người dùng thông thường có ít cơ hội tham gia, nhưng trong giai đoạn thử nghiệm mạng hiện tại, có nhiều hoạt động mà họ có thể tham gia.
Liên kết: https://bitomokx.irys.xyz/
ORO,@getoro_xyz,Quỹ vốn 600 triệu USD
ORO muốn tạo điều kiện cho người dân tham gia đóng góp vào trí tuệ nhân tạo. Cách hỗ trợ bao gồm: 1. Liên kết tài khoản cá nhân để đóng góp dữ liệu cá nhân, bao gồm tài khoản mạng xã hội, dữ liệu sức khỏe, tài khoản thương mại điện tử và tài chính; 2. Hoàn thành nhiệm vụ dữ liệu. Hiện tại, mạng thử nghiệm đã được triển khai và mọi người có thể tham gia.
Liên kết: app.getoro.xyz
Gata,@Gata_xyz,Quỹ vốn 400 triệu USD
Định vị là lớp dữ liệu phi tâm trung, Gata hiện đã ra mắt ba sản phẩm chính tham gia: 1. Đại lý Dữ liệu: Một loạt các AI Agent chỉ cần người dùng mở trang web để tự động xử lý dữ liệu; 2. Trò chuyện Tất cả trong một: Cơ chế đánh giá mô hình tương tự Yupp để kiếm thưởng; 3. GPT-to-Earn: Tiện ích trình duyệt, thu thập dữ liệu trò chuyện của người dùng trên ChatGPT.
Liên kết: https://app.gata.xyz/dataAgent
https://chromewebstore.google.com/detail/hhibbomloleicghkgmldapmghagagfao?utm_source=item-share-cb
Ý kiến về các dự án hiện tại?
Ở mức độ hiện tại, rào cản của các dự án này nói chung không cao, nhưng phải thừa nhận rằng, một khi tích lũy được người dùng và tính kết dính sinh thái, ưu thế nền tảng sẽ nhanh chóng tích tụ, do đó, ở giai đoạn sớm, phải tập trung vào biện pháp khuyến khích, trải nghiệm người dùng để thu hút đủ người dùng mới có thể thực hiện được thương vụ dữ liệu lớn này.
Tuy nhiên, là các dự án tập trung vào lao động, các nền tảng dữ liệu này cần xem xét cách quản lý lao động, đảm bảo chất lượng đầu ra dữ liệu. Cuối cùng, như là tình trạng chung của nhiều dự án trên Web3 — hầu hết người dùng trên nền tảng chỉ là những người tham lam không biết mình, họ thường hy sinh chất lượng vì lợi ích ngắn hạn, nếu để họ trở thành người dùng chính trên nền tảng, sẽ tạo điều kiện cho tiền tệ xấu mạnh hơn tiền tệ tốt, cuối cùng làm cho chất lượng dữ liệu không được bảo đảm và không thể thu hút người mua. Hiện nay, chúng ta đã thấy các dự án như Sahara, Sapien đều đã nhấn mạnh về chất lượng dữ liệu, nỗ lực thiết lập mối quan hệ hợp tác lâu dài, lành mạnh với lao động trên nền tảng của mình.
Ngoài ra, sự không minh bạch đang là một vấn đề khác của các dự án trên chuỗi hiện nay. Đúng là tam giác không thể của blockchain đã khiến cho nhiều dự án ở giai đoạn khởi đầu chỉ có thể đi theo một con đường "tích hợp tới phi tập trung". Nhưng hiện nay, ngày càng nhiều dự án trên chuỗi mang đến cảm giác giống như là "dự án cũ của Web2 mặc áo Web3" — dữ liệu công khai trên chuỗi có thể theo dõi được rất ít, thậm chí trên bản đồ chiến lược cũng hiếm khi thấy sự quyết tâm công khai, minh bạch dài hạn. Điều này không thể phủ nhận là độc hại đối với sự phát triển bền vững của Web3 DataFi, chúng tôi cũng hy vọng nhiều dự án sẽ giữ vững niềm tin ban đầu, tăng tốc độ minh bạch, mở cửa.
Một điểm cuối cùng, con đường tiếp cận hàng đầu của DataFi cũng cần phải xem xét hai phần: một phần là thu hút đủ số lượng đối tác toC tham gia vào mạng lưới này, tạo nên lực lượng lao động sản xuất/nhận dạng dữ liệu, người tiêu dùng của nền kinh tế trí tuệ nhân tạo, hình thành một hệ sinh thái đóng vòng; phần còn lại là được công nhận bởi các công ty lớn to B thịnh hành hiện tại, cuối cùng họ mới là nguồn cung chính của các đơn hàng dữ liệu trong tương lai ngắn hạn. Về phần này, chúng tôi cũng thấy rằng Sahara AI, Vana, v.v. đã đạt được tiến triển khá tích cực.
Kết
Một cách nhìn về số phận, DataFi đang sử dụng trí tuệ nhân loại để nuôi dưỡng trí tuệ máy móc lâu dài, đồng thời sử dụng hợp đồng thông minh như một bảo hiểm, bảo vệ việc lao động của trí tuệ nhân loại mang lại lợi ích, và cuối cùng được hưởng lợi từ trí tuệ máy móc.
Nếu bạn đang lo âu với sự không chắc chắn của thời đại trí tuệ nhân tạo, nếu bạn vẫn ôm trọn lý tưởng blockchain giữa những sóng gió của thị trường tiền điện tử, thì theo bước chân của bạn bè tài chính lớn, tham gia vào DataFi không phải là một lựa chọn tồi.
Bài viết được đóng góp, không thể hiện quan điểm của BlockBeats.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan