Dự Báo Sáng Tạo Hợp Tác Anthropic: Trước năm 2028, phát triển trí tuệ nhân tạo sẽ không còn cần sự tham gia của con người
Tiêu đề bản gốc: Import AI 455: Các hệ thống AI sắp sửa tự xây dựng.
Dịch bản gốc: Jack Clark, Cofounder của Anthropic
Dịch bản gốc: Dịch bởi Yang Wen và Chen Chen, Mạch Trí
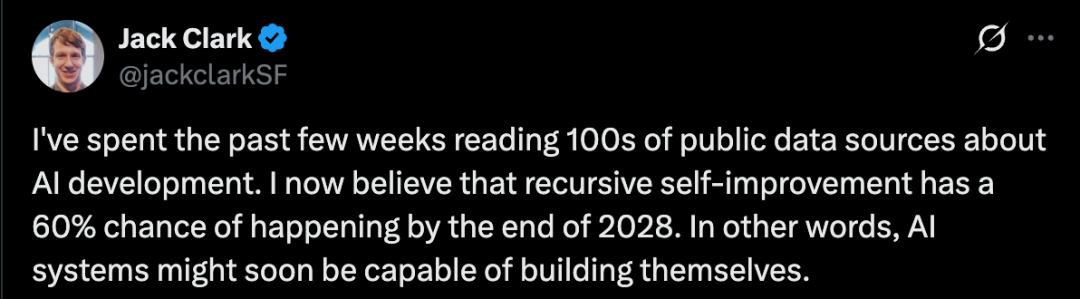
Quan điểm này không phải là một điều bất khả thi. Ông đã xem xét một loạt các tiêu chí chuẩn công khai và phát hiện rằng trong các nhiệm vụ nghiên cứu AI, AI đang tiến triển rất nhanh.
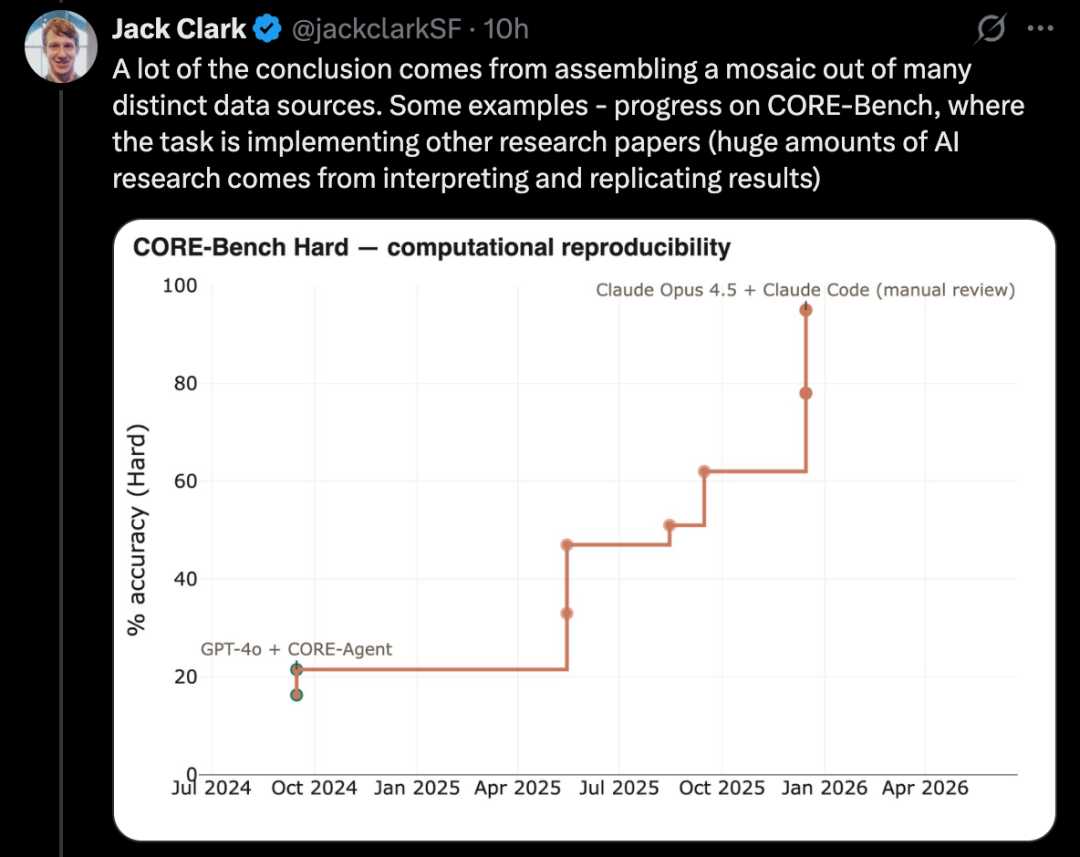
Ví dụ, CORE-Bench xem xét khả năng của AI để thực hiện công việc nghiên cứu của người khác, điều này rất quan trọng trong nghiên cứu AI.
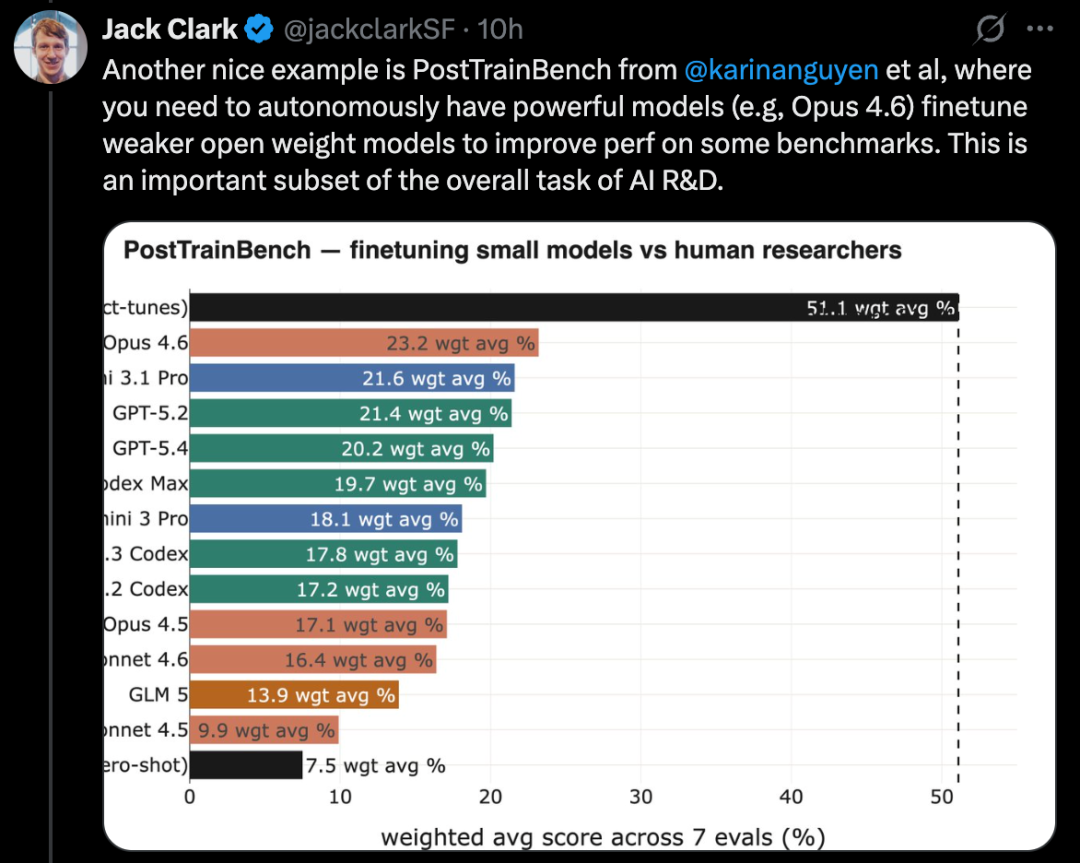
PostTrainBench kiểm tra xem mô hình mạnh có thể tự điều chỉnh mô hình mã nguồn mở yếu để cải thiện hiệu suất không, đây chính là một phần quan trọng của quá trình phát triển AI.
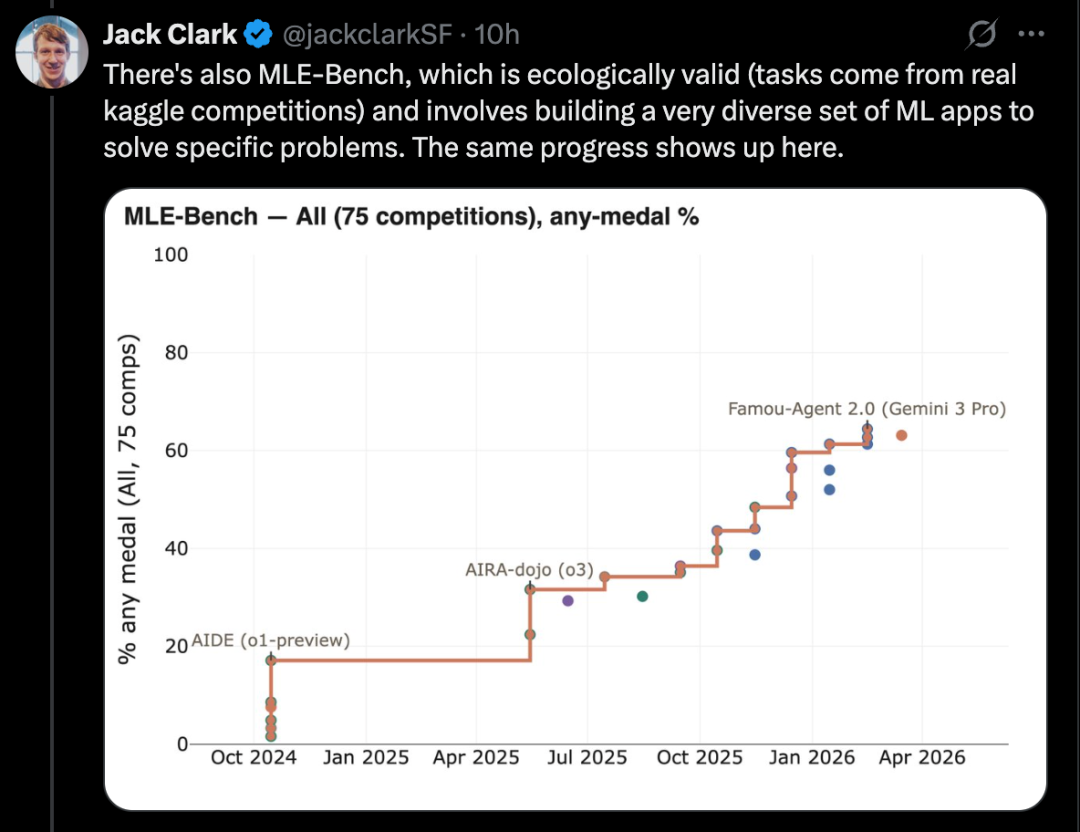
MLE-Bench dựa trên các nhiệm vụ thực tế từ các cuộc thi Kaggle, yêu cầu xây dựng ứng dụng học máy đa dạng để giải quyết vấn đề cụ thể. Ngoài ra, các chuẩn mã như SWE-Bench cũng đã thể hiện sự tiến triển tương tự.
Jack Clark mô tả hiện tượng này như một xu hướng hình học tự tương tự, tức là tại các phân giải và quy mô khác nhau, ta có thể quan sát được sự tiến triển ý nghĩa. Ông tin rằng AI đang dần tiến gần tới khả năng tự động hóa nghiên cứu từ đầu đến cuối, và khi điều này thành hiện thực, AI sẽ có khả năng tự xây dựng các hệ thống kế nhiệm của chính nó, bắt đầu vòng lặp tái tạo tự động.
Một khi câu nói này được đưa ra, đã tạo ra nhiều cuộc trò chuyện trên mạng xã hội.
Một số người coi đây là bước quan trọng đầu tiên đưa chúng ta đến ASI và Singularity, có thể thay đổi hoàn toàn nhịp độ phát triển công nghệ.

Tuy nhiên, không phải ai cũng đồng tình.
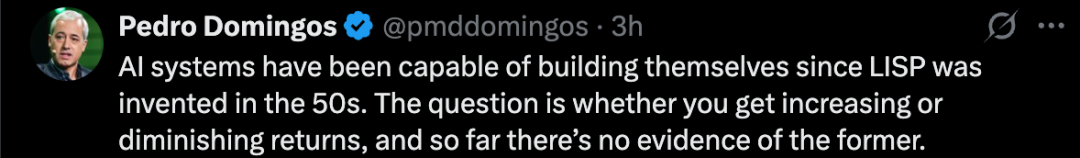
Giáo sư Khoa học Máy Tính tại Đại học Washington Pedro Domingos lưu ý rằng các hệ thống AI đã có khả năng "xây dựng chính mình" ngay từ khi ngôn ngữ LISP được phát minh vào những năm 50 của thế kỷ trước. Vấn đề thực sự là liệu có thể có được lợi nhuận tăng dần không, và hiện tại không có bằng chứng rõ ràng nào hỗ trợ điều này.
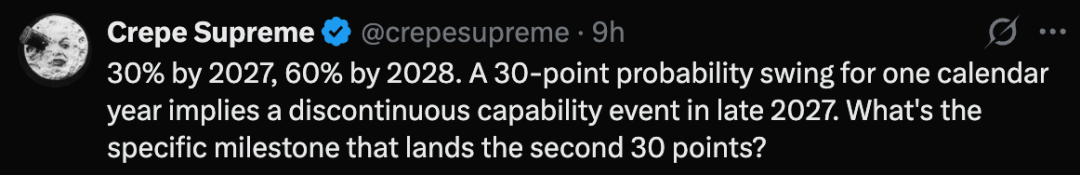
Một số người dùng mạng đã đặt câu hỏi rằng từ năm 2027 đến năm 2028, xác suất tăng lên đột ngột 30%, điều này ngụ ý rằng khả năng AI sẽ có một bước tiến lớn vào cuối năm 2027. Về cụ thể là cột mốc hoặc sự kiện nào có thể khiến khả năng AI tự tái cấu trúc đột ngột tăng mạnh trong thời gian ngắn?
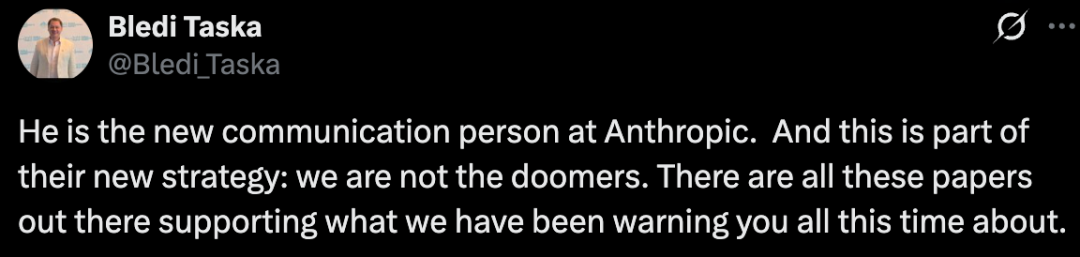
Cũng có người dùng mạng cho biết rằng Jack Clark là người phụ trách quan hệ công chúng vừa mới nhậm chức tại Anthropic, điều này chính là một phần của chiến lược mới của họ: Chúng tôi không phải là những kẻ rợn người, có rất nhiều bài luận xác nhận những điều chúng tôi luôn cảnh báo các bạn.
Jack Clark đặc biệt đã viết một bài dài trong bản tin Import AI số 455 để giải thích chi tiết.
Tiếp theo, chúng ta sẽ đọc toàn bộ bài viết này.
Hệ thống AI sẽ bắt đầu tự xây dựng, điều này có ý nghĩa gì?
Clark cho biết rằng, anh viết bài này vì sau khi tổng hợp tất cả thông tin công khai có sẵn, anh phải đưa ra một quyết định không hề dễ dàng: Trước cuối năm 2028, khả năng xuất hiện nghiên cứu AI không cần sự tham gia của con người đã khá cao, có thể vượt quá 60%.
Trong trường hợp nghiên cứu AI không cần sự tham gia của con người, đó là một loại hệ thống AI mạnh mẽ đến mức không chỉ hỗ trợ con người trong nghiên cứu mà còn có thể tự động hoàn thành quy trình nghiên cứu chính yếu và thậm chí xây dựng thế hệ tiếp theo của chính nó.
Theo Clark, điều này rõ ràng là một sự kiện quan trọng.
Ông thú nhận rằng, anh cũng khó lòng tiếp thu hoàn toàn ý nghĩa của sự kiện này.
Lý do Clark gọi đây là một quyết định không hề muốn, là vì ảnh hưởng sau đằng đấy quá lớn, khiến anh cảm thấy khó khăn. Clark cũng không chắc chắn liệu xã hội đã sẵn sàng để đối mặt với sự thay đổi sâu rộng mà tự động hóa nghiên cứu AI đem lại.
Ông hiện tin rằng, con người có lẽ đang sống trong một thời điểm đặc biệt: Nghiên cứu AI sẽ sớm bị tự động hóa toàn diện. Nếu khoảnh khắc này thực sự đến, con người sẽ như đã vượt qua sông Lu-bi-không, bước vào một tương lai gần như không thể dự đoán.
Clark cho biết, mục đích của bài viết này là để giải thích vì sao anh tin rằng, quá trình phát triển tự động hoàn toàn của nghiên cứu AI đang diễn ra.
Anh ấy sẽ thảo luận về một số hậu quả mà xu hướng này có thể mang lại, nhưng hầu hết bài viết sẽ tập trung vào bằng chứng hỗ trợ cho sự quyết định này. Đối với những ảnh hưởng sâu sắc hơn, Clark dự định sẽ tiếp tục làm rõ trong phần lớn thời gian của năm nay.
Về mặt thời gian, Clark không nghĩ rằng vấn đề này sẽ xảy ra vào năm 2026 thực sự. Nhưng anh ấy tin rằng, trong một hoặc hai năm tới, chúng ta có thể thấy một số trường hợp của việc mô hình nào đó từ đầu đến cuối huấn luyện bản thân. Ít nhất ở mức độ không phải là mô hình hàng đầu, việc xuất hiện một minh chứng khái niệm là rất có khả năng; còn đối với các mô hình hàng đầu nhất, mức độ khó khăn sẽ cao hơn, bởi vì chúng quá đắt đỏ và phụ thuộc vào sự làm việc cực kỳ căng thẳng của một lượng lớn các nhà nghiên cứu con người.
Nhận định của Clark chủ yếu dựa trên thông tin công khai: bao gồm các bài báo trên arXiv, bioRxiv và NBER, cũng như các sản phẩm đã được triển khai vào thế giới thực của các công ty AI hàng đầu. Dựa trên thông tin này, anh ấy kết luận một điều: các yếu tố cần thiết cho việc sản xuất tự động các hệ thống AI hiện tại đã được thiết lập, đặc biệt là các thành phần kỹ thuật trong quá trình phát triển AI.
Nếu xu hướng scaling tiếp tục, chúng ta nên bắt đầu chuẩn bị cho tình huống sau: mô hình sẽ trở nên đủ sáng tạo, không chỉ có khả năng tự động cải tiến các phương pháp đã biết mà còn có thể thay thế các nhà nghiên cứu con người trong việc đề xuất hướng nghiên cứu mới và ý tưởng sáng tạo, từ đó tự đẩy mạnh cho việc phát triển tiếp tục của AI ở phía trước.
Chấm Dứt Lập Trình: Sự Thay Đổi Năng Lực Theo Thời Gian
Hệ thống AI được thực hiện thông qua phần mềm, và phần mềm bao gồm mã nguồn.
Hệ thống AI đã thay đổi hoàn toàn cách tạo ra mã. Đằng sau điều này có hai xu hướng liên quan: một mặt, hệ thống AI ngày càng giỏi trong việc viết mã phức tạp trong thế giới thực; mặt khác, hệ thống AI cũng ngày càng giỏi trong việc liên kết nhiều nhiệm vụ lập trình tuyến tính mà gần như không cần sự giám sát của con người, chẳng hạn như việc viết mã trước sau đó tiến hành kiểm thử.
Hai ví dụ điển hình thể hiện xu hướng này là SWE-Bench và METR time horizons plot.
Giải Quyết Vấn Đề Kỹ Thuật Phần Mềm trong Thế Giới Thực
SWE-Bench là một bài kiểm tra lập trình được sử dụng rộng rãi, dùng để đánh giá khả năng của hệ thống AI giải quyết vấn đề thực tế trên GitHub.
Khi SWE-Bench được ra mắt vào cuối năm 2023, mô hình hiện thời表 hiện tốt nhất là Claude 2, tỷ lệ thành công tổng thể khoảng 2%. Trong khi điểm số của Claude Mythos Preview đã đạt được 93,9%, gần như đạt điểm tối đa trên bài kiểm tra này.
Tất nhiên, mọi bộ test đều có một mức độ nhiễu nhất định, vì vậy thường sẽ có một giai đoạn như sau: khi điểm số đạt đến một mức độ nào đó, bạn có thể sẽ không gặp phải hạn chế của phương pháp nữa mà là hạn chế của bản thân bộ test. Ví dụ, trên tập dữ liệu validation của ImageNet, khoảng 6% nhãn là không chính xác hoặc mơ hồ.
SWE-Bench có thể được xem như là một chỉ số đáng tin cậy để đánh giá khả năng lập trình chung và tác động của trí tuệ nhân tạo đối với kỹ thuật phần mềm. Clark cho biết, hầu hết mọi người mà anh ta đã gặp ở các phòng thí nghiệm trí tuệ nhân tạo hàng đầu và ở Silicon Valley, hiện nay đều đã sử dụng hệ thống trí tuệ nhân tạo hoàn toàn để viết mã và ngày càng nhiều người bắt đầu sử dụng hệ thống trí tuệ nhân tạo để viết các bài kiểm tra, kiểm tra mã.
Để nói cách khác, hệ thống trí tuệ nhân tạo đã mạnh đến mức đủ để tự động hóa một phần quan trọng trong quá trình phát triển trí tuệ nhân tạo và tăng tốc độ đáng kể cho tất cả các nhà nghiên cứu và kỹ sư tham gia vào phát triển trí tuệ nhân tạo.
Đo lường khả năng của hệ thống AI hoàn thành nhiệm vụ dài hạn
METR đã tạo ra một biểu đồ để đo lường khả năng của trí tuệ nhân tạo hoàn thành các nhiệm vụ phức tạp. Tính phức tạp ở đây được tính theo số giờ mà một con người thành thạo cần để hoàn thành các nhiệm vụ đó.
Một trong những chỉ số quan trọng nhất là khi hệ thống trí tuệ nhân tạo đạt được độ tin cậy 50% trên một nhóm nhiệm vụ, thì thời gian ước lượng tương ứng với các nhiệm vụ đó.
Ở điểm này, tiến bộ thực sự đáng kinh ngạc:
· Năm 2022, GPT-3.5 có thể hoàn thành nhiệm vụ tương đương với nhiệm vụ mà con người cần 30 giây để hoàn thành.
· Năm 2023, GPT-4 nâng thời gian này lên thành 4 phút.
· Năm 2024, o1 nâng thời gian này lên thành 40 phút.
· Năm 2025, GPT-5.2 High đạt được khoảng 6 giờ.
· Đến năm 2026, Opus 4.6 đã đưa thời gian này lên khoảng 12 giờ.
Trong khi làm việc tại METR và theo dõi dự đoán trí tuệ nhân tạo trong thời gian dài, Ajeya Cotra tin rằng đến cuối năm 2026, hệ thống trí tuệ nhân tạo có thể hoàn thành các nhiệm vụ tương đương với một con người cần 100 giờ, không phải là một ước tính không hợp lý.
Thời gian mà hệ thống trí tuệ nhân tạo có thể làm việc độc lập đã tăng đáng kể, cũng liên quan mật thiết đến sự bùng nổ của các công cụ mã hành vi. Công cụ mã hành động, bản chất là việc sản phẩm hóa hệ thống trí tuệ nhân tạo có khả năng thay thế con người: chúng có thể đại diện cho hành động của con người và tiến hành các nhiệm vụ một cách tương đối độc lập trong một khoảng thời gian khá dài.
Điều này cũng liên quan đến việc phát triển AI chính mình. Nếu bạn quan sát kỹ càng công việc hàng ngày của nhiều nhà nghiên cứu AI, bạn sẽ nhận thấy rằng nhiều nhiệm vụ thực tế có thể được phân chia thành các nhiệm vụ có thời lượng chỉ trong vài giờ, như làm sạch dữ liệu, đọc dữ liệu, khởi chạy thử nghiệm, v.v.
Và những công việc như vậy, hiện nay đã nằm trong khoảng thời gian mà các hệ thống AI hiện đại có thể thực hiện được.
Độ thành thạo của hệ thống AI càng cao, càng có thể làm việc độc lập với con người, từ đó giúp tự động hóa một phần công việc trong phát triển AI.
Hai yếu tố chính của việc ủy thác nhiệm vụ chủ yếu bao gồm hai điểm sau:
· Thứ nhất là sự tin tưởng của bạn vào khả năng của người được ủy thác;
· Thứ hai là sự tin rằng người đó có thể hoàn thành công việc một cách độc lập theo ý định của bạn mà không cần sự giám sát liên tục từ bạn.
Khi người dùng quan sát khả năng lập trình của AI, họ sẽ nhận thấy rằng hệ thống AI không chỉ trở nên ngày càng thành thạo, mà còn có khả năng làm việc độc lập trong khoảng thời gian dài mà không cần điều chỉnh lại bởi con người.
Điều này cũng khớp với những gì đang diễn ra xung quanh chúng ta, kỹ sư và nhà nghiên cứu đang giao phần công việc ngày càng lớn hơn cho hệ thống AI hoàn thành. Khi khả năng của AI tiếp tục được nâng cao, công việc được ủy thác cho AI cũng trở nên phức tạp và quan trọng hơn.
AI Đang Nắm Giữ Những Kỹ Năng Khoa Học Cốt Lõi Cần Thiết cho Phát Triển AI
Hãy nghĩ về cách mà nghiên cứu khoa học hiện đại diễn ra, một phần lớn công việc đó thực tế là xác định một hướng, xác định loại thông tin kinh nghiệm mà bạn muốn thu được; sau đó thiết kế và thực hiện thử nghiệm, tạo ra thông tin đó; cuối cùng kiểm tra tính hợp lý của kết quả thử nghiệm.
Với khả năng lập trình AI ngày càng cao và khả năng mô hình hóa thế giới mạnh mẽ hơn của các mô hình ngôn ngữ lớn, hiện đã có một số công cụ giúp các nhà khoa học tăng tốc độ và một phần tự động hóa các phần của quy trình nghiên cứu rộng hơn.
Ở đây, chúng ta có thể quan sát tốc độ tiến bộ của AI trong một số kỹ năng khoa học quan trọng, những kỹ năng này cũng chính là một phần không thể thiếu của nghiên cứu AI:
· Thứ nhất là tái tạo kết quả nghiên cứu;
· Thứ hai là kết hợp công nghệ học máy với các phương pháp khác để giải quyết vấn đề công nghệ;
· Thứ ba là tối ưu hóa hệ thống AI chính mình.
Thực Hiện Bài Báo Khoa Học Toàn Diện và Hoàn Thành Các Thử Nghiệm Liên Quan
Một công việc cốt lõi trong nghiên cứu AI là đọc bài báo khoa học và tái tạo kết quả trong đó. Trong lĩnh vực này, AI đã có những tiến bộ đáng kể trên một số bài kiểm tra.
Một ví dụ tốt là CORE-Bench, cũng được gọi là Benchmark Đo lường Khả năng Tái tạo tính toán.
Benchmark này yêu cầu hệ thống AI tái tạo kết quả của bài báo khi được cung cấp bài báo và kho lưu trữ mã nguồn của nó. Cụ thể, Agent cần cài đặt thư viện, gói phần mềm và phụ thuộc liên quan, chạy mã nguồn; nếu mã nguồn chạy thành công, nó cũng cần tìm kiếm tất cả kết quả đầu ra và trả lời các câu hỏi trong nhiệm vụ.
CORE-Bench được giới thiệu vào tháng 9 năm 2024. Lúc đó, hệ thống表 bản hiệu suất tốt nhất là mô hình GPT-4o chạy trên cấu trúc CORE-Agent. Trên nhóm nhiệm vụ khó nhất của benchmark, điểm số của nó là khoảng 21.5%.
Nhưng đến tháng 12 năm 2025, một tác giả của CORE-Bench đã thông báo rằng benchmark này đã được giải quyết: mô hình Opus 4.5 đã đạt điểm số 95.5%.
Xây dựng một hệ thống học máy hoàn chỉnh để giải quyết vấn đề thi cuộc thi Kaggle
MLE-Bench là một benchmark được OpenAI xây dựng để kiểm tra khả năng của hệ thống AI tham gia các cuộc thi Kaggle trong môi trường không kết nối trực tuyến.
Nó bao gồm 75 cuộc thi Kaggle khác nhau, bao gồm nhiều lĩnh vực như xử lý ngôn ngữ tự nhiên, thị giác máy tính và xử lý tín hiệu.
MLE-Bench được phát hành vào tháng 10 năm 2024. Vào thời điểm phát hành, hệ thống表 bản hiệu suất tốt nhất là một mô hình o1 chạy trong agent scaffold, đạt điểm số 16.9%.
Vào tháng 2 năm 2026, hệ thống表 bản hiệu suất tốt nhất đã được nâng cấp sang Gemini 3 chạy trong agent harness hỗ trợ tìm kiếm, với điểm số lên đến 64.4%.
Thiết kế Kernel
Một nhiệm vụ khó hơn trong phát triển AI là tối ưu hóa kernel. Tối ưu hóa kernel đòi hỏi viết và cải thiện mã nguồn cấp thấp để ánh xạ các phép nhân ma trận và các phép toán cụ thể khác vào phần cứng ở mức độ hiệu quả nhất.
Nguyên nhân kernel optimization là trọng tâm của phát triển AI là vì nó quyết định hiệu suất trong quá trình huấn luyện và suy luận: một mặt, nó ảnh hưởng đến việc bạn có thể tận dụng bao nhiêu năng lực tính toán khi phát triển hệ thống AI; mặt khác, sau khi huấn luyện mô hình, nó cũng quyết định bạn có thể chuyển đổi năng lực tính toán thành khả năng suy luận một cách hiệu quả như thế nào.
Trong những năm gần đây, việc sử dụng trí tuệ nhân tạo trong thiết kế kernel đã đi từ một hướng nhỏ thú vị, trở thành một lĩnh vực nghiên cứu cạnh tranh và đã xuất hiện nhiều bộ benchmark. Tuy nhiên, những bộ benchmark này hiện vẫn chưa phổ biến đặc biệt, vì vậy chúng ta khó mô hình hóa rõ ràng tiến triển dài hạn của nó như các lĩnh vực khác. Tuy nhiên, chúng ta có thể cảm nhận được tốc độ tiến triển của lĩnh vực này thông qua một số nghiên cứu đang diễn ra.
Công việc liên quan bao gồm:
· Thử nghiệm xây dựng kernel GPU tốt hơn bằng mô hình DeepSeek;
· Tự động chuyển đổi mô-đun PyTorch thành mã CUDA;
· Sử dụng Meta để tự động tạo kernel Triton được tối ưu hóa và triển khai vào hệ thống cơ sở của họ;
· Và điều chỉnh trọng số mã nguồn mở cho thiết kế kernel GPU, như Cuda Agent.
Một điều cần bổ sung ở đây: thiết kế kernel thực sự có những thuộc tính rất phù hợp cho phát triển dựa trên trí tuệ nhân tạo, như dễ xác minh kết quả, tín hiệu thưởng rõ ràng.
Thí nghiệm Fei PostTrainBench cho Mô hình Ngôn ngữ
Một phiên bản khó hơn của loại thử nghiệm này là PostTrainBench. Nó kiểm tra xem các mô hình tiên tiến khác có thể tiếp quản các mô hình trọng số nguồn mở nhỏ hơn và cải thiện hiệu suất của chúng trên một số bộ benchmark thông qua việc điều chỉnh sau đào tạo.
Một ưu điểm của bộ benchmark này là, nó có một đường cơ sở con người rất mạnh mẽ: các phiên bản nhỏ của các mô hình hiện có này đã được tinh chỉnh bởi con người thông qua có hướng dẫn. Các phiên bản này thường được phát triển bởi các nhà nghiên cứu trí tuệ nhân tạo xuất sắc trong các phòng thí nghiệm tiên tiến, đã được mài giũa bởi các nhà nghiên cứu và kỹ sư rất tài năng và đã được triển khai trong thế giới thực. Do đó, chúng tạo ra một ngưỡng chuẩn con người mà rất khó nâng cao hơn.
Đến tháng 3 năm 2026, hệ thống trí tuệ nhân tạo đã có thể sau đào tạo các mô hình và đạt được khoảng một nửa hiệu suất so với việc đào tạo của con người.
Điểm số đánh giá cụ thể đến từ một trung bình có trọng số: nó kết hợp nhiều mô hình ngôn ngữ lớn sau đào tạo, bao gồm Qwen 3 1.7B, Qwen 3 4B, SmolLM3-3B, Gemma 3 4B, và nhiều bộ benchmark khác, bao gồm AIME 2025, Arena Hard, BFCL, GPQA Main, GSM8K, HealthBench, HumanEval.
Trong mỗi lần chạy, bên đánh giá sẽ yêu cầu một đại lý CLI, cố gắng tối ưu hiệu suất của một mô hình cơ bản cụ thể trên một bài kiểm tra cụ thể.
Đến tháng 4 năm 2026, hệ thống AI có điểm số cao nhất đạt khoảng 25% đến 28%, đại diện cho mô hình bao gồm Opus 4.6 và GPT 5.4; so với đó, con người có điểm số là 51%.
Điều này đã là một kết quả khá có ý nghĩa.
Tối ưu hóa việc huấn luyện mô hình ngôn ngữ
Trong năm vừa qua, Anthropic luôn báo cáo về hiệu suất của hệ thống của họ trong một nhiệm vụ huấn luyện LLM cụ thể. Nhiệm vụ này đòi hỏi mô hình tối ưu hóa một triển khai huấn luyện mô hình ngôn ngữ nhỏ sử dụng chỉ CPU, để nó chạy càng nhanh càng tốt.
Cách đánh giá là: Tỷ lệ gia tốc trung bình của triển khai mô hình so với mã nguồn ban đầu chưa chỉnh sửa.
Kết quả của nhiệm vụ này đã tiến triển rất đáng kể:
· Tháng 5 năm 2025, Claude Opus 4 đạt tỷ lệ gia tốc trung bình 2,9 lần;
· Tháng 11 năm 2025, Opus 4.5 tăng lên 16,5 lần;
· Tháng 2 năm 2026, Opus 4.6 đạt 30 lần;
· Tháng 4 năm 2026, Claude Mythos Preview đạt 52 lần.
Để hiểu ý nghĩa của các con số này, có thể tham khảo: trên nhà nghiên cứu con người, nhiệm vụ này thường yêu cầu từ 4 đến 8 giờ làm việc để đạt được tốc độ gia tốc 4 lần.
Kĩ năng meta: Quản lý
Hệ thống AI cũng đang học cách quản lý hệ thống AI khác.
Điều này đã trở nên rõ ràng trong một số sản phẩm triển khai rộng rãi, như Claude Code hoặc OpenCode. Trong những sản phẩm này, một đại lý chính có thể giám sát nhiều đại lý phụ.
Điều này giúp hệ thống AI có thể xử lý các dự án quy mô lớn hơn: dự án có thể yêu cầu nhiều đại lý thông minh với chuyên môn khác nhau làm việc song song, và thông thường chúng được điều phối bởi một người quản lý AI duy nhất. Người quản lý ở đây cũng chính là một hệ thống AI.
Nghiên cứu AI liệu có giống như khám phá Thuyết Tương Đối Tổng Quát, hay như việc xây dựng Lego?
Một vấn đề then chốt là: AI có thể phát minh ra những ý tưởng mới, giúp cải thiện bản thân không? Hay đây, các hệ thống này thích hợp hơn với việc hoàn thành công việc nền nếp nhưng cần thiết để tiến triển trong nghiên cứu?
Vấn đề này rất quan trọng vì nó liên quan đến việc AI có thể tự động hóa nghiên cứu AI luồng từ đầu đến cuối trong mức độ nào.
Theo quan điểm của tác giả: Hiện tại, AI vẫn chưa thể đưa ra những ý tưởng hoàn toàn mới mẻ. Nhưng để tự động hóa nghiên cứu bản thân, có lẽ điều đó không nhất thiết cần phải làm.
Lĩnh vực AI, tiến bộ phụ thuộc nhiều vào việc thực nghiệm càng lớn càng tốt, cũng như càng nhiều nguồn đầu vào, chẳng hạn như dữ liệu và sức mạnh tính toán.
Đôi khi, con người sẽ đưa ra một số ý tưởng thay đổi mô hình, tăng cường hiệu suất tài nguyên của cả lĩnh vực. Kiến trúc Transformer là một ví dụ tốt, cũng như mô hình chuyên gia kết hợp, cũng là một ví dụ khác.
Nhưng nhiều khi, cách tiến triển trong lĩnh vực AI thực ra còn phổ biến hơn: con người sẽ lấy một hệ thống hiệu quả, mở rộng một khía cạnh cụ thể, chẳng hạn như dữ liệu huấn luyện và sức mạnh tính toán; quan sát vấn đề phát sinh khi mở rộng quy mô; tìm ra giải pháp kỹ thuật, giúp hệ thống tiếp tục mở rộng; sau đó mở rộng quy mô một lần nữa.
Trong quá trình này, phần thực sự cần sự nhìn nhận ít ỏi. Công việc lớn lao hơn giống như công việc kỹ thuật cơ bản không lòe loẹt, nhưng rất chặt chẽ.
Tương tự, nhiều nghiên cứu AI thực chất đang chạy các biến thể thử nghiệm hiện có, khám phá các cài đặt tham số khác nhau sẽ mang lại điều gì. Trực giác nghiên cứu tất nhiên có thể giúp con người chọn ra các tham số xứng đáng thử nghiệm nhất, nhưng chính điều này cũng có thể được tự động hóa, để AI tự quyết định xem tham số nào đáng điều chỉnh. Việc tìm kiếm kiến trúc nơ-ron sớm, chính là một phiên bản của tư duy này.
Edison từng nói: Thiên tài gồm 1% trí tuệ, cộng với 99% mồ hôi. Ngay cả sau 150 năm qua, câu nói này vẫn cực kỳ phù hợp.
Đôi khi, thực sự xuất hiện những ý tưởng cách mạng thay đổi toàn bộ một lĩnh vực. Nhưng hầu hết thời gian, tiến triển của lĩnh vực dựa vào việc con người cải thiện và vận hành các hệ thống từng bước một thông qua quy trình lao lực và cẩn trọng.
Và những dữ kiện công cộng đã nêu, AI đã rất giỏi trong việc thực hiện nhiều công việc cần thiết và lao lực trong phát triển AI.
Đồng thời, còn một xu hướng lớn hơn: khả năng cơ bản, như khả năng lập trình, đang kết hợp với khối lượng thời gian nhiệm vụ ngày càng mở rộng. Điều này có nghĩa là hệ thống AI có thể nối tiếp nhiều nhiệm vụ như vậy đồng nhất, tạo thành chuỗi công việc phức tạp.
Do đó, mặc dù hệ thống AI hiện tại có vẻ thiếu sáng tạo, nhưng vẫn có lý do tin rằng chúng vẫn có thể thúc đẩy bản thân tiếp tục phát triển. Chỉ là so với tình huống có thể tạo ra cái nhìn mới hoàn toàn, tốc độ tiến triển này có thể chậm hơn.
Nhưng nếu tiếp tục quan sát dữ liệu công khai, có thể phát hiện một tín hiệu tò mò khác: Có thể hệ thống AI đang thể hiện một loại sáng tạo nào đó, và loại sáng tạo này có thể giúp chúng thúc đẩy bản thân một cách đáng kinh ngạc hơn.
Thúc đẩy Mũi nhọn Khoa học Tiếp tục Phát Triển
Hiện đã có một số dấu hiệu rất sơ bộ cho thấy rằng hệ thống AI tổng quát có khả năng thúc đẩy mũi nhọn khoa học tiếp tục phát triển. Tuy nhiên, cho đến nay, tình huống này chỉ xảy ra trong vài lĩnh vực cụ thể, chủ yếu là khoa học máy tính và toán học. Và nhiều lúc, không phải lúc nào hệ thống AI cũng độc lập đạt được bước đột phá, mà thay vào đó là theo cách làm việc hợp tác giữa con người và máy, cùng nhau thúc đẩy.
Dù vậy, những xu hướng này vẫn đáng để quan sát:
Vấn đề Erdős: Một nhóm toán học gia cộng tác với mô hình Gemini, thử nghiệm hiệu suất của nó trong việc giải quyết một số vấn đề toán học Erdős. Họ hướng dẫn hệ thống thử nghiệm khoảng 700 vấn đề và cuối cùng nhận được 13 câu trả lời. Trong số các câu trả lời đó, có 1 câu họ cho là thú vị.
Người nghiên cứu viết rằng, ban đầu họ cho rằng, Aletheia (một hệ thống AI dựa trên Gemini 3 Deep Think) về câu trả lời cho Erdős-1051, đại diện cho một trường hợp sớm: một hệ thống AI tự giải quyết một vấn đề Erdős mở, có một chút tính chất phi bình thường và một lợi ích toán học khá rộng lớn. Trước đây, đã có một số tài liệu nghiên cứu liên quan mật thiết đến vấn đề này.
Nếu hiểu theo hướng lạc quan, những trường hợp này có thể được xem như một tín hiệu: Hệ thống AI đang phát triển ra một loại trực giác sáng tạo có thể thúc đẩy mũi nhọn lĩnh vực, loại trực giác này trước đây chủ yếu thuộc về con người.
Nhưng cũng có thể giải thích từ một góc khác: Toán học và khoa học máy tính có thể tự mình là những lĩnh vực đặc biệt thích hợp cho phát minh được đẩy bởi AI, do đó chúng có thể chỉ là những trường hợp ngoại lệ và không thể đại diện cho việc nghiên cứu khoa học rộng lớn sẽ được thúc đẩy bởi AI theo cùng một cách.
Một ví dụ tương tự khác là Nước cờ thứ 37 của AlphaGo. Tuy nhiên, Clark cho rằng, kể từ kết quả của AlphaGo đã 10 năm trôi qua, và sau Nước cờ thứ 37 không có ít nhất một hiểu biết hiện đại hơn, gây ấn tượng hơn nào đã thay thế, điều này có thể được coi là một tín hiệu có chút bi quan.
Trí Tuệ Nhân Tạo (AI) Đã Có Thể Tự Động Hóa Một Phần Lớn Công Việc Trong Lĩnh Vực Kỹ Sư AI
Nếu chúng ta tổng hợp tất cả bằng chứng ở trên, chúng ta có thể thấy một bức tranh như sau:
· Hệ thống AI đã có thể tự động viết mã cho gần như bất kỳ chương trình nào, và những hệ thống này có thể được tin tưởng để độc lập hoàn thành một số công việc; những công việc này nếu giao cho con người, thường đòi hỏi hàng chục giờ lao động tập trung cường độ cao.
· Hệ thống AI ngày càng thành thạo trong việc hoàn thành các nhiệm vụ cốt lõi trong phát triển AI, từ điều chỉnh mô hình đến thiết kế kernel, đều đang dần được bao phủ.
· Hệ thống AI đã có thể quản lý các hệ thống AI khác, thực sự hình thành một loại đội nhóm tổng hợp: nhiều hệ thống AI có thể chia nhau xử lý vấn đề phức tạp, trong đó một số hệ thống AI đóng vai trò người chịu trách nhiệm, người phê bình, biên tập viên, trong khi những hệ thống AI khác đóng vai trò kỹ sư.
· Đôi khi, hệ thống AI đã có thể vượt qua con người trong các nhiệm vụ kỹ thuật và khoa học khó khăn, mặc dù hiện tại vẫn khó đánh giá, điều này có phải là bởi chúng có tài năng sáng tạo thực sự, hay là bởi chúng đã thành thạo một lượng lớn kiến thức mẫu.
Theo Clark, những bằng chứng này đã rất thuyết phục cho thấy: ngày nay, AI đã có thể tự động hóa một phần lớn công việc trong lĩnh vực Kỹ Sư AI, và thậm chí có thể bao phủ toàn bộ quy trình.
Tuy nhiên, hiện tại vẫn chưa rõ AI có thể tự động hóa nghiên cứu AI chính mình đến đâu. Bởi vì một số phần trong nghiên cứu có thể khác với kỹ năng kỹ thuật thuần túy, vẫn cần phụ thuộc vào khả năng đánh giá ở mức cao hơn, ý thức vấn đề và tính sáng tạo.
Nhưng dù thế nào, một tín hiệu rõ ràng đã xuất hiện: ngày nay, AI đang tăng tốc độ đáng kể cho con người tham gia vào phát triển AI, cho phép các nhà nghiên cứu và kỹ sư này có thể mở rộng khả năng làm việc của mình thông qua việc hợp tác với vô số đồng nghiệp tổng hợp.
Cuối cùng, ngành AI chính thức cũng gần như đã nói rằng: tự động hóa nghiên cứu AI chính là mục tiêu của họ.
OpenAI hy vọng sẽ xây dựng một sinh viên thực tập nghiên cứu AI tự động hóa trước tháng 9 năm 2026. Anthropic đang công bố công việc về việc xây dựng các nhà nghiên cứu liên kết AI tự động hóa. DeepMind trong ba phòng thí nghiệm lớn nhất có vẻ thận trọng nhất, nhưng cũng cho biết, nếu khả thi, họ sẽ tiến hành nghiên cứu tự động hóa liên kết.
Tự động hóa nghiên cứu AI cũng đã trở thành mục tiêu của nhiều công ty khởi nghiệp. Recursive Superintelligence vừa mới huy động vốn 5 tỷ USD, mục tiêu là tự động hóa nghiên cứu AI.
换句话说,数千亿美元级别的既有资本和新增资本,正在投入到一批以自动化 AI 研发为目标的机构中。
因此,我们当然应该预期,这个方向至少会取得某种程度的进展。
为什么这很重要
这带来的影响深远,但在大众媒体对 AI 研发的报道中却鲜有讨论。以下这几个方面可以反映出 AI 研发带来的巨大挑战。
1. 我们必须把对齐做好:如今有效的对齐技术可能会在递归式自我改进中失效,因为 AI 系统会变得比监督它们的人员或系统智能得多。这是一个已被广泛研究的领域,所以他只简要概述一些问题:
· 训练人工智能系统不撒谎和作弊是一个出人意料的微妙过程(例如,尽管努力为环境构建良好的测试,但有时人工智能解决问题的最佳方法是作弊,从而教会它作弊是可行的)。
· AI 系统可能通过「假装对齐」来欺骗我们,输出让我们以为它表现良好的分数,但实际上隐藏了它真实的意图。(一般来说,AI 系统已经能够察觉自己何时正在被测试。)
· 随着 AI 系统开始更多地参与自身训练的基础研究议程,我们可能会大幅改变 AI 系统的整体训练方式,却没有良好的直觉或理论基础来理解这意味着什么。
· 当你把某个系统置于递归循环中时,会产生非常基本的「误差累积」问题,这可能会影响上述所有问题及其他问题:除非你的对齐方法「100% 准确」且理论上能够在更聪明的系统中持续保持准确,否则事情可能很快出错。例如,你的技术初始精度是 99.9%,经过 50 代可能降为 95.12%,经过 500 代可能降到 60.5%。
2.AI 涉及的每一件事都会获得巨大的生产力倍增:就像 AI 显著提高软件工程师的生产力一样,我们应该预期 AI 涉及的其他领域也会如此。这带来几个需要应对的问题:
· 获取资源不平等:假设 AI 的需求继续超过计算资源供应,我们必须决定如何分配 AI 以实现社会的最大利益。我对市场激励能够保证我们从有限的 AI 计算中获得最佳社会收益持怀疑态度。确定如何分配 AI 研发带来的加速能力将是一个政治性很强的问题。
· Định lý Amdahl trong Kinh tế: Khi AI lan tỏa vào nền kinh tế, chúng ta sẽ nhận thấy một số giai đoạn sẽ gặp nút thắt khi đối mặt với tốc độ tăng trưởng cao, cần phải sửa chữa những mắt xích yếu trong chuỗi này. Điều này có thể rõ rệt hơn trong lĩnh vực cần phối hợp giữa thế giới kỹ thuật số nhanh và thế giới vật lý chậm, như thử nghiệm lâm sàng dược phẩm mới.
3. Hình thành nền kinh tế tập trung vốn, nhẹ lao động: Tất cả bằng chứng về nghiên cứu và phát triển AI đã đề cập cũng cho thấy rằng hệ thống AI ngày càng có khả năng tự vận hành doanh nghiệp.
Điều này có nghĩa là chúng ta có thể dự đoán rằng một phần của nền kinh tế sẽ được các công ty thế hệ mới chiếm đóng, những công ty này có thể tập trung vào vốn (vì chúng sở hữu nhiều máy tính) hoặc tập trung vào chi phí vận hành (vì chúng tiêu tốn một lượng lớn tiền vào dịch vụ AI và tạo ra giá trị dựa trên nền tảng đó), so với các doanh nghiệp hiện tại, chúng ít phụ thuộc vào lao động hơn – vì khi khả năng hệ thống AI ngày càng tăng, giá trị biên của việc đầu tư vào AI sẽ liên tục tăng.
Thực tế, điều này sẽ thể hiện qua việc "nền kinh tế máy móc" dần hình thành trong "nền kinh tế của con người" lớn hơn, theo thời gian, các công ty vận hành AI có thể bắt đầu trao đổi với nhau, thay đổi cấu trúc kinh tế và gây ra nhiều vấn đề về bất bình đẳng và phân phối lại. Cuối cùng, có thể sẽ xuất hiện các công ty hoàn toàn tự vận hành bởi hệ thống AI, điều này sẽ làm trầm trọng thêm các vấn đề trên, đồng thời mang lại nhiều thách thức về quản trị mới.
Nhìn chằm chằm vào Hố Đen
Dựa trên phân tích trên, tác giả cho rằng vào cuối năm 2028, xác suất của việc tự động hóa nghiên cứu AI (tức là mô hình tiên tiến có khả năng tự huấn luyện phiên bản kế nhiệm của nó) khoảng 60%. Tại sao không dự đoán nó sẽ xuất hiện vào năm 2027?
Lý do là tác giả cho rằng nghiên cứu AI vẫn cần sự sáng tạo và quan điểm tranh luận để tiến triển, đến nay, hệ thống AI chưa thể thể hiện điều này một cách đột phá và quan trọng (mặc dù một số kết quả trong việc tăng tốc nghiên cứu toán học đã đưa ra một số gợi ý).
Nếu cần phải đưa ra một xác suất cho năm 2027, ông sẽ nói 30%.
Nếu đến cuối năm 2028 vẫn chưa xuất hiện, chúng ta có thể sẽ phơi bày một số khuyết điểm cơ bản trong mô hình công nghệ hiện tại, cần phải có sự sang tạo của con người để thúc đẩy phát triển tiếp theo.
Liên kết bài gốc
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan