Biểu đồ minh họa 'Hiệu ứng Dunning-Kruger': Chi phí Tiết kiệm và Hóa đơn API Tăng 100 Lần

Cách đây vài ngày, Trưởng nhóm AI của AMD, Stella Laurenzo, đã đăng một báo cáo vấn đề trên Kho mã nguồn chính thức của Claude Code có tiêu đề "Claude Code không còn phù hợp với các nhiệm vụ kỹ thuật phức tạp". Điều này không phải là một phàn nàn dựa trên cảm xúc của người dùng, mà là một phân tích dựa trên số liệu với 6.800 phiên. Nó đặt ra vấn đề mà ngành AI ít muốn đối mặt nhất, trong đó có một tập hợp con số đáng chú ý: Phần cấu hình tiết kiệm chi phí của Anthropic đã đưa hóa đơn hàng tháng của nhóm này từ 345 đô la lên tới 42.121 đô la.
Đội của Laurenzo đã theo dõi 235.000 lần gọi công cụ, 18.000 gợi ý từ khóa, ghi lại sự suy giảm hiệu suất hệ thống của Claude Code từ tháng 2 năm 2026. Báo cáo này sau đó đã được The Register đưa tin, gây ra một cơn bão dư luận trong cộng đồng phát triển kéo dài hai tuần.
Trưởng nhóm Anthropic Claude Code, Boris Cherny, đã đưa ra giải thích trên Hacker News. Ngày 9 tháng 2, khi phát hành Opus 4.6, tính năng "Tự điều chỉnh suy nghĩ" tự động dựa vào mô hình đã được kích hoạt mặc định. Ngày 3 tháng 3, Anthropic đã giảm mức độ suy nghĩ mặc định xuống còn 85. Lý do chính thức là "điểm cân bằng tốt nhất giữa trí tuệ, độ trễ và chi phí". Hiệu quả thực tế của hai điều chỉnh này đã được thể hiện rõ qua dữ liệu.
Độ sâu suy nghĩ giảm 3/4
Theo dữ liệu vấn đề GitHub của Stella Laurenzo, độ sâu suy nghĩ trung bình của Claude Code đã trải qua một sụp đổ theo ba giai đoạn trong vòng hai tháng: từ 2.200 ký tự vào cuối tháng 1 khi đạt đỉnh, giảm xuống còn 720 ký tự vào cuối tháng 2, giảm 67%. Vào tháng 3, nó tiếp tục giảm xuống còn 560 ký tự, giảm 75% so với điểm cao nhất.
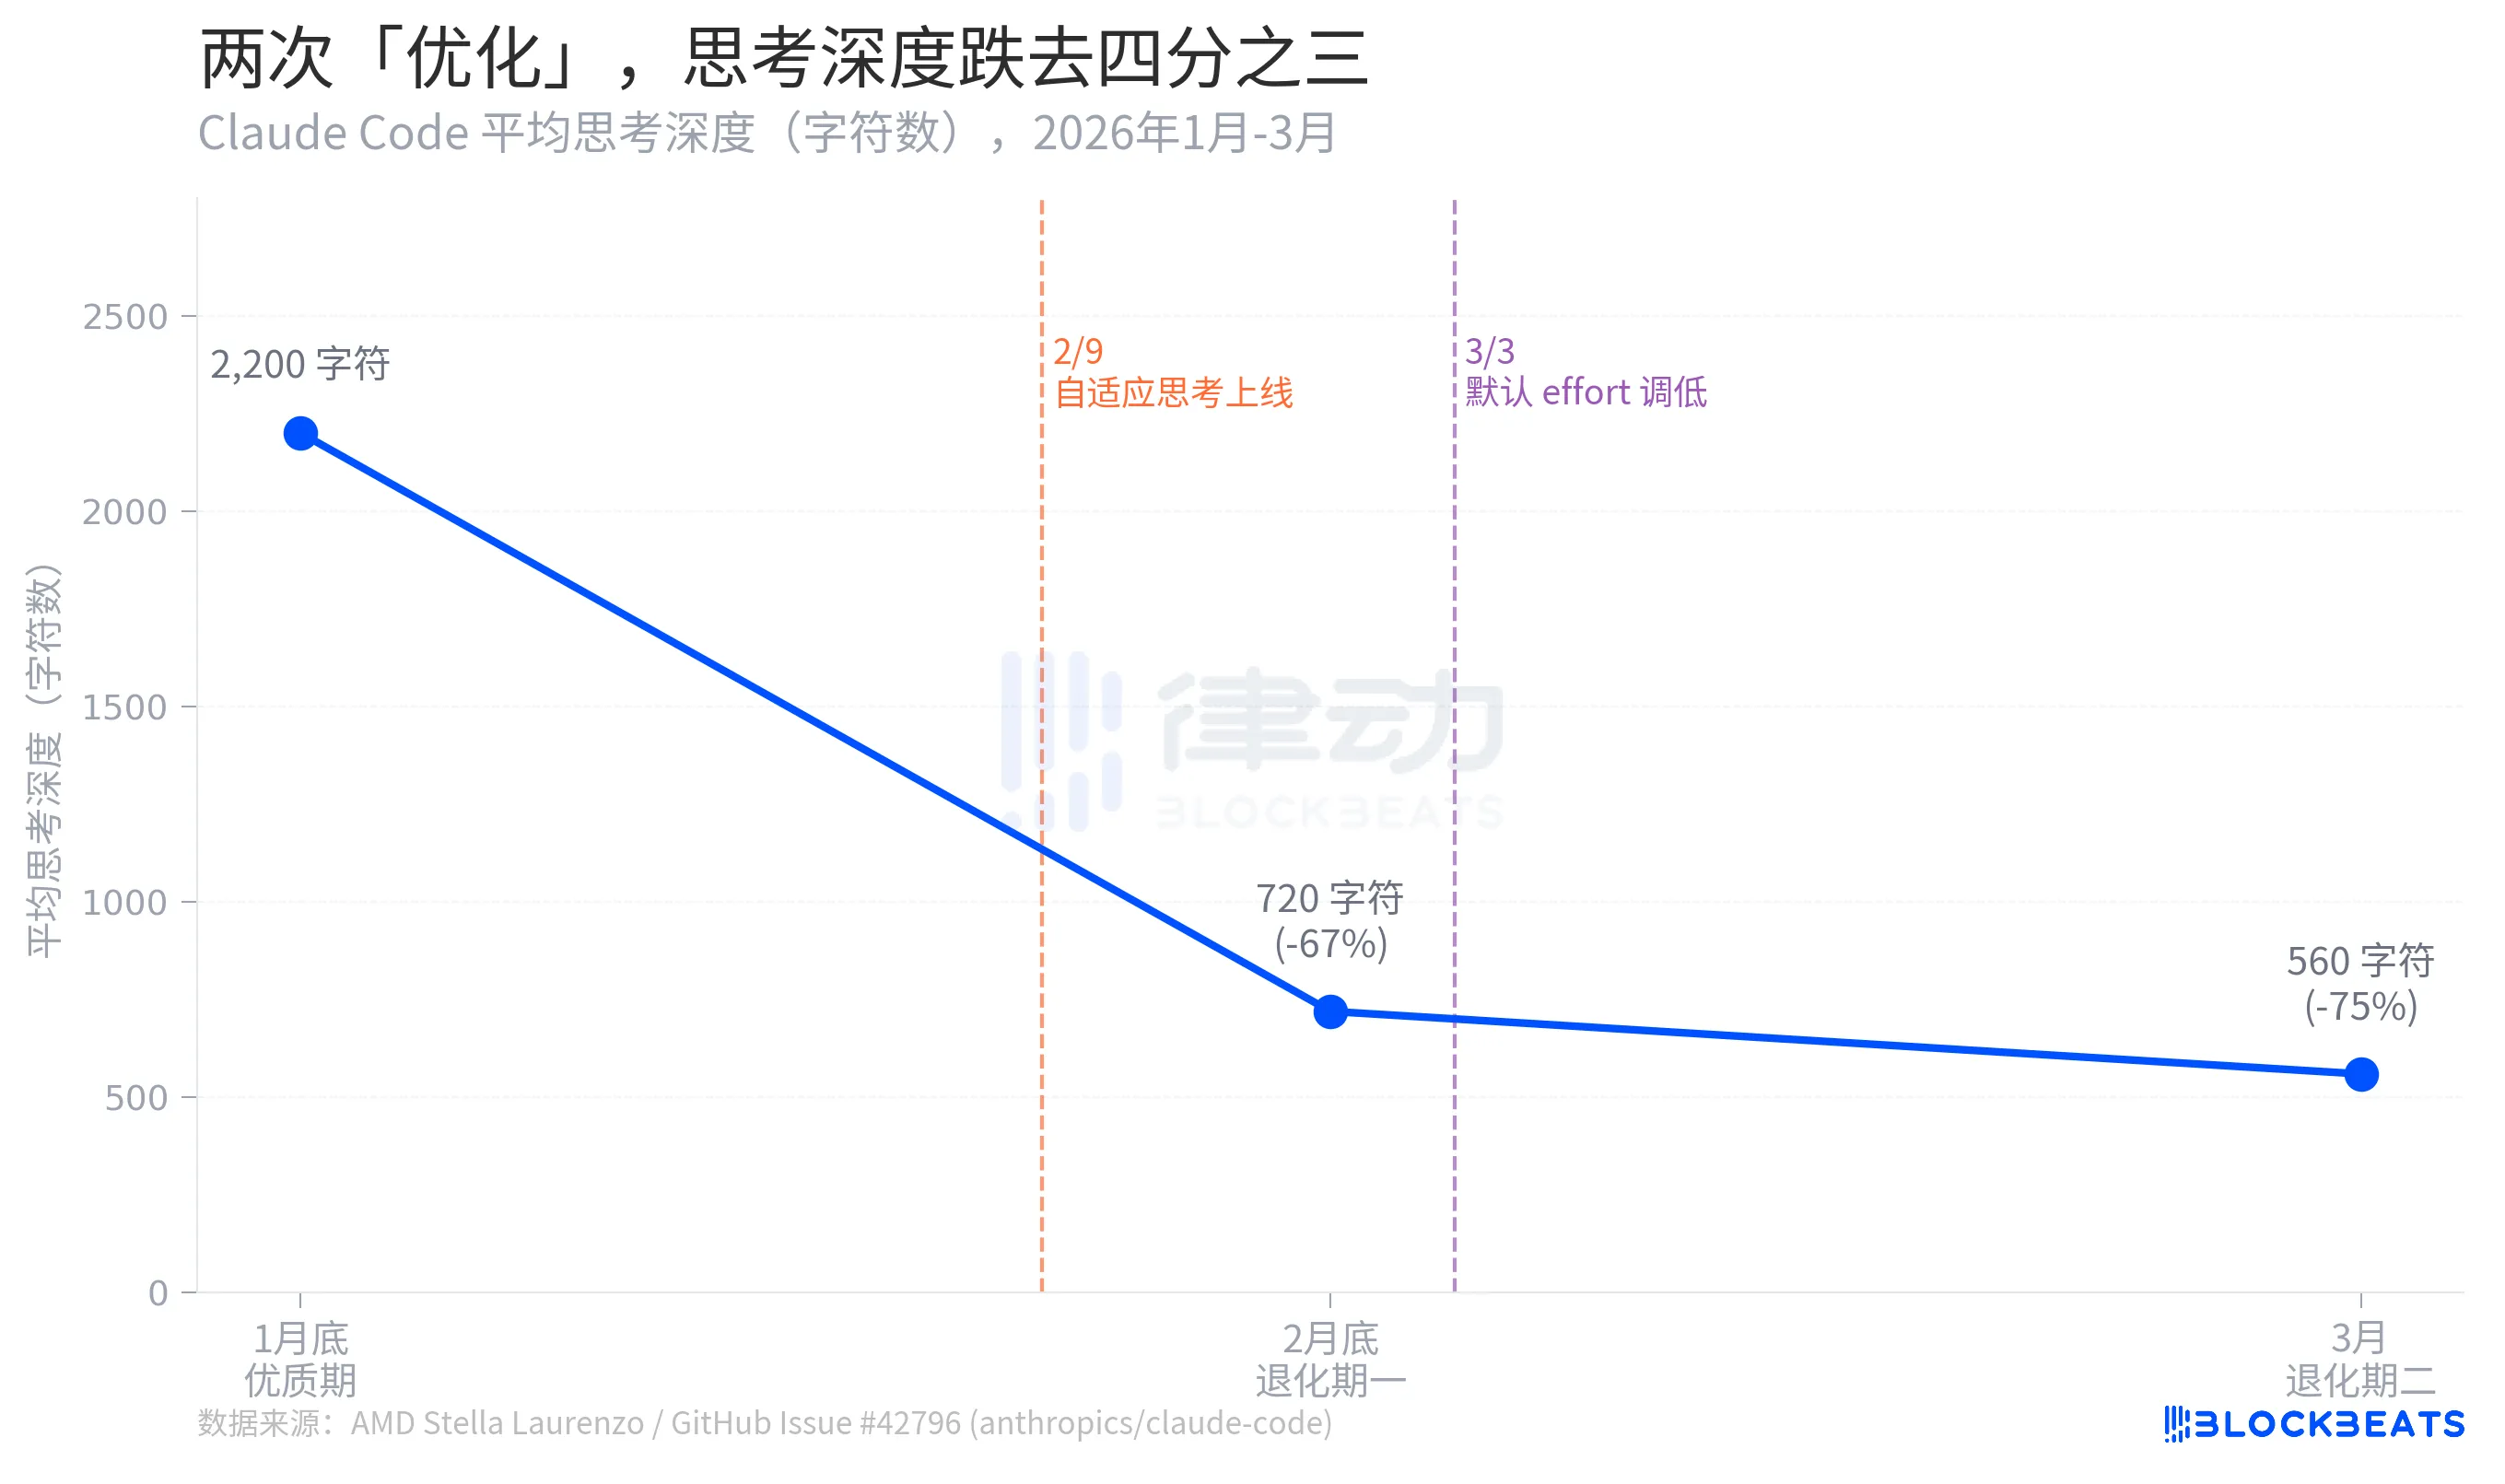
Độ sâu suy nghĩ ở đây là một chỉ số đại diện, phản ánh mức độ "tự suy diễn bên trong" mà mô hình sẵn sàng bỏ ra trước khi đưa ra câu trả lời. Sự chênh lệch giữa 2.200 ký tự và 560 ký tự có ý nghĩa tương đương với việc từ "viết nháp trước khi trả lời" suy giảm xuống "suy nghĩ hai giây trong đầu rồi nói ra".
Laurenzo cũng chỉ ra rằng tính năng "Ẩn nội dung suy nghĩ" được triển khai vào đầu tháng 3 (redact-thinking-2026-02-12) đã tương đối che giấu quá trình suy nghĩ của mô hình, khiến người dùng không thể cảm nhận rõ sự co rút này. Boris Cherny khẳng định rằng đây chỉ là thay đổi giao diện và không ảnh hưởng đến quá trình suy luận ở cấp độ dưới. Cả hai quan điểm đều hợp lý về mặt kỹ thuật, nhưng từ góc nhìn của người dùng, hiệu quả thì không khác biệt.
Boris Cherny sau này cũng thừa nhận rằng, ngay cả khi đặt effort về mức cao nhất một cách thủ công, cơ chế suy nghĩ tự điều chỉnh vẫn có thể phân phối kiến thức không đủ trong một số vòng lặp và có thể dẫn đến nội dung ảo tưởng. "Khôi phục tới effort cao nhất" không phải là một giải pháp hoàn chỉnh, nó chỉ là việc quay nút trở lại gần vị trí ban đầu mà không khôi phục hoàn toàn đến tính xác định ban đầu.
Từ "Lập trình viên trung thành" đến "Lập trình viên mù quáng"
Trong báo cáo của Stella Laurenzo, có một chi tiết trực tiếp hơn cả độ sâu suy nghĩ: trước khi sửa mã, mô hình sẽ tự đọc bao nhiêu tệp liên quan.
Theo dữ liệu GitHub Issue, tỷ lệ đọc so với sửa ở giai đoạn tốt nhất là 6.6, có nghĩa là trước khi sửa một đoạn mã, mô hình trung bình sẽ đọc 6.6 tệp để hiểu văn bản xung quanh. Ở giai đoạn suy thoái, con số này giảm xuống còn 2.0, giảm khoảng 70%. Đáng ngạc nhiên hơn, khoảng một phần ba sửa đổi mã xảy ra khi mô hình chưa đọc file mục tiêu, mà chỉ thực hiện trực tiếp.
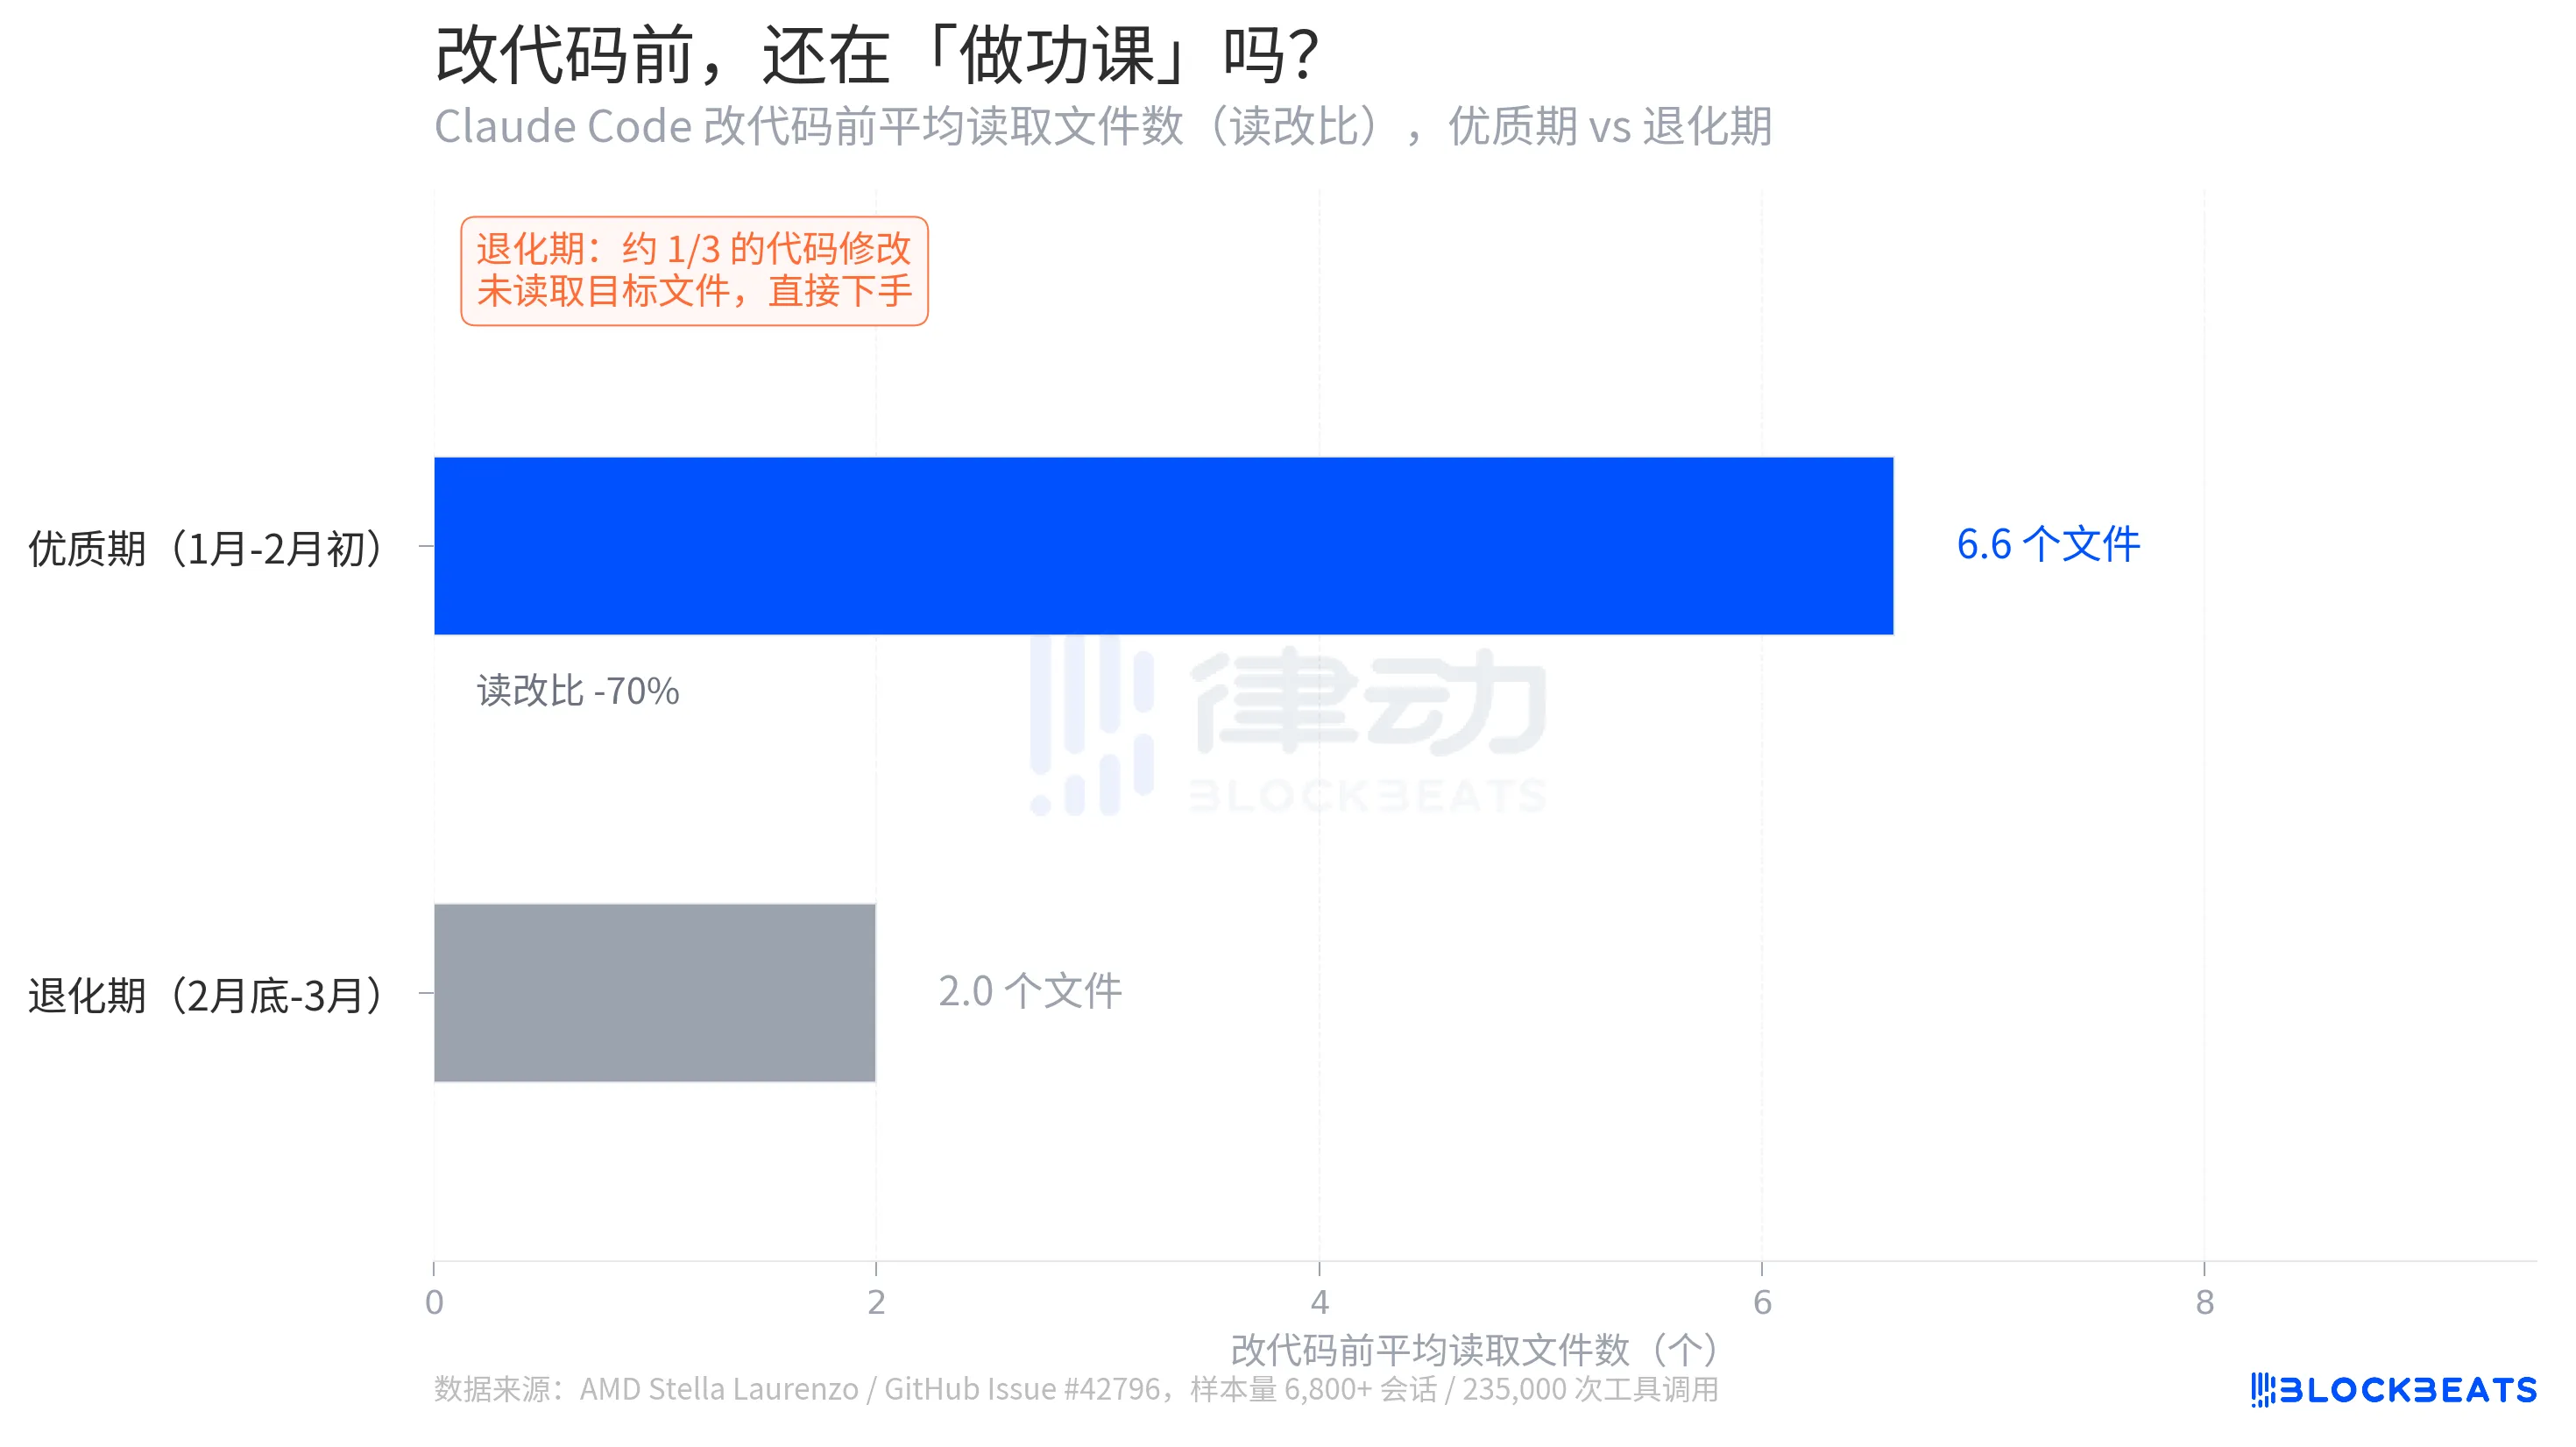
Laurenzo gọi đó là "sửa đổi mù quáng" (blind edits). Về mặt kỹ thuật, điều này tương đương với việc một lập trình viên viết mã mà không xem chữ ký hàm, không biết kiểu biến. "Mỗi kỹ sư cấp cao trong đội của tôi đều đã trải qua những trải nghiệm tương tự." Cô viết trong báo cáo, "Claude hiện không thể được tin cậy để thực hiện các nhiệm vụ kỹ thuật phức tạp như trước."
Tỷ lệ đọc so với sửa giảm từ 6.6 xuống 2.0 không chỉ là sự thay đổi của một chỉ số hành vi, mà chính là sự sụt giảm của tỷ lệ hoàn thành nhiệm vụ. Độ phức tạp của các kho lưu trữ mã nguồn hiện đại quyết định rằng bất kỳ sửa đổi nào cũng liên quan đến sự phụ thuộc giữa nhiều tệp. Việc bỏ qua việc khám phá ngữ cảnh và chỉ sửa đổi trực tiếp sẽ tạo ra lỗi không phải là "trả lời sai", mà là "dường như đúng nhưng sẽ gây ra lỗi mới trong tương lai. Chi phí sửa lỗi của loại lỗi này cao hơn nhiều so với việc trả lời sai một lần.
Việc "Tiết kiệm" này, tính ngược lại
Đây là một nhóm số liệu ngược logic nhất trong toàn bộ sự kiện, đến từ cùng một dữ liệu GitHub Issue: Chi phí gọi API hàng tháng của Claude Code từ 345 đô la vào tháng 2 năm 2026, tăng đột ngột lên 42,121 đô la vào tháng 3, tăng 122 lần.
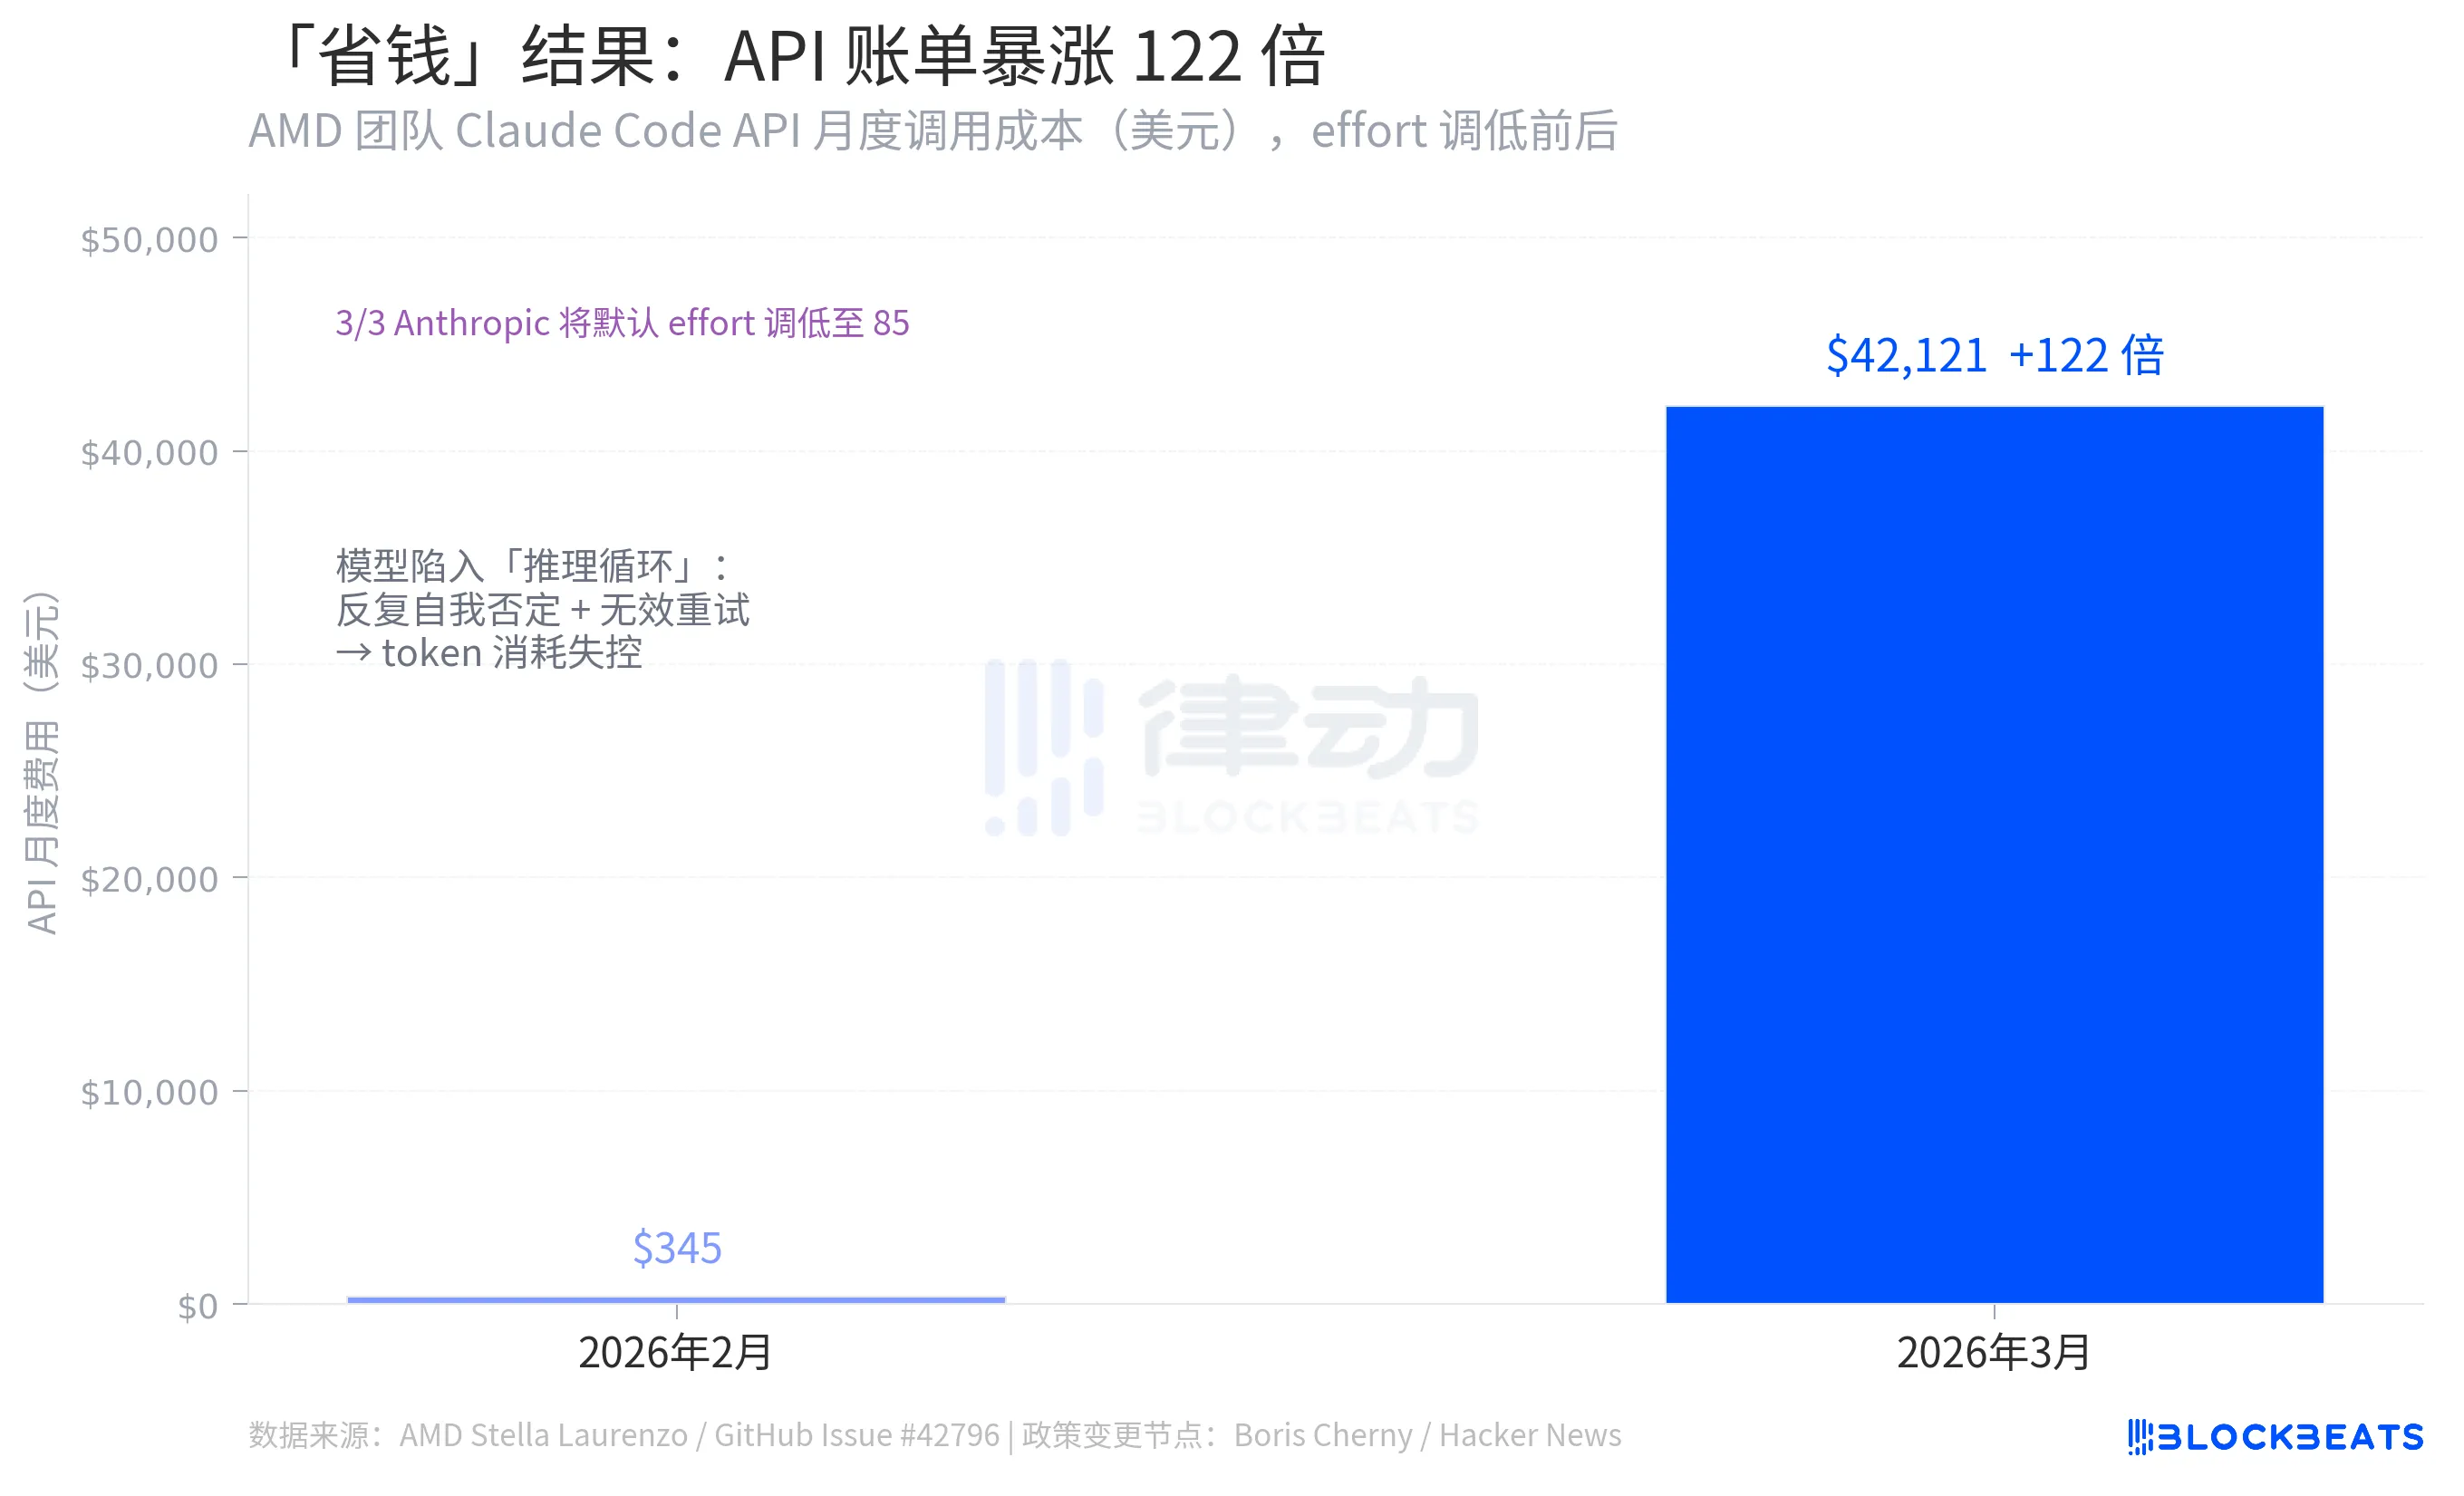
Lý do Anthropic giảm effort là để giảm tiêu thụ token mỗi lần gọi, từ đó giảm chi phí. Nhưng kết quả lại ngược lại. Lý do là sau khi suy thoái, mô hình bắt đầu xuất hiện nhiều "vòng lặp suy luận" (Reasoning Loops), trong mỗi lần phản hồi mô hình lại tự phủ nhận chính mình, lặp đi lặp lại, tiêu tốn hết token nhiều hơn nhiều so với tiết kiệm được. Theo dữ liệu của Stella Laurenzo, tỷ lệ người dùng ngừng nhiệm vụ tự nguyện tăng 12 lần, các nhà phát triển phải can thiệp, sửa lỗi và gửi lại liên tục.
Đằng sau logic là một lỗi hệ thống. Việc cắt giảm năng lực trong các nhiệm vụ phức tạp không đơn giản là giảm chi phí theo tỷ lệ. Khi mức độ giảm xuống dưới ngưỡng suy nghĩ nào đó, mô hình bắt đầu đi lạc đường, tổng chi phí lại tăng lên. Giảm effort trong các truy vấn đơn giản đã tiết kiệm được tiền, nhưng trong các nhiệm vụ kỹ thuật mã nguồn, nó lại khiến hóa đơn tăng cao.
Việc "giảm trí" này, GPT-4 đã trải qua ba năm trước
Vào tháng 7 năm 2023, nhóm nghiên cứu từ Đại học Stanford và Đại học California, Berkeley đã công bố bài báo "How is ChatGPT's behavior changing over time?" trên arXiv, ghi lại quá trình diễn ra của một vấn đề tương tự trên GPT-4.
Theo dữ liệu nghiên cứu, vào tháng 3 năm 2023, hơn 50% mã được tạo ra bởi GPT-4 có thể chạy ngay. Đến tháng 6, tỷ lệ này giảm xuống còn 10%, giảm khoảng 80%, trong vòng ba tháng. Cùng lúc đó, độ chính xác nhận diện số nguyên tố từ 97.6% giảm xuống còn 2.4%. Phản ứng của OpenAI và Anthropic khá tương đồng: đã có điều chỉnh tối ưu ở phía sau, thuộc quá trình cập nhật bình thường.
Cấu trúc của hai câu chuyện gần như giống nhau, một công ty AI nào đó đã điều chỉnh các tham số ảnh hưởng đến khả năng của mô hình trong hậu trường, người dùng nhận biết được điều này, công ty thừa nhận đã điều chỉnh nhưng giải thích rằng đó là "phân phối tài nguyên hợp lý hơn". Sự suy giảm của GPT-4 xảy ra vào năm 2023, sự suy giảm của Claude xảy ra vào năm 2026, cách nhau ba năm, nhưng kịch bản lại giống nhau.
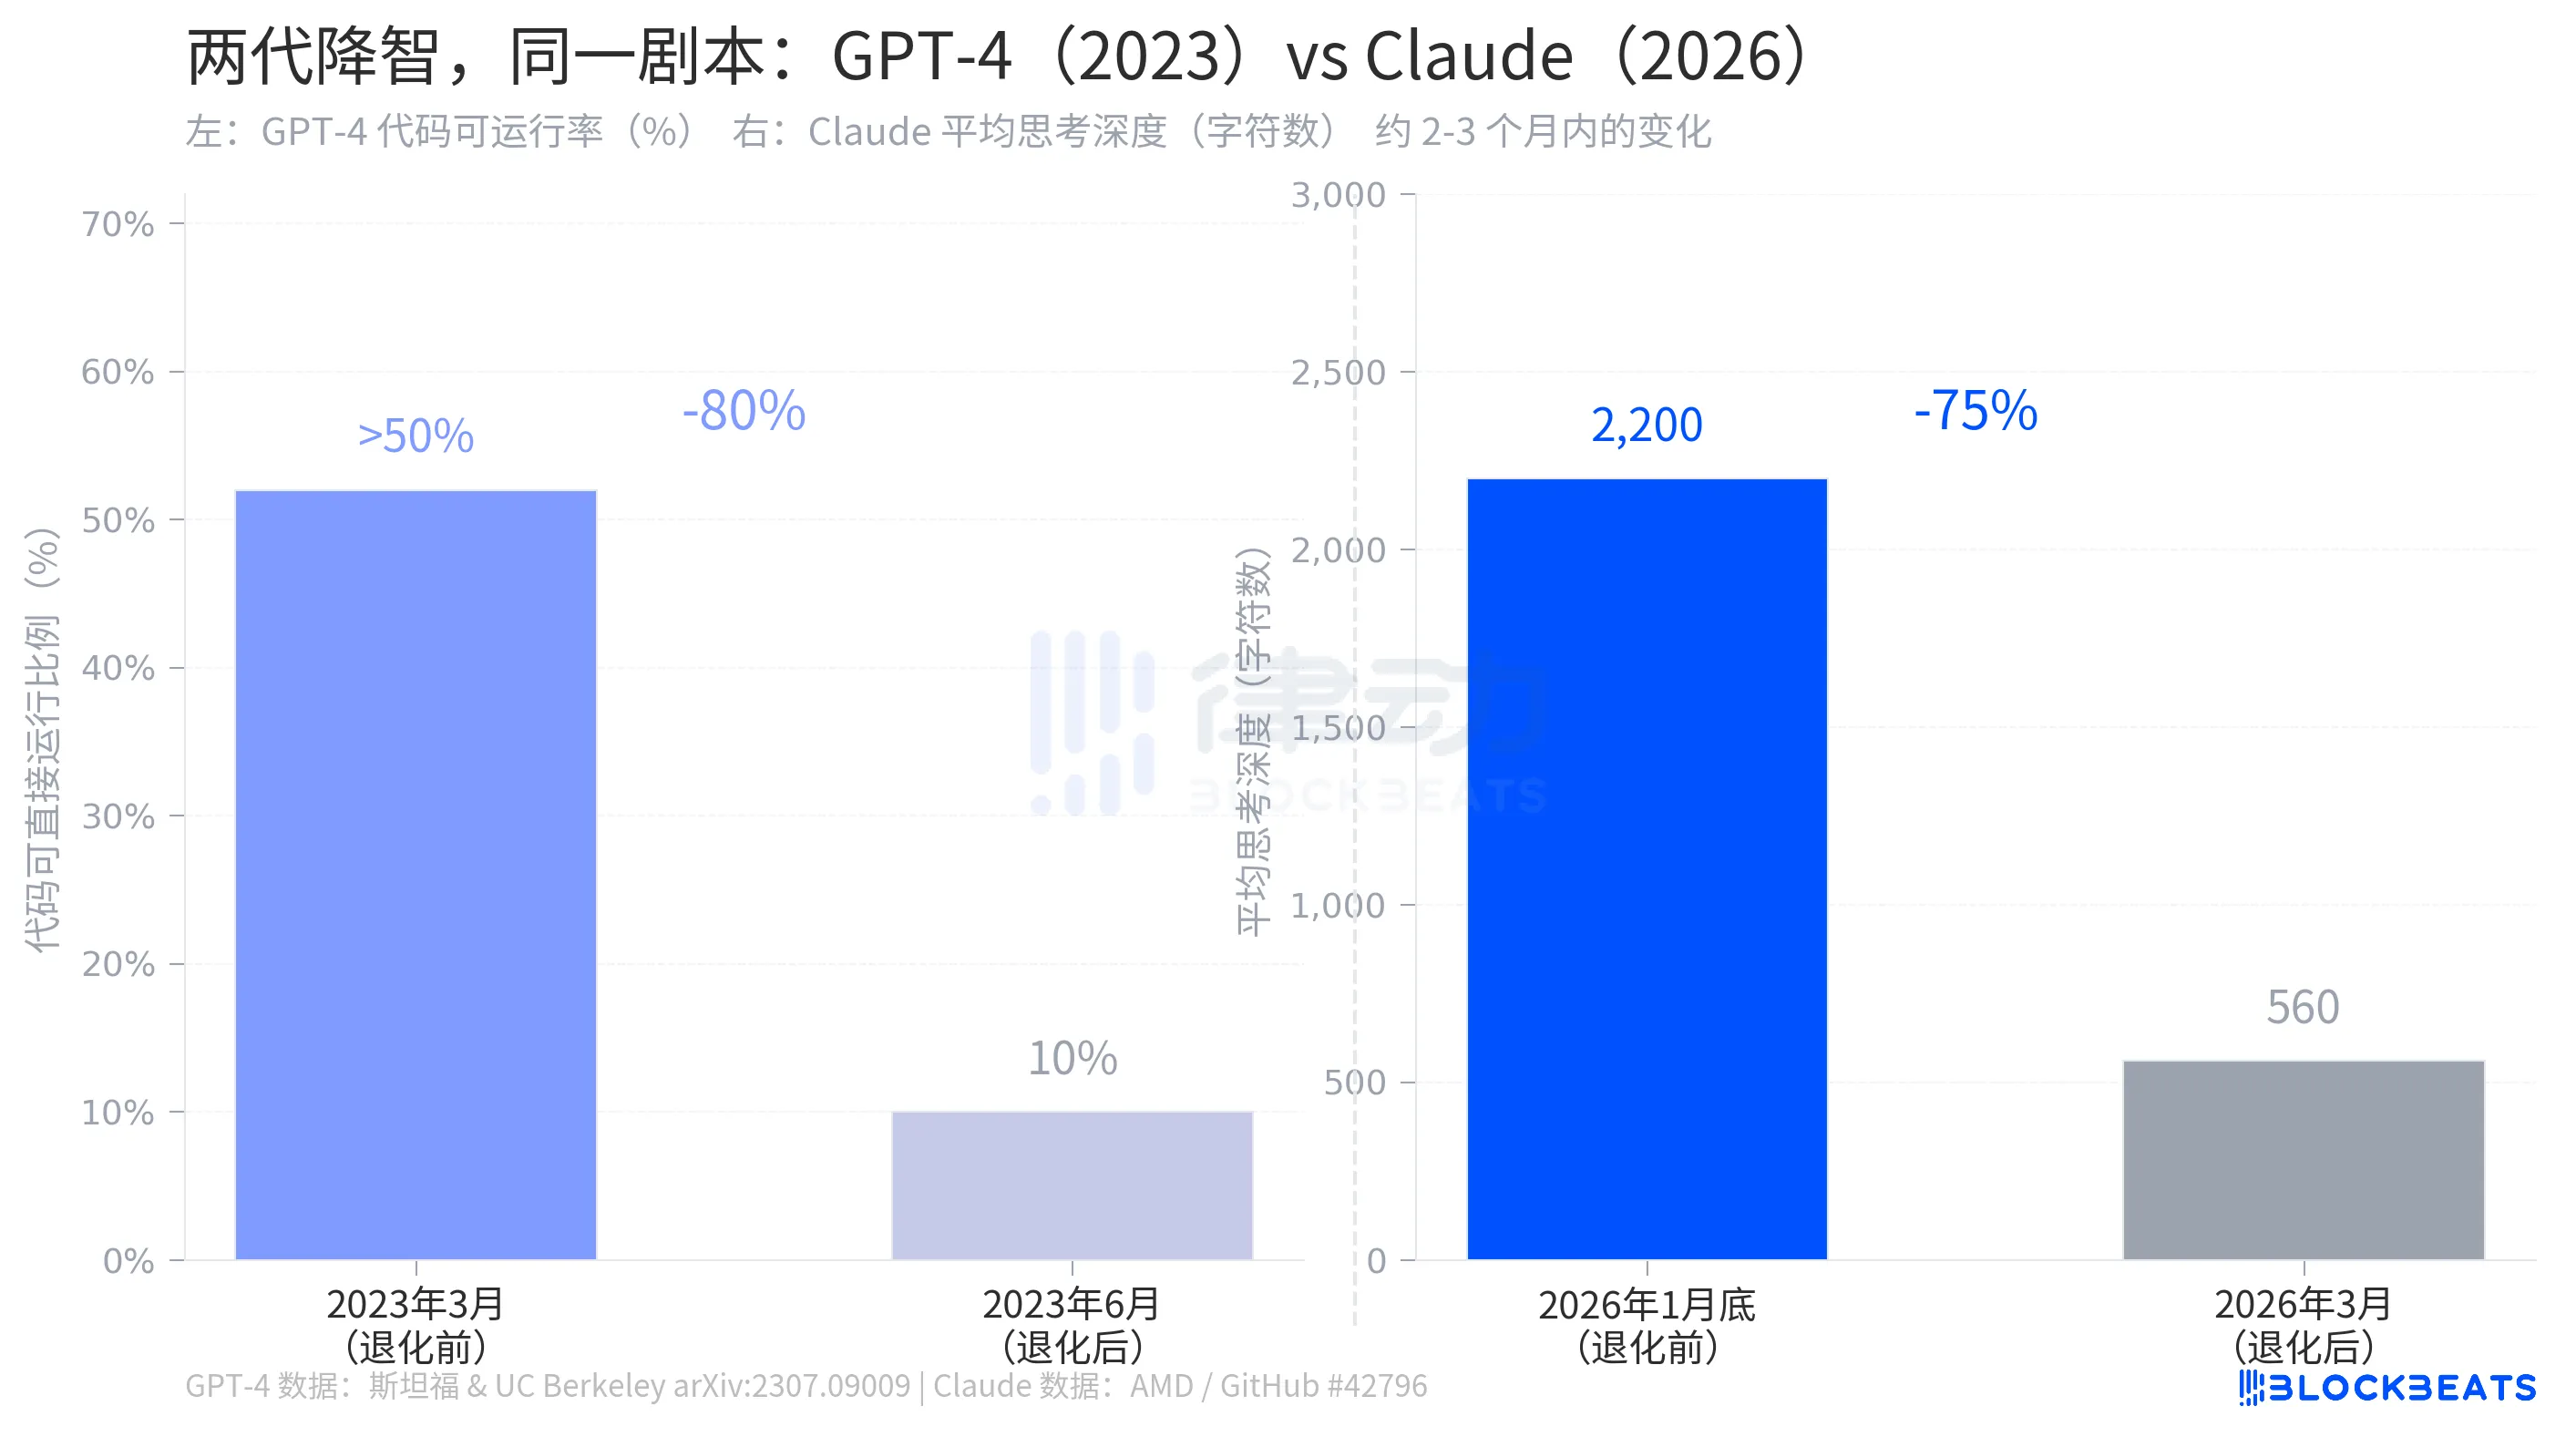
Điều này không phải là một lỗi riêng của một công ty nào đó. Logic kinh tế của mô hình đăng ký AI quyết định rằng, khi chi phí suy luận cao hơn phạm vi giá mà giá có thể bao phủ, áp lực mà nhà sản xuất đối mặt cũng tương tự. Việc giảm mức độ suy nghĩ mặc định là cái cần xoay nhanh nhất giữa chi phí và hiệu suất hiện tại. Người dùng cảm thấy mô hình "điếc điếc hơn". Những gì nhà sản xuất tiết kiệm trên bảng kế toán không phải là từng lần yêu cầu với chi phí token bên cạnh.
Boris Cherny đưa ra một giải pháp kỹ thuật, người dùng có thể sử dụng chỉ thị /effort high hoặc chỉnh sửa tệp cấu hình để tự điều chỉnh mức độ suy nghĩ trở lại mức cao nhất. Giải pháp này có thể thực hiện về mặt kỹ thuật, nhưng đồng thời nó cũng có nghĩa là "hiệu suất cao nhất" không còn là thiết lập mặc định nữa.
Từ 345 USD lên 42.121 USD, cái bị tiêu tốn không chỉ là ngân sách mà còn là một giả định: điều chỉnh cấu hình mặc định mà nhà sản xuất đã làm, là để cải thiện hiệu suất sử dụng của người dùng.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan