Triết lý tiết kiệm trong thời đại Trí tuệ Nhân tạo: Làm thế nào để tiêu hết mỗi Token một cách hiệu quả
文 | Sleepy.md
Trong thời đại điện tín tính phí theo từng chữ, mực và giấy bút là tiền. Mọi người thường xuyên rút ngắn hàng vạn lời nói thành điều cần thiết, việc "trở về nhanh" bằng một lá thư ngắn có giá trị không kém so với một bức thư dài, và "an toàn" là lời khuyên quan trọng nhất.
Sau đó, điện thoại kéo vào trong nhà, nhưng cước cuộc gọi xa tính theo giây. Cuộc gọi điện thoại xa của phụ huynh luôn ngắn gọn, khi công việc chính đã nói xong, họ sẽ treo máy vội vã, và nếu chuyện đã kéo dài một chút, suy nghĩ về tiền cước sẽ kết thúc sự trái ngược đang phát triển.
Sau đó nữa, internet rộng băng thông gia đình, tính cước theo giờ, mọi người nhìn chăm chăm vào bộ đếm thời gian trên màn hình, mở trang web lên rồi tắt ngay, chỉ dám tải video, dịch vụ truyền thông dạng luồng vào thời điểm đó được coi là một động từ xa hoa. Ở cuối thanh tiến độ tải xuống mỗi, luôn chứa đựng sự khao khát kết nối với thế giới và nỗi lo thiếu tiền trong tài khoản.
Đơn vị tính cước thay đổi, nhưng bản năng tiết kiệm tiền vẫn mãi không thay đổi.
Nay, Token đã trở thành loại tiền của thời đại AI. Tuy nhiên, hầu hết mọi người vẫn chưa học được cách tiết kiệm trong thời đại này, vì chúng ta vẫn chưa biết cách tính toán lãi lỗ trong thuật toán không thể nhìn thấy.
Vào năm 2022, khi ChatGPT mới ra mắt, hầu như không ai quan tâm Token là gì. Đó là thời kỳ ấm trò của AI, mỗi tháng chi 20 đô la, muốn nói chuyện bao nhiêu thì nói chuyện.
Nhưng từ khi AI Agent trở nên phổ biến gần đây, việc tiêu Token đã trở thành điều mà mỗi người dùng AI Agent đều cần quan tâm.
Khác với cuộc trò chuyện đơn giản hỏi đáp, phía sau một quy trình là hàng trăm lần gọi API, việc tư duy độc lập của Agent có giá phải trả, mỗi lần tự sửa chữa, mỗi lần gọi công cụ, đều tương ứng với việc con số trên hóa đơn nhảy múa. Sau đó, bạn sẽ nhận ra rằng số tiền bạn nạp vào không đủ, và bạn không biết Agent đã làm gì cả.
Trong cuộc sống thực, mọi người đều biết làm thế nào để tiết kiệm tiền. Đi chợ mua rau, chúng ta biết rằng nên chọn lá cây dơ bằng và trước khi cân; đi taxi đến sân bay, tài xế cũ biết tránh xa đường cao tốc vào giờ cao điểm.
Lý do tiết kiệm tiền trong thế giới số cũng tương tự, chỉ là đơn vị tính cước đã chuyển từ "kilôgam" và "kilômét" sang Token.
Trong quá khứ, việc tiết kiệm là do thiếu thốn; nhưng trong thời đại AI, tiết kiệm là để chính xác.
Chúng tôi hy vọng rằng thông qua bài viết này, chúng tôi có thể giúp bạn xây dựng một phương pháp tiết kiệm trong thời đại AI, giúp bạn tiêu tiền một cách có hiệu suất tối đa.
Trước Khi Đưa Vào Cân, Hãy Lựa Chọn Lá Rau Thối Ra
Trong thời đại Trí Tuệ Nhân Tạo, giá trị của thông tin không còn được xác định bởi tính rộng lớn, mà bởi tính trong sạch.
Logic tính phí của Trí Tuệ Nhân Tạo dựa trên số từ mà nó đọc. Dù bạn đưa vào là sự hiểu biết sâu rộng hay là những lời nói vô nghĩa, chỉ cần nó đọc được, bạn đều phải trả tiền.
Do đó, cách suy nghĩ đầu tiên để tiết kiệm Token là ghi sâu vào tiềm thức khái niệm "tỷ lệ tín hiệu nhiễu".
Mỗi từ, mỗi hình ảnh, mỗi dòng mã bạn đưa cho Trí Tuệ Nhân Tạo đều phải trả tiền. Vì vậy khi đưa bất kỳ thứ gì cho Trí Tuệ Nhân Tạo, hãy nhớ hỏi chính mình trước: trong đó có bao nhiêu là thực sự cần thiết cho Trí Tuệ Nhân Tạo? Có bao nhiêu là lá rau thối?
Ví dụ như câu mở đầu dài dòng như "Xin chào, hãy giúp tôi..." , giới thiệu nền lặp đi lặp lại, các comment mã không xóa sạch, đều là lá rau thối.
Bên cạnh đó, lãng phí phổ biến nhất là đưa trực tiếp file PDF hoặc ảnh chụp màn hình cho Trí Tuệ Nhân Tạo. Bạn thật sự tiết kiệm công sức khi làm như vậy, nhưng trong thời đại Trí Tuệ Nhân Tạo, "tiết kiệm công sức" thường đồng nghĩa với "đắt đỏ".
Một file PDF hoàn chỉnh, ngoài nội dung chính, còn bao gồm tiêu đề, chân trang, chú thích biểu đồ, watermark ẩn, và rất nhiều mã định dạng được sử dụng để sắp xếp trang. Những thứ này không hề giúp Trí Tuệ Nhân Tạo hiểu vấn đề của bạn, nhưng tất cả đều bị tính phí.
Lần sau nhớ chuyển file PDF sang văn bản Markdown sạch trước khi đưa cho Trí Tuệ Nhân Tạo. Khi bạn chuyển một file PDF 10MB thành văn bản sạch 10KB, bạn không chỉ tiết kiệm 99% chi phí mà còn làm tăng tốc độ xử lý trí tuệ của Trí Tuệ Nhân Tạo lên nhiều lần so với trước.
Ảnh là một cỗ máy tiêu tiền khác.
Trong logic của mô hình thị giác, Trí Tuệ Nhân Tạo không quan tâm xem ảnh của bạn có đẹp hay không, nó chỉ quan tâm đến bạn chiếm hữu bao nhiêu diện tích pixel.
Ví dụ với logic tính phí chính thức của Claude: Tiêu hao Token của ảnh = Chiều rộng pixel × Chiều cao pixel ÷ 750.
Một bức ảnh có kích thước 1000×1000 pixel, tiêu hao khoảng 1334 Token, theo giá sư Sonnet Claude 4.6, mỗi bức ảnh khoảng 0.004 đô la;
Nhưng nếu bạn nén cùng một bức ảnh xuống 200×200 pixel, chỉ cần 54 Token, chi phí giảm xuống còn 0.00016 đô la, chênh lệch đến 25 lần.
Nhiều người thường trực tiếp đưa ảnh chất lượng cao chụp bằng điện thoại hoặc bức ảnh 4K cho AI mà không biết rằng số Token mà bức ảnh này tiêu tốn có thể đủ để AI đọc được nửa cuốn tiểu thuyết trung bình. Nếu nhiệm vụ chỉ là nhận dạng văn bản trên ảnh hoặc thực hiện các phán đoán thị giác đơn giản, chẳng hạn như cho AI nhận dạng số tiền trên hóa đơn, đọc văn bản trong hướng dẫn sử dụng, hoặc phân định xem có đèn giao thông đỏ hay xanh trong hình, thì độ phân giải 4K chỉ đơn giản là lãng phí, nén ảnh xuống đến độ phân giải tối thiểu là đủ.
Nhưng lý do dễ lãng phí nhất ở đầu vào thực sự không phải là định dạng tệp, mà là cách giao tiếp không hiệu quả.
Nhiều người xem AI như hàng xóm thực sự, quen với cách nói chuyện xã hội, trình bày vấn đề từ từ, ví dụ "Hãy giúp tôi viết một trang web," sau đó chờ AI trả lời với một bản nháp, sau đó bổ sung chi tiết, sau đó lặp đi lặp lại. Loại trò chuyện vặn bướm cánh dày, khiến cho AI phải tạo ra nội dung lặp đi lặp lại, mỗi lần chỉnh sửa đều tăng thêm Token tiêu tốn.
Kỹ sư của Tencent Cloud trong thực tế đã phát hiện rằng, với cùng một yêu cầu, các cuộc trò chuyện kéo dài nhiều vòng như vặn bướm cánh, số Token tiêu tốn cuối cùng thường là 3 đến 5 lần so với việc nói rõ trong một lần.
Con đường thực sự tiết kiệm, là từ bỏ loại thử thông tin xã hội không hiệu quả này, một lần nói rõ yêu cầu, điều kiện biên và ví dụ tham chiếu. Hãy giảm sự giải thích vất vả về "đừng làm gì," vì câu phủ định thường tiêu tốn nhiều hơn chi phí hiểu biết so với câu khẳng định; hãy nói cho nó biết "phải làm thế nào," và cung cấp một ví dụ đúng rõ ràng.
Đồng thời, nếu bạn biết mục tiêu là gì, hãy nói rõ ngay với AI, đừng để AI trở thành thám tử.
Khi bạn ra lệnh cho AI "tìm mã liên quan đến người dùng," nó phải tiến hành quét lớn, phân tích và đoán; trong khi khi bạn trực tiếp bảo nó "đi xem file src/services/user.ts này," sự khác biệt về Token tiêu tốn là đáng kể, trong thế giới số, thông tin tương đương là cách tiết kiệm lớn nhất.
Đừng trả tiền cho "lịch sự" của AI
Việc tính toán các mô hình lớn có một quy tắc không được nhiều người nhận ra: số Token đầu ra thường đắt hơn số Token đầu vào 3 đến 5 lần.
Nghĩa là, những gì AI nói ra, thường đắt hơn những gì bạn nói cho nó. Lấy ví dụ với giá của Claude Sonnet 4.6, mỗi triệu Token đầu vào chỉ cần 3 đô la, trong khi số Token đầu ra bất ngờ tăng lên 15 đô la, một biến động giá 5 lần.
Những lời chào lịch sự như "Vâng, em đã hiểu đầy đủ yêu cầu của anh,giờ bắt đầu trả lời cho anh..." ấy, những kết thúc lịch sự như "Hy vọng nội dung trên sẽ hữu ích cho anh" ấy, trong giao tiếp giữa con người là những từ lịch thiệp, nhưng trên hóa đơn của API, những câu hỏi thăm không mang lại giá trị thông tin cũng đều là tiền của bạn.
Phương tiện hiệu quả nhất để giảm lãng phí đầu ra là đặt ra quy tắc cho AI. Sử dụng hướng dẫn hệ thống để nói rõ: Không cần chào hỏi, không cần giải thích, không cần tái diễn yêu cầu, trả lời trực tiếp.
Các quy tắc này chỉ cần thiết lập một lần, sau đó sẽ có hiệu lực trong mỗi cuộc trò chuyện, là biện pháp quản lý tài chính thực sự "đầu tư một lần, hưởng lợi vĩnh viễn". Tuy nhiên, khi xây dựng quy tắc, nhiều người rơi vào một sai lầm khác: sử dụng ngôn ngữ tự nhiên dài dòng để xếp chồng hướng dẫn.
Dữ liệu thực nghiệm của các kỹ sư cho thấy, hiệu suất của hướng dẫn không phải nằm ở số từ, mà phải nằm ở độ dày. Ép một đoạn văn 500 từ của hướng dẫn hệ thống xuống còn 180 từ, thông qua việc loại bỏ các lời mời không ý nghĩa, kết hợp các hướng dẫn trùng lặp, và tái cấu trúc đoạn văn thành danh sách ngắn gọn, chất lượng đầu ra của AI gần như không biến động, nhưng mức tiêu thụ Token mỗi lần gọi có thể giảm đến 64%.
Điều khiển đầu ra bằng cách hạn chế chiều dài cũng là một biện pháp kiểm soát tích cực hơn. Rất nhiều người không bao giờ thiết lập giới hạn đầu ra, để cho phép AI tự do sáng tạo, điều này dẫn đến việc mất kiểm soát về chi phí. Bạn có thể chỉ cần một câu ngắn kết thúc, nhưng AI lại tạo ra một bài luận văn dài 800 từ chỉ để thể hiện một cái gì đó "thông minh và chân thành".
Nếu bạn đang tìm kiếm dữ liệu tinh khiết, hãy bắt buộc AI trả về định dạng có cấu trúc, chứ không phải mô tả bằng ngôn ngữ tự nhiên dài dòng. Trong trường hợp mang cùng lượng thông tin, mức tiêu thụ Token của định dạng JSON thấp hơn đáng kể so với đoạn văn không cấu trúc. Điều này xảy ra vì dữ liệu có cấu trúc loại bỏ tất cả các từ nối dư thừa, giới từ, và các siêu dẫn chứng giải thích, chỉ giữ lại nhân tâm logic có tính chất cao. Trong thời đại AI, bạn nên nhận thức rõ rằng điều đáng trả tiền là giá trị của kết quả, chứ không phải là phần tự hoại vô nghĩa của AI.
Ngoài ra, "suy nghĩ quá mức" của AI cũng đang gặm nhấm số dư tài khoản của bạn một cách điên cuồng.
Một số mô hình cao cấp có chế độ "suy luận mở rộng", sẽ tiến hành suy luận nội bộ trước khi trả lời. Quá trình suy luận này cũng được tính phí, và được tính dựa trên giá trị đầu ra, rất đắt đỏ.
Chế độ này gốc rễ là dành cho "những nhiệm vụ phức tạp cần hỗ trợ logic chi tiết". Tuy nhiên, hầu hết mọi người khi hỏi câu hỏi đơn giản cũng chọn chế độ này. Đối với những nhiệm vụ không cần suy luận sâu, hãy nói rõ với AI "không cần giải thích suy nghĩ, trả lời trực tiếp", hoặc tắt chế độ suy luận mở rộng thủ công, cũng có thể giúp bạn tiết kiệm được một khoản đáng kể.
Không để AI đào mảnh ký ức cũ
Các mô hình lớn không có bộ nhớ thực sự, chúng chỉ đang mắc kẹt trong việc đào mảnh ký ức cũ.
Đây là một cơ chế cơ bản mà nhiều người không biết. Mỗi khi bạn gửi một tin nhắn mới trong cửa sổ trò chuyện, AI không bắt đầu từ câu của bạn, mà lại đọc lại tất cả nội dung đã trò chuyện trước đó, bao gồm từng vòng trò chuyện, mỗi đoạn mã, mỗi tài liệu tham khảo, trước khi trả lời bạn.
Trong hóa đơn Token này, việc "học vững để biết mới" không phải là miễn phí. Khi các vòng lặp trò chuyện chồng chất lên nhau, ngay cả khi bạn chỉ đơn giản hỏi về một từ, chi phí của việc AI phải đọc lại toàn bộ lịch sử trò chuyện tăng lên theo cấp số mũ. Cơ chế này quyết định rằng, càng nặng lịch sử trò chuyện, mỗi câu hỏi của bạn càng đắt đỏ.
Một số người đã theo dõi 496 cuộc trò chuyện thực sự có chứa 20 tin nhắn trở lên và phát hiện rằng tin nhắn thứ 1 trung bình đọc 14.000 Token, mỗi tin có chi phí khoảng 3,6 cent Mỹ; đến khi đến tin nhắn thứ 50, trung bình đọc 79.000 Token, mỗi tin có chi phí khoảng 4,5 cent Mỹ, tăng đến 80% hoàn toàn giống nhau. Và ngoài ra, ngữ cảnh càng ngày càng dài, khi đến tin nhắn thứ 50, ngữ cảnh mà AI cần xử lý lại đã là 5,6 lần so với tin nhắn thứ 1.
Để giải quyết vấn đề này, thói quen đơn giản nhất là: một nhiệm vụ, một hộp thoại.
Khi một chủ đề được thảo luận xong, hãy mạnh dạn bắt đầu một cuộc trò chuyện mới, đừng coi AI như một cửa sổ trò chuyện không bao giờ tắt nguồn. Thói quen này nghe có vẻ đơn giản, nhưng rất nhiều người không thể làm được, luôn luôn nghĩ rằng "nếu như cần sử dụng lại nội dung trước đó". Trên thực tế, những "nếu như" bạn lo lắng đa phần không xảy ra, và để đối phó với điều đó, bạn đã trả thêm một số tiền gấp đôi trên mỗi tin nhắn mới.
Khi cuộc trò chuyện thực sự cần phải tiếp tục, nhưng ngữ cảnh đã trở nên rất dài, chúng ta có thể sử dụng các tính năng nén của một số công cụ. Claude Code có một lệnh /compact, có thể rút ngắn lịch sử trò chuyện dài lê thê thành một bản tóm tắt ngắn gọn, giúp bạn thực hiện một cuộc chia tay số học cyber.
Còn một logic tiết kiệm gọi là Prompt Caching (Bộ nhớ đệm lời nhắc). Nếu bạn lặp đi lặp lại việc sử dụng cùng một đoạn từ lời nhắc hệ thống, hoặc mỗi lần trò chuyện bạn đều cần tham chiếu đến cùng một tài liệu tham khảo, AI sẽ đệm nội dung này, lần gọi sau chỉ mất một khoản phí đọc đệm rất nhỏ, không phải trả mỗi lần theo giá đầy đủ.
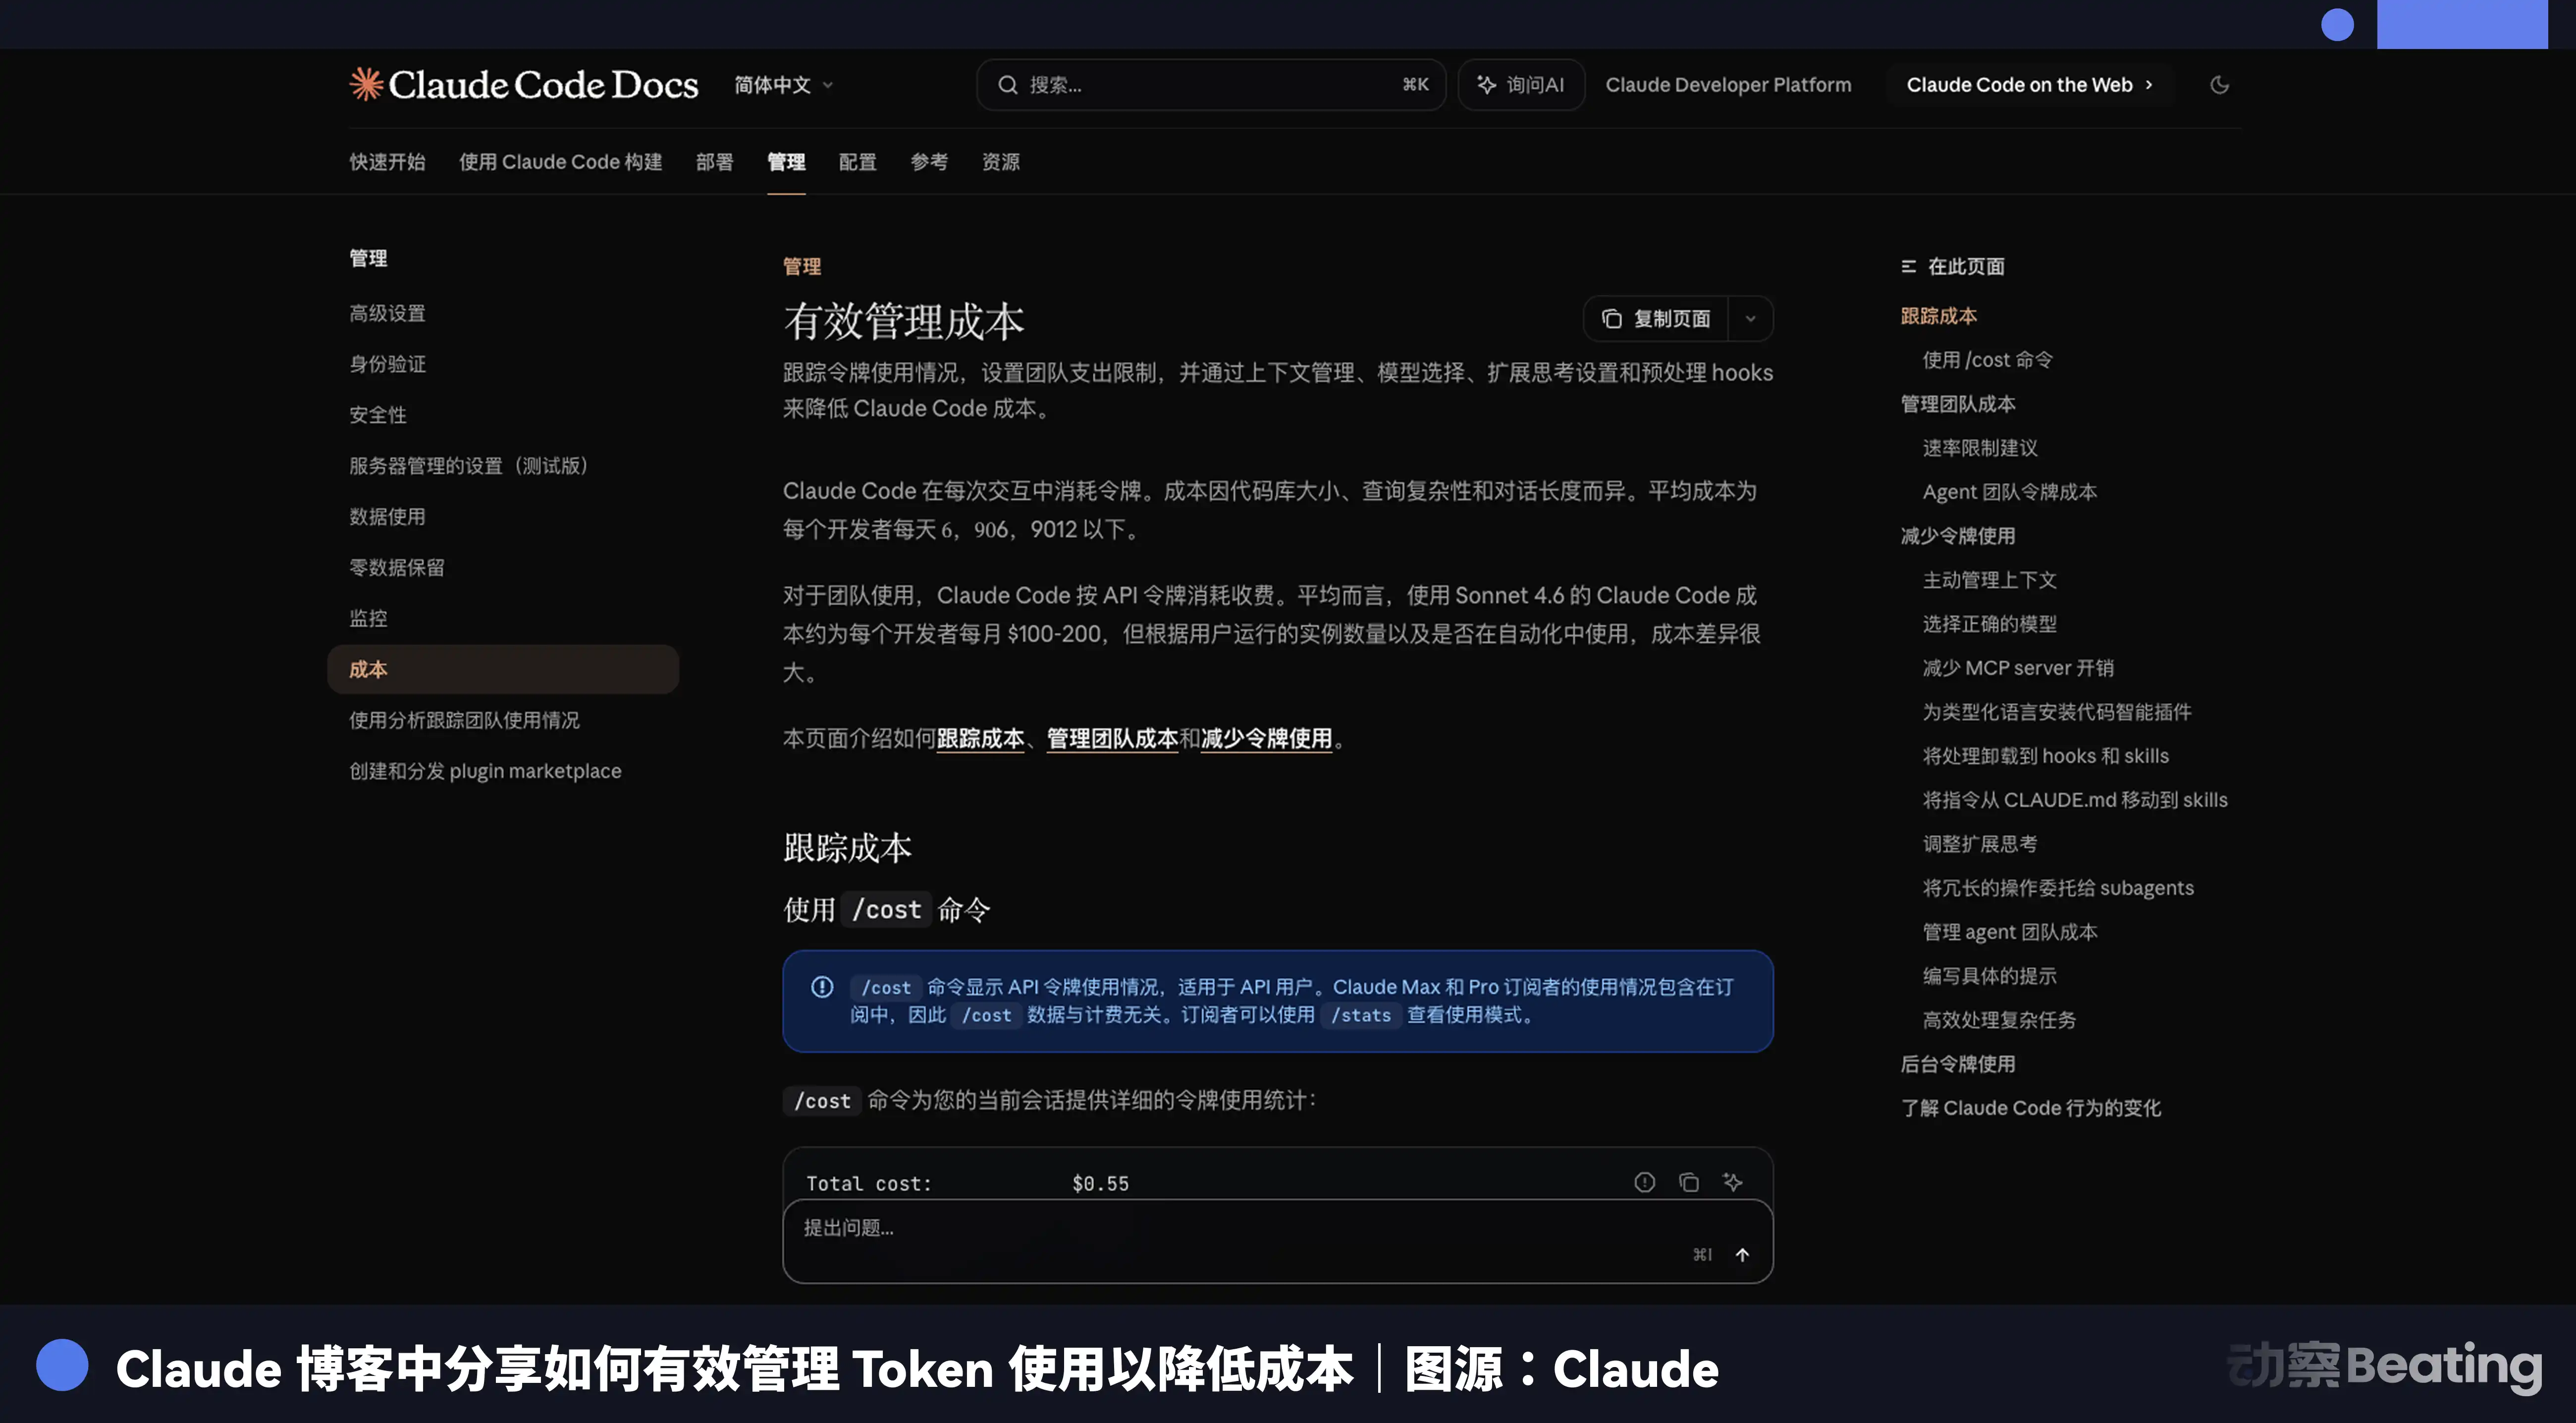
Giá chính thức của Anthropic cho thấy, giá Token bị đệm là 1/10 giá bình thường. Prompt Caching của OpenAI cũng có thể giảm chi phí nhập của bạn khoảng 50%. Một bài báo được công bố vào tháng 1 năm 2026 trên arXiv, đã thử nghiệm nhiều nhiệm vụ dài hạn của các nền tảng AI, phát hiện rằng Bộ nhớ đệm lời nhắc có thể giảm chi phí API từ 45% đến 80%.
Nghĩa là, cùng một nội dung, lần đầu tiên cung cấp cho AI cần trả giá đầy đủ, sau đó mỗi lần gọi chỉ cần trả 1/10. Đối với những người phải sử dụng lại hàng ngày cùng một tập tài liệu chuẩn hoặc lời nhắc hệ thống, tính năng này có thể giúp tiết kiệm được một lượng lớn Token.
Nhưng Bộ Nhớ Lưu Tạm (Prompt Caching) có một điều kiện tiên quyết, đó là nội dung và thứ tự của từ gợi ý của hệ thống bạn phải giữ nguyên như trong tài liệu tham khảo và phải đặt ở đầu cuộc trò chuyện. Một khi nội dung có bất kỳ thay đổi nào, bộ nhớ cache sẽ bị vô hiệu hóa và sẽ tính giá theo toàn bộ. Vì vậy, nếu bạn có một bộ quy tắc làm việc cố định, hãy giữ nguyên nó và không thay đổi một cách tùy tiện.
Một mẹo quản lý bối cảnh cuối cùng là tải theo yêu cầu. Nhiều người thích ném tất cả các quy định, tài liệu, lưu ý một cách chung chung vào từ gợi ý của hệ thống, lý do vẫn là "đề phòng".
Nhưng chi phí của việc làm đó là, bạn thực sự chỉ đang thực hiện một công việc rất đơn giản, nhưng buộc phải tải lên vài nghìn từ quy tắc, lãng phí nhiều Token không cần thiết. Tài liệu chính thức của Claude Code đề xuất giữ cho CLAUDE.md dưới 200 dòng, chia các quy định chuyên sâu của các tình huống khác nhau thành các tệp kỹ năng độc lập, tải lên quy định của tình huống nào khi cần đến tình huống đó. Giữ cho bối cảnh hoàn toàn trong sáng, đó chính là sự tôn trọng tối cao đối với sức mạnh tính toán.
Đừng đi mua thực phẩm bằng Porsche
Các mô hình AI khác nhau có sự chênh lệch giá cả lớn.
Claude Opus 4.6 yêu cầu 5 đô la cho mỗi triệu Token đầu vào, 25 đô la cho mỗi đầu ra, trong khi Claude Haiku 3.5 chỉ cần 0.8 đô la cho mỗi đầu vào, 4 đô la cho mỗi đầu ra, chênh lệch gần 6 lần. Để mô hình cấp cao nhất đi thu thập dữ liệu, sắp xếp định dạng, không chỉ chậm mà còn rất đắt đỏ.
Việc sử dụng một cách thông minh là mang tư duy "phân công giai cấp" phổ biến trong xã hội loài người của chúng ta vào xã hội AI, giao các nhiệm vụ với độ khó khác nhau cho các mô hình với giá khác nhau.
Giống như khi thuê người trong thế giới thực để làm việc, bạn sẽ không đi thuê một chuyên gia lương hàng năm triệu đô la để đi làm công trình xây dựng. AI cũng vậy. Tài liệu chính thức của Claude Code cũng rõ ràng khuyến nghị: Sonnet xử lý hầu hết các nhiệm vụ lập trình, Opus dành cho quyết định kiến trúc phức tạp và luận cứ bước đoạn, và giao nhiệm vụ con đơn giản cho Haiku.
Giải pháp thực thi cụ thể hơn là xây dựng một "luồng công việc hai giai đoạn". Trong giai đoạn đầu, sử dụng các mô hình cơ bản miễn phí hoặc giá rẻ để thực hiện các công việc rác rưởi ban đầu như thu thập dữ liệu, làm sạch định dạng, tạo bản nháp ban đầu, phân loại và tóm tắt đơn giản. Sau đó, trong giai đoạn thứ hai, đưa những tinh chất đã được chọn lọc và tinh khiết cao vào những mô hình cấp cao nhất để thực hiện quyết định lõng lẻo và raffinage sâu.
Ví dụ, nếu bạn cần phân tích một báo cáo ngành dày 100 trang, bạn có thể sử dụng trước Gemini Flash để trích xuất dữ liệu chính và kết luận từ báo cáo, tổ chức thành một bản tóm tắt 10 trang, sau đó đưa bản tóm tắt này cho Claude Opus thực hiện phân tích sâu và đưa ra quyết định. Luồng công việc hai giai đoạn này giúp giảm chi phí đáng kể trong khi đảm bảo chất lượng.
Điều phức tạp hơn so với việc xử lý đơn giản theo đoạn là phân công công việc sâu bằng việc phân rã nhiệm vụ dựa trên công việc. Một nhiệm vụ kỹ thuật phức tạp có thể được phân chia thành nhiều nhiệm vụ con độc lập và phù hợp nhất với mô hình.
Ví dụ, một nhiệm vụ đòi hỏi viết mã có thể để mô hình giá rẻ viết cấu trúc và mã mẫu trước, sau đó chỉ giao phần logic cốt lõi cho mô hình đắt tiền thực hiện. Mỗi nhiệm vụ con có bối cảnh sạch sẽ, tập trung, đưa ra kết quả chính xác hơn và chi phí thấp hơn.
Ban đầu, Bạn không cần phải Chi Token
Mọi thảo luận trước đó, về bản chất đều giải quyết vấn đề chi tiền một cách chiến lược, nhưng một tiềm ẩn logic cơ bản đã bị nhiều người lơ ý: Hành động này, liệu có cần phải chi Token không?
Sự tiết kiệm tối đa không phải là việc tinh chỉnh thuật toán, mà là quyết định loại bỏ. Chúng ta quen với việc tìm kiếm câu trả lời toàn năng từ trí tuệ nhân tạo, nhưng quên rằng trong nhiều trường hợp, triệu chứng mô hình lớn giá đắt chỉ giống như việc dùng pháo cao xạ bắn muỗi.
Ví dụ, cho phép trí tuệ nhân tạo xử lý email tự động, nó sẽ xem mỗi email như một nhiệm vụ độc lập để hiểu, phân loại và trả lời, tiêu tốn một lượng lớn Token. Nhưng nếu bạn dành 30 giây để nhìn qua hộp thư đến, lọc ra những email rõ ràng không cần trí tuệ nhân tạo xử lý, sau đó giao phần còn lại cho trí tuệ nhân tạo, chi phí ngay lập tức giảm xuống một phần nhỏ. Khả năng phán đoán của con người không phải là rào cản ở đây, mà là bộ lọc tốt nhất.
Người ta thời Điện Telegram biết, mỗi từ thừa đi nữa sẽ tốn bao nhiêu tiền, vì vậy họ sẽ cân nhắc, đó là một loại nhận thức trực quan về tài nguyên. Thời đại Trí tuệ Nhân tạo cũng vậy, khi bạn thực sự biết cần phải chi bao nhiêu tiền để trí tuệ nhân tạo nói thêm một câu, bạn tự nhiên sẽ cân nhắc xem việc đó có đáng giá để trí tuệ nhân tạo thực hiện không, nhiệm vụ này cần mô hình cao cấp hay mô hình giá rẻ, và mảng văn bản này còn có ý nghĩa hay không.
Loại cân nhắc này, chính là khả năng tiết kiệm nhất. Trong thời đại nguồn lực ngày càng đắt đỏ, cách sáng suốt nhất không phải là để trí tuệ nhân tạo thay thế con người, mà là để trí tuệ nhân tạo và con người làm những việc mà họ giỏi. Khi khả năng nhạy cảm đối với Token này trở thành một thói quen tự nhiên, bạn mới thực sự thoát khỏi việc phụ thuộc vào nguồn lực tính toán, và trở lại là chủ nhân của nguồn lực tính toán.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan