Vitalik: Lớp 3 như thế nào mới có ý nghĩa?
Tiêu đề gốc: "Loại lớp 3 nào có ý nghĩa?"
Tác giả gốc: Vitalik
Bản tổng hợp gốc: Dong Yiming, Chain Catcher
Đặc biệt cảm ơn Georgios Konstantopoulos, Karl Floersch và nhóm Starkware vì những phản hồi và đánh giá của họ.
Một chủ đề thường được nhắc đến trong các cuộc thảo luận mở rộng quy mô lớp 2 là khái niệm về "lớp 3". Nếu chúng ta có thể xây dựng giao thức lớp 2 gắn với lớp 1 với mục đích chính là đạt được tính bảo mật và tăng khả năng mở rộng của nó, thì chúng ta chắc chắn có thể xây dựng giao thức lớp 2 gắn với lớp 1 để đạt được bảo mật và tăng khả năng mở rộng của nó. bằng cách thêm nhiều giao thức lớp 3 có khả năng mở rộng hơn?
Một phiên bản đơn giản của ý tưởng này là: nếu bạn có một giải pháp, bạn có thể mang lại cho bạn sự tăng trưởng bậc hai, bạn có thể xếp chồng nó lên không giải pháp hàng đầu và đạt được sự tăng trưởng theo cấp số nhân? Những ý tưởng tương tự bao gồm my bài viết về khả năng mở rộng năm 2015 và trong các tiện ích mở rộng nhiều lớp được đề cập trong bài báo Plasma, v.v. Thật không may, khái niệm lớp 3 đơn giản như vậy không dễ để hình thành một giải pháp khả thi. Luôn có thứ gì đó trong thiết kế không thể xếp chồng lên nhau và sẽ chỉ giúp bạn tăng khả năng mở rộng một lần do hạn chế về tính khả dụng của dữ liệu, sự phụ thuộc vào băng thông lớp 1 để trích xuất khẩn cấp hoặc nhiều vấn đề khác.
Các ý tưởng mới hơn về lớp 3, chẳng hạn như Các khung do Starkware đề xuất phức tạp hơn: chúng không chỉ xếp chồng lên nhau những thứ giống nhau mà còn chỉ định các cách sử dụng khác nhau cho lớp 2 và lớp 3. Các hình thức tiềm năng của phương pháp này có thể phát huy tác dụng nếu nó được thực hiện đúng cách. Bài viết này sẽ trình bày chi tiết những gì có thể có và có thể không có ý nghĩa trong kiến trúc ba tầng.
Tại sao bạn không thể tiếp tục mở rộng quy mô bằng cách xếp chồng các bản cuộn lên trên các bản tổng hợp?
Bản tổng hợp (xem hướng dẫn của tôi tại đây ) là một công nghệ mở rộng quy mô kết hợp các công nghệ khác nhau để giải quyết hai nút thắt chính trong việc mở rộng quy mô khi chạy một chuỗi khối: tính toán và dữ liệu. Việc tính toán đã được giải quyết bằng các phương pháp như "bằng chứng gian lận" hoặc SNARK, dựa trên Cực kỳ Một số lượng nhỏ người tham gia xử lý và xác minh từng khối, yêu cầu những người khác chỉ thực hiện một số lượng nhỏ phép tính để kiểm tra xem quy trình chứng minh đã được hoàn thành chính xác hay chưa. Các sơ đồ này, đặc biệt là SNARK, có khả năng mở rộng gần như vô hạn; chúng ta có thể tiếp tục tạo "SNARK của nhiều SNARK" để giảm nhiều phép tính hơn thành một bằng chứng duy nhất.
Dữ liệu thì khác. Rollup sử dụng một loạt kỹ thuật nén để giảm lượng dữ liệu mà giao dịch cần lưu trữ trên chuỗi: Chuyển tiền đơn giản giảm từ ~100 byte xuống ~16 byte, chuyển ERC20 trong chuỗi tương thích EVM từ ~180 từ Kích thước giảm xuống khoảng 23 byte và giao dịch ZK-SNARK bảo vệ quyền riêng tư có thể được nén từ khoảng 600 byte đến khoảng 80 byte. Nén khoảng 8 lần trong mọi trường hợp. Nhưng quá trình tổng hợp vẫn cần cung cấp dữ liệu trên chuỗi trong một phương tiện được đảm bảo là người dùng có thể truy cập và xác minh được, để người dùng có thể tính toán độc lập trạng thái của quá trình tổng hợp và tham gia với tư cách là người chuẩn bị khi người dùng hiện tại ngừng hoạt động ngoại tuyến. Dữ liệu có thể được nén một lần, nhưng không được nén lại - - - Nếu có thể, thì thường có cách đưa logic của bộ nén thứ hai vào bộ nén thứ nhất và nhận được lợi ích tương tự từ việc nén nó một lần. Vì vậy, "Rollups on top of Rollups" thực sự không mang lại lợi ích lớn về khả năng mở rộng, nhưng, như chúng ta sẽ thấy bên dưới, mẫu này có thể được sử dụng cho các mục đích khác.
Vậy phiên bản "lành mạnh" của layer 3 là gì?
Chà, hãy xem Starkware đang ủng hộ điều gì trong bài đăng của họ về lớp 3. Starkware được hình thành bởi những nhà mật mã rất thông minh và tỉnh táo, vì vậy nếu họ quảng cáo l ayer 3s, phiên bản của chúng sẽ phức tạp hơn nhiều so với "nếu các bản cuộn nén dữ liệu 8 lần thì rõ ràng các bản cuộn lên trên các bản cuộn sẽ nén dữ liệu 64 lần."
Đây là hình ảnh từ bài viết của Starkware:
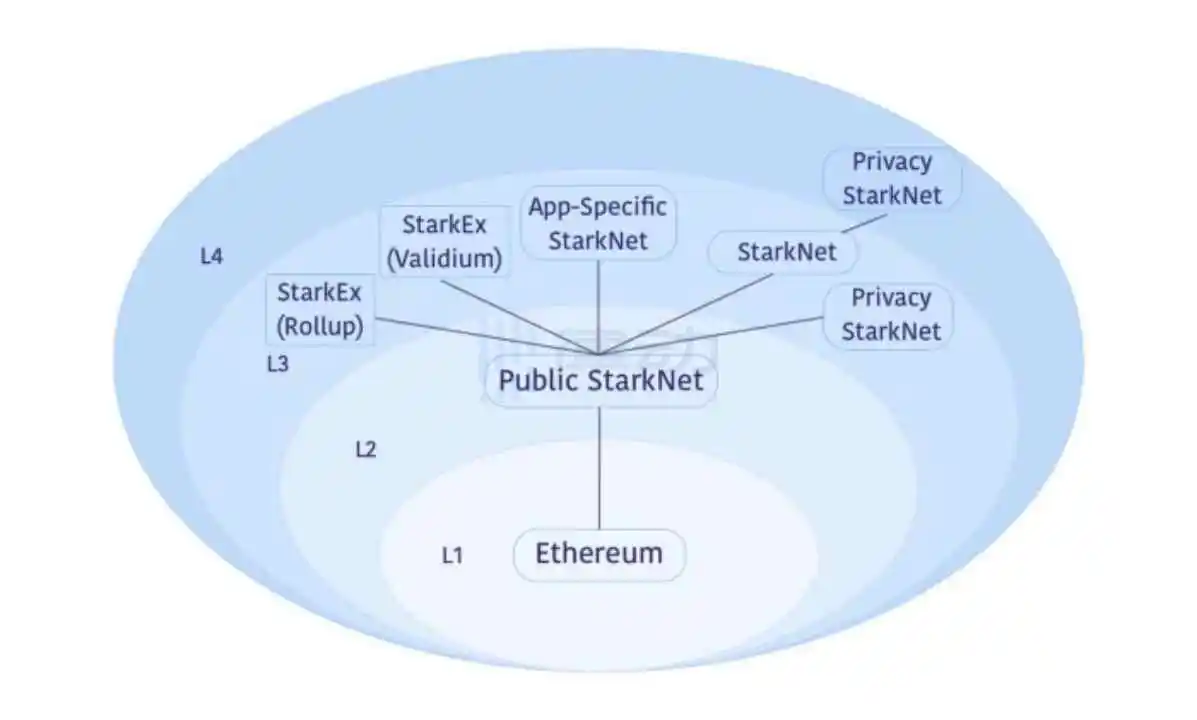
Vài trích dẫn:
Hình trên mô tả hệ sinh thái này Một ví dụ. L3 của nó bao gồm:
1. StarkNet có sẵn dữ liệu Validium, thường được sử dụng trong các ứng dụng cực kỳ nhạy cảm với giá cả.
2. Các hệ thống StarkNet dành riêng cho ứng dụng được tùy chỉnh để có hiệu suất ứng dụng tốt hơn, chẳng hạn như bằng cách sử dụng các cấu trúc lưu trữ được chỉ định hoặc nén tính khả dụng của dữ liệu để đáp ứng.
3. Các hệ thống StarkEx (chẳng hạn như các hệ thống phục vụ dYdX, Sorare, Immutable và DeversiFi) có sẵn dữ liệu Validium hoặc Rollup, ngay lập tức mang lại những khả năng đã được chứng minh cho lợi thế về khả năng mở rộng của StarkNet.
4. Phiên bản StarkNet quyền riêng tư (cũng là L4 trong ví dụ này) cho phép tồn tại các giao dịch thuộc loại bảo vệ quyền riêng tư mà không cần đưa chúng vào StarkNet công khai.
Chúng ta có thể cô đọng bài viết thành “Ba tầm nhìn của “L3s””:
· L2 được sử dụng để mở rộng dung lượng và L3 được sử dụng cho các chức năng tùy chỉnh, chẳng hạn như quyền riêng tư. Trong tầm nhìn này, không có nỗ lực cung cấp "sự tăng trưởng bậc hai về khả năng mở rộng"; thay vào đó, có một lớp trong ngăn xếp giúp mở rộng ứng dụng và sau đó có các lớp độc lập để đáp ứng nhu cầu chức năng tùy chỉnh của các trường hợp sử dụng khác nhau.
· L2 được dùng để mở rộng chung và L3 được dùng để mở rộng có thể tùy chỉnh. Khả năng chia tỷ lệ tùy chỉnh có thể có nhiều dạng khác nhau: các ứng dụng dành riêng cho ứng dụng sử dụng thứ gì đó không phải EVM để tính toán, các bản tổng hợp nén dữ liệu được tối ưu hóa cho định dạng dữ liệu dành riêng cho ứng dụng (bao gồm cả việc kết hợp "dữ liệu" với "dữ liệu" trong mỗi khối). bằng chứng" và thay thế bằng chứng bằng một SNARK duy nhất), v.v.
· L2 được sử dụng cho các tiện ích mở rộng không cần độ tin cậy (cuộn lên) và L3 được sử dụng cho các tiện ích mở rộng có độ tin cậy yếu (validium). Validium là một hệ thống sử dụng SNARK để xác minh các phép tính nhưng để lại dữ liệu sẵn có cho những người đáng tin cậy bên thứ ba hoặc ủy ban. Theo ý kiến của tôi, Validium bị đánh giá thấp một cách nghiêm trọng: đặc biệt, nhiều ứng dụng "blockchain doanh nghiệp" thực sự có thể được phục vụ tốt hơn bởi những người hoạt động chạy Validium và thường xuyên gửi hàm băm đến các máy chủ tập trung của chuỗi. Validium kém an toàn hơn rollup nhưng có thể rẻ hơn nhiều.
Trong tôi Có vẻ như cả ba hình ảnh về cơ bản đều đúng đắn. Ý tưởng cho rằng việc nén dữ liệu chuyên dụng cần có nền tảng riêng có lẽ là tuyên bố yếu nhất - rất dễ thiết kế L2 với sơ đồ nén lớp cơ sở chung mà người dùng có thể tự động điều chỉnh tỷ lệ bằng các bộ nén phụ dành riêng cho ứng dụng, nhưng ngoài ra, các trường hợp sử dụng này đều hợp pháp. Nhưng điều đó vẫn để lại một câu hỏi lớn: Cấu trúc ba tầng có phải là cách phù hợp để đạt được những mục tiêu này không? Mục đích của việc neo xác thực, hệ thống bảo mật và môi trường tùy chỉnh vào L2 thay vì chỉ L1 là gì? Hóa ra câu trả lời cho câu hỏi này khá phức tạp.
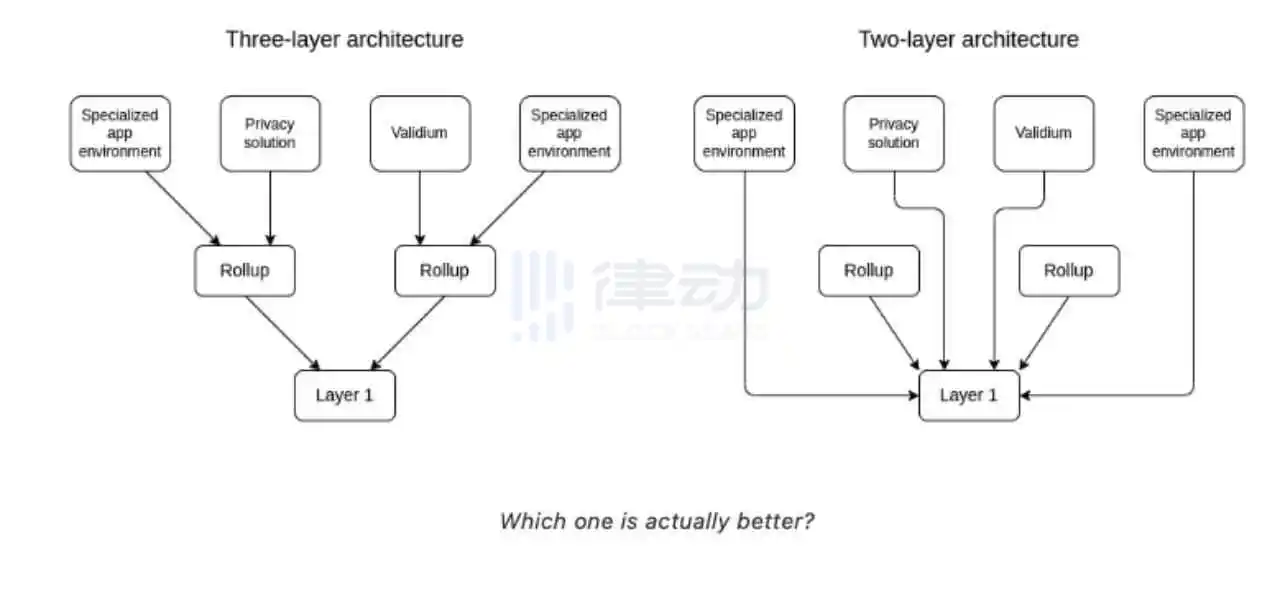
Trong cây tập hợp con của L2, việc gửi và rút tiền có trở nên Rẻ hơn không, dễ dàng hơn?
Một lập luận khả dĩ về tính ưu việt của mô hình ba tầng so với mô hình hai tầng là mô hình ba tầng cho phép toàn bộ các hệ sinh thái phụ tồn tại trong một môi trường tổng hợp duy nhất, cho phép trong hệ sinh thái đó Các hoạt động liên miền có thể diễn ra rất rẻ mà không cần phải thực hiện thông qua L1 đắt tiền.
Nhưng hóa ra tiền gửi và rút tiền có thể rất rẻ ngay cả giữa hai L2 hoặc thậm chí L3. Chìa khóa của vấn đề này là token và các tài sản khác không nhất thiết phải được phát hành trong chuỗi gốc. Điều đó có nghĩa là bạn có thể sở hữu ERC20 trên Arbitrum Mã thông báo , tạo trình bao bọc của nó trên Optimism và di chuyển qua lại giữa hai bên mà không có bất kỳ giao dịch L1 nào!
Hãy xem hệ thống này hoạt động như thế nào. Có hai loại hợp đồng thông minh: hợp đồng cơ sở trên Arbitrum và gói trên Optimism Mã thông báo hợp đồng. Để chuyển từ Trọng tài sang Lạc quan, bạn cần phải Mã thông báo Đã gửi đến hợp đồng cơ bản, hợp đồng này sẽ tạo ra biên nhận. Sau khi Trọng tài được hoàn tất, bạn có thể lấy bằng chứng Merkle về biên nhận đó và root nó ở trạng thái L1, sau đó gửi nó đến trình bao bọc trên Optimism Mã thông báo hợp đồng, xác minh nó và cấp cho bạn một gói Mã thông báo . Để di chuyển mã thông báo trở lại, bạn có thể thực hiện ngược lại tương tự.
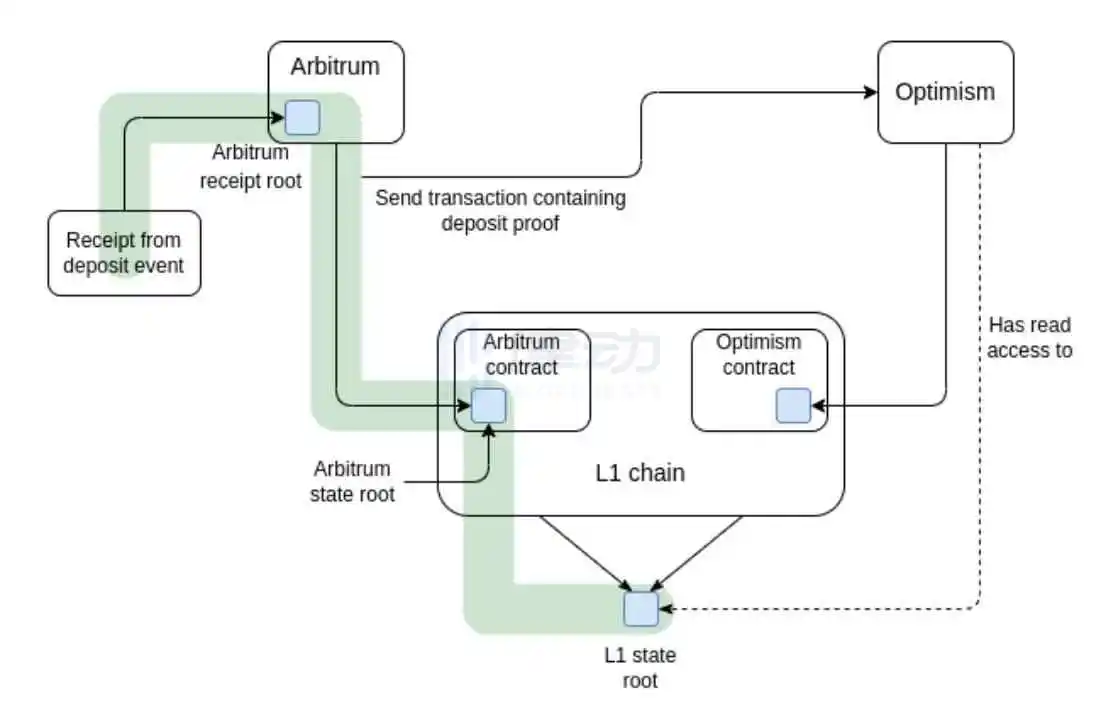
Mặc dù trong việc chứng minh Arbitrum Đường dẫn Merkle cần thiết cho khoản tiền gửi đi qua trạng thái L1 và Optimism chỉ cần đọc gốc trạng thái L1 để xử lý khoản tiền gửi - không yêu cầu giao dịch L1. Lưu ý rằng vì dữ liệu tổng hợp là tài nguyên khan hiếm nhất nên việc triển khai thực tế sơ đồ này sẽ sử dụng trực tiếp bằng chứng SNARK hoặc KZG thay vì bằng chứng Merkle để tiết kiệm dung lượng.
Với nền tảng L1 Mã thông báo Khi so sánh, giải pháp này có một điểm yếu chết người (ít nhất là trong trường hợp lạc quan): tiền gửi vẫn cần phải chờ thời điểm ngăn chặn gian lận. nếu như Mã thông báo Bắt nguồn từ L1, cần có độ trễ một tuần để rút tiền từ Arbitrum hoặc Optimism sang L1, nhưng tiền gửi được thực hiện ngay lập tức. Tuy nhiên, trong chương trình này, cả việc gửi và rút tiền đều có độ trễ một tuần. Điều đó nói lên rằng, không rõ liệu kiến trúc ba tầng trên các bản tổng hợp lý tưởng có tốt hơn hay không: có rất nhiều điểm phức tạp về mặt kỹ thuật trong việc đảm bảo rằng các trò chơi ngăn chặn gian lận diễn ra bên trong một hệ thống tự chạy trên các trò chơi ngăn chặn gian lận là an toàn.
May mắn thay, không có vấn đề nào trong số này sẽ xảy ra với bản tổng hợp ZK. Vì lý do an toàn, các bản tổng hợp ZK không yêu cầu khoảng thời gian chờ kéo dài một tuần, nhưng chúng vẫn yêu cầu khoảng thời gian chờ ngắn hơn vì hai lý do khác (công nghệ thế hệ đầu tiên có thể yêu cầu 12 giờ). Đầu tiên, đặc biệt là các bản tổng hợp ZK-EVM có mục đích chung phức tạp hơn sẽ mất nhiều thời gian hơn để đáp ứng thời gian tính toán không thể song song của khối. Thứ hai, những cân nhắc về mặt kinh tế cho thấy rằng các chứng nhận cần phải được nộp không thường xuyên để giảm thiểu chi phí cố định liên quan đến các giao dịch chứng nhận. Thế hệ tiếp theo Công nghệ ZK-EVM, bao gồm phần cứng chuyên dụng, sẽ giải quyết vấn đề đầu tiên và hàng loạt vấn đề xác minh với kiến trúc tốt hơn có thể giải quyết vấn đề thứ hai. Điều chúng tôi muốn thảo luận tiếp theo là vấn đề tối ưu hóa và bằng chứng gửi hàng loạt.
Bản tổng hợp và bản hợp lệ có thời gian xác nhận so với sự cân bằng chi phí cố định. L3 có thể giúp giải quyết vấn đề này, nhưng còn điều gì khác có thể làm được điều này?
Chi phí tổng hợp cho mỗi giao dịch rất rẻ: chỉ cần 16-60 byte dữ liệu, tùy thuộc vào ứng dụng. Tuy nhiên, các đợt rollup cũng phải trả một khoản chi phí cố định cao mỗi khi gửi một loạt giao dịch tới chuỗi: các đợt rollup lạc quan yêu cầu 21.000 L1 gas21000 L1 gas mỗi lô /a>, hơn 400.000 gas cho các lần cuộn ZK (hàng triệu gas nếu bạn muốn cung cấp nội dung an toàn lượng tử chỉ bằng cách sử dụng STARKS ).
Tất nhiên, rollup có thể chỉ cần chọn đợi cho đến khi có giao dịch L2 với giá trị gas là 10 triệu để gửi toàn bộ lô (giao dịch), nhưng điều này sẽ cung cấp cho họ khoảng thời gian rất dài, buộc người dùng phải chờ lâu hơn để xác nhận tính bảo mật cao. Do đó, họ yêu cầu phải có sự cân bằng: khoảng cách giữa các lô dài hơn và chi phí tối ưu, hoặc khoảng cách giữa các lô ngắn hơn và chi phí tăng lên đáng kể.
Để cung cấp cho chúng tôi một số con số cụ thể, hãy xem xét tổng hợp ZK có chi phí 600.000 gas mỗi lô và xử lý quá trình truyền ERC20 được tối ưu hóa hoàn toàn (23 byte) có chi phí 368 gas cho mỗi giao dịch. Giả sử bản tổng hợp này đang được áp dụng từ đầu đến giữa và có TPS là 5. Chúng ta có thể tính toán lượng gas giữa mỗi giao dịch và khoảng thời gian theo đợt:
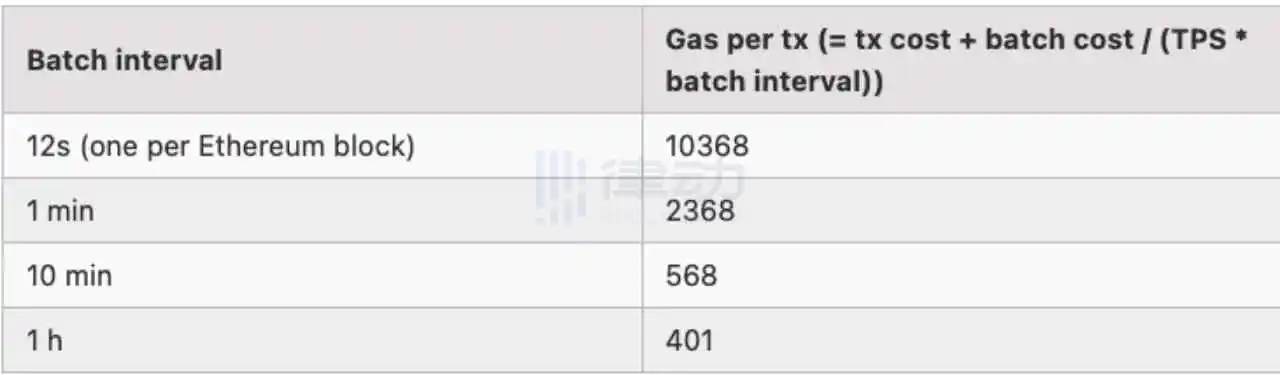
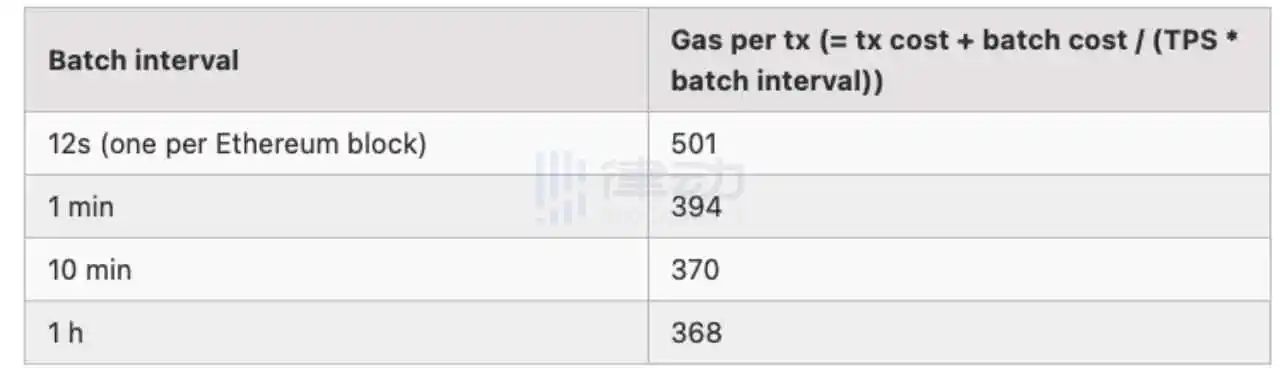
Nếu Chúng ta bước vào một thế giới có nhiều môi trường xác thực tùy chỉnh và dành riêng cho ứng dụng, nhiều môi trường trong số đó sẽ có tốc độ dưới 5 TPS. Vì vậy, việc xác định sự cân bằng giữa thời gian và chi phí bắt đầu trở nên rất quan trọng. Trên thực tế, mô hình "L3" đã giải quyết được vấn đề này! Bản tổng hợp ZK trong bản tổng hợp ZK, ngay cả khi triển khai đơn giản, cũng chỉ có chi phí cố định khoảng 8.000 gas lớp 1 (500 byte để chứng minh). Điều này sẽ thay đổi bảng trên thành:
Vấn đề về cơ bản đã được giải quyết, vì vậy L3s không tốt lắm? Có lẽ. Nhưng cần lưu ý rằng có một cách khác để giải quyết vấn đề này phải tuân theo ERC 4337 xác minh tổng hợpCảm hứng.
Chiến lược như sau. Ngày nay, nếu mỗi bản tổng hợp hoặc xác thực ZK đều nhận được bằng chứng thì bằng chứng Snew = STF(Đã bán,D): Gốc trạng thái mới phải là kết quả của việc xử lý chính xác dữ liệu giao dịch hoặc gia tăng trạng thái trên gốc trạng thái cũ. Trong sơ đồ mới này, ZK rollup sẽ chấp nhận một thông báo từ hợp đồng xác thực lô cho biết rằng nó đã xác minh bằng chứng của một loạt câu lệnh, mỗi câu lệnh có dạng Snew = STF(Sold,D). Các bằng chứng lô như vậy có thể được xây dựng thông qua sơ đồ SNARK đệ quy hoặc Halo tập hợp.
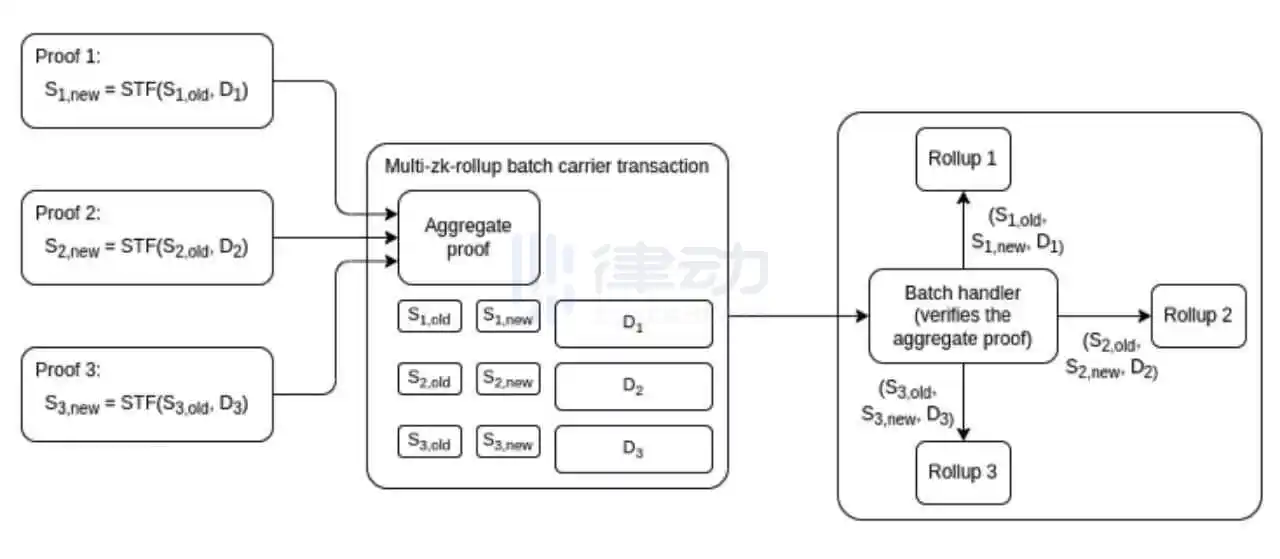
Đây sẽ là một cơ hội mở Giao thức: Bất kỳ bản tổng hợp ZK nào cũng có thể tham gia và bất kỳ người chứng minh lô nào cũng có thể tổng hợp bằng chứng từ bất kỳ bản tổng hợp ZK tương thích nào và nhận khoản bồi thường phí giao dịch từ đơn vị tổng hợp. Hợp đồng máy trộn sẽ xác minh bằng chứng một lần và sau đó gửi thông báo đến từng bản tổng hợp với (Đã bán, Smới, D) bộ ba. Ba thực tế cho việc sollups từ hợp đồng máy trộn sẽ được sử dụng làm bằng chứng cho thấy việc chuyển đổi có hiệu quả.
Nếu được tối ưu hóa đúng cách, chi phí của mỗi lần tổng hợp trong trường hợp này có thể lên tới gần 8000, trong đó 5000 được sử dụng để thêm ghi trạng thái cập nhật mới và 1280 được sử dụng cho gốc cũ và gốc mới, và thêm 1720 để xử lý dữ liệu linh tinh. Vì vậy, nó sẽ mang lại cho chúng ta khoản tiết kiệm tương tự. Starkware thực ra đã có thứ tương tự, được gọi là SHARP, mặc dù đây không phải (chưa) là một giao thức mở được cấp phép không cần thiết.
Một câu trả lời cho cách tiếp cận này có thể là: Nhưng đó không phải thực sự chỉ là một cách tiếp cận Lớp 3 khác sao? Thay vì lớp cơ sở <- cơ chế hàng loạt <- rollup hoặc validium, chúng ta sẽ có lớp cơ sở <- cơ chế hàng loạt <- rollup hoặc validium. Từ góc độ của một khuôn khổ triết học nhất định, điều này có thể đúng. Nhưng có một điểm khác biệt quan trọng: lớp giữa không phải là một hệ thống EVM đầy đủ phức tạp mà là một đối tượng được đơn giản hóa và chuyên môn hóa cao, do đó, nó có nhiều khả năng được bảo mật hơn và có nhiều khả năng hoạt động mà không cần chuyên dụng khác. Mã thông báo Được xây dựng trong bối cảnh, nó có nhiều khả năng được quản lý ở mức tối thiểu và không thay đổi theo thời gian.
Kết luận: "Lớp" chính xác là gì?
Cấu trúc chia tỷ lệ ba tầng bao gồm các sơ đồ chia tỷ lệ giống hệt nhau xếp chồng lên nhau thường không hoạt động tốt. Hình thức cuộn lên trên các bản cuộn (trong đó hai bản cuộn sử dụng cùng một công nghệ) cũng ít lý tưởng hơn. Tuy nhiên, kiến trúc ba tầng với L2 và L3 phục vụ các mục đích khác nhau có thể hoạt động. Các giá trị hợp lệ bên trên các bản tổng hợp thực sự có ý nghĩa, ngay cả khi chúng chắc chắn không phải là cách tốt nhất để thực hiện mọi việc lâu dài.
Tuy nhiên, một khi chúng ta bắt đầu đi vào chi tiết về kiến trúc nào có ý nghĩa, chúng ta sẽ gặp những câu hỏi triết học: "Các lớp" là gì và cái gì không? lớp cơ sở <- cơ chế hàng loạt <- rollup hoặc validium và lớp cơ sở <- rollup <- rollup hoặc validium thực hiện cùng một công việc, nhưng về cách thức hoạt động, lớp tổng hợp bằng chứng trông giống ERC-4337 hơn, thay vì cuộn lên. Thông thường, chúng tôi sẽ không gọi ERC-4337 là "layer2". Tương tự như vậy, chúng tôi không gọi Tornado Cash là "Layer2", vì vậy nếu muốn nhất quán, chúng tôi không gọi hệ thống con tập trung vào quyền riêng tư nằm trên L2 L3. nên được gọi là "Lớp" ngay từ đầu.
Có rất nhiều trường phái tư tưởng có thể có về vấn đề này. Sở thích cá nhân của tôi là giới hạn thuật ngữ "Lớp 2" cho những thứ có các thuộc tính sau:
1. Mục đích của chúng là cải thiện khả năng mở rộng
2. Họ tuân theo mô hình "blockchain trong blockchain": họ có cơ chế xử lý giao dịch riêng và trạng thái nội bộ riêng
2. p>
3. Chúng kế thừa tất cả tính bảo mật của chuỗi Ethereum
Do đó, các bản cuộn lý tưởng và các bản cuộn ZK là L2, nhưng việc xác minh, chứng minh- kế hoạch tổng hợp, ERC 4337, hệ thống bảo mật trên chuỗi và Solidity là một vấn đề khác. Có thể hợp lý khi gọi một số L3 này, nhưng có lẽ không phải tất cả; trong mọi trường hợp, có vẻ còn quá sớm để đưa ra một định nghĩa và kiến trúc của một hệ sinh thái đa tập hợp vẫn chưa được xác định rõ ràng, với hầu hết các cuộc thảo luận đều lấy chỉ đứng trên lý thuyết.
Nghĩa là, cuộc tranh luận về ngôn ngữ không quan trọng bằng câu hỏi kỹ thuật về cấu trúc nào thực sự có ý nghĩa nhất. Rõ ràng, một số "lớp" nhất định phục vụ các nhu cầu không mở rộng quy mô như quyền riêng tư có vai trò quan trọng và chức năng quan trọng của việc tổng hợp bằng chứng cần phải được thực hiện theo một cách nào đó, tốt nhất là thông qua các giao thức mở. Nhưng đồng thời, có những lý do kỹ thuật chính đáng để làm cho lớp giữa liên kết môi trường hướng tới người dùng và L1 đơn giản nhất có thể; trong nhiều trường hợp, việc trở thành "lớp keo" cho việc tổng hợp EVM có thể không phải là cách tiếp cận phù hợp. Tôi nghi ngờ rằng khi hệ sinh thái mở rộng L2 trưởng thành, các cấu trúc phức tạp hơn (và đơn giản hơn) được mô tả trong bài viết này sẽ bắt đầu đóng vai trò lớn hơn.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan