Cơ chế chứng minh cấp độ hạt nhân cho các mô hình học máy
Tiêu đề gốc: Chứng minh theo Kernel-Wise cho các mô hình học máy
Tác giả gốc: Zhiyong Fang
Làm sao để ăn một con voi? Ăn từng miếng một.
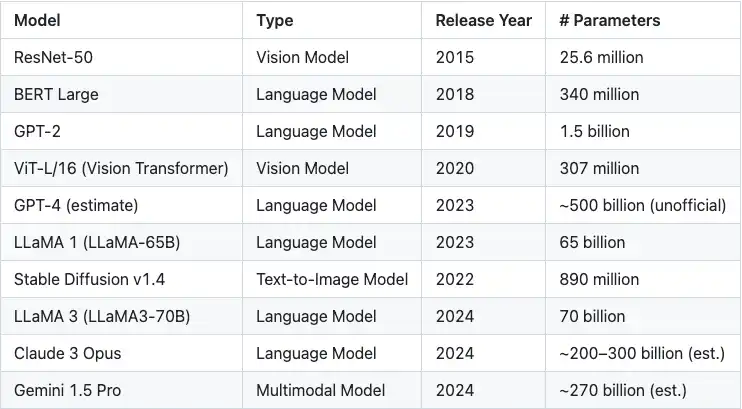
Trong những năm gần đây, các mô hình học máy đã đạt được những bước tiến vượt bậc với tốc độ đáng kinh ngạc. Khi khả năng của các mô hình tăng lên, độ phức tạp của chúng cũng tăng nhanh chóng - các mô hình tiên tiến ngày nay thường chứa hàng triệu hoặc thậm chí hàng tỷ tham số. Để giải quyết thách thức về quy mô này, nhiều hệ thống chứng minh không kiến thức đã xuất hiện, luôn cam kết đạt được sự cân bằng động giữa thời gian chứng minh, thời gian xác minh và quy mô chứng minh.
Bảng 1: Tăng trưởng theo cấp số nhân về quy mô tham số mô hình
Mặc dù hầu hết các công trình hiện tại trong lĩnh vực chứng minh không kiến thức tập trung vào việc tối ưu hóa chính hệ thống chứng minh, nhưng một khía cạnh quan trọng thường bị bỏ qua - cách chia đúng các mô hình lớn thành các mô-đun con nhỏ hơn, dễ quản lý hơn để chứng minh. Bạn có thể hỏi, tại sao điều này lại quan trọng như vậy?
Chúng ta hãy giải thích chi tiết:
Các mô hình học máy hiện đại thường có hàng tỷ tham số, vốn đã chiếm rất nhiều tài nguyên bộ nhớ ngay cả khi không có bất kỳ xử lý mật mã nào. Thách thức này được khuếch đại hơn nữa trong bối cảnh của Zero-Knowledge Proof (ZKP).
Mỗi tham số dấu phẩy động phải được chuyển đổi thành một phần tử trong trường số học, bản thân nó sẽ làm tăng mức sử dụng bộ nhớ khoảng 5 đến 10 lần. Ngoài ra, để mô phỏng chính xác các phép toán dấu phẩy động trong trường đại số, sẽ phát sinh thêm chi phí hoạt động, thường là khoảng 5 lần.
Cùng nhau, yêu cầu bộ nhớ chung của mô hình có thể tăng lên gấp 25 đến 50 lần so với kích thước ban đầu. Ví dụ, một mô hình có 1 tỷ tham số dấu phẩy động 32 bit có thể cần 100 đến 200 GB bộ nhớ chỉ để lưu trữ các tham số đã chuyển đổi. Xem xét chi phí chung của các giá trị tính toán trung gian và bản thân hệ thống chứng minh, mức sử dụng bộ nhớ chung dễ dàng vượt quá mức TB.
Các hệ thống chứng minh chính thống hiện tại, chẳng hạn như Groth16 và Plonk, thường cho rằng tất cả dữ liệu có liên quan có thể được tải vào bộ nhớ cùng lúc trong các triển khai chưa được tối ưu hóa. Mặc dù giả định này khả thi về mặt kỹ thuật, nhưng nó cực kỳ khó khăn trong điều kiện phần cứng thực tế và hạn chế rất nhiều tài nguyên tính toán chứng minh có sẵn.
Giải pháp của Polyhedra: zkCuda
ZkCuda là gì?
Như chúng tôi đã mô tả trong Tài liệu kỹ thuật zkCUDA:
ZkCUDA của Polyhedra là môi trường điện toán không kiến thức dành cho phát triển mạch hiệu suất cao, được thiết kế để cải thiện hiệu quả tạo bằng chứng. Không ảnh hưởng đến khả năng biểu đạt của mạch, zkCUDA có thể tận dụng hoàn toàn trình chứng minh cơ bản và tính song song của phần cứng để tạo bằng chứng ZK nhanh chóng.
Ngôn ngữ zkCUDA rất giống với CUDA về cú pháp và ngữ nghĩa, và rất thân thiện với các nhà phát triển có kinh nghiệm về CUDA. Ngôn ngữ này được triển khai trong Rust ở lớp dưới cùng để đảm bảo cả tính bảo mật và hiệu suất.
Với zkCUDA, các nhà phát triển có thể:
Xây dựng nhanh chóng các mạch ZK hiệu suất cao;
Lên lịch và sử dụng hiệu quả các tài nguyên phần cứng phân tán, chẳng hạn như GPU hoặc môi trường cụm hỗ trợ MPI, để đạt được khả năng tính toán song song quy mô lớn.
Tại sao lại là zkCUDA?
zkCuda là một khuôn khổ tính toán không kiến thức hiệu suất cao lấy cảm hứng từ điện toán GPU. Nó có thể chia các mô hình học máy quy mô cực lớn thành các đơn vị tính toán nhỏ hơn và dễ quản lý hơn (hạt nhân) và đạt được khả năng kiểm soát hiệu quả thông qua ngôn ngữ giao diện giống CUDA. Thiết kế này mang lại những lợi thế chính sau:
1. Lựa chọn hệ thống chứng minh phù hợp chính xác
zkCUDA hỗ trợ phân tích chi tiết từng hạt nhân tính toán và khớp nó với hệ thống chứng minh không kiến thức phù hợp nhất. Ví dụ:
Đối với các tác vụ tính toán song song cao, có thể sử dụng các giao thức như GKR có khả năng xử lý song song có cấu trúc tốt;
Đối với các tác vụ nhỏ hơn hoặc có cấu trúc không đều, sẽ phù hợp hơn khi sử dụng các hệ thống chứng minh như Groth16 có chi phí thấp trong các tình huống tính toán nhỏ gọn.
Bằng cách tùy chỉnh lựa chọn phụ trợ, zkCUDA có thể tối đa hóa lợi thế về hiệu suất của nhiều giao thức ZK khác nhau.
2. Lên lịch tài nguyên thông minh hơn và tối ưu hóa song song
Các hạt nhân chứng minh khác nhau có các yêu cầu tài nguyên khác nhau đáng kể đối với CPU, bộ nhớ và I/O. zkCUDA có thể đánh giá chính xác mức tiêu thụ tài nguyên của từng tác vụ và lên lịch thông minh để tối đa hóa thông lượng chung.
Quan trọng hơn, zkCUDA hỗ trợ phân phối tác vụ trên các nền tảng điện toán không đồng nhất—bao gồm CPU, GPU và FPGA—để đạt được mức sử dụng tối ưu các tài nguyên phần cứng và cải thiện đáng kể hiệu suất cấp hệ thống.
ZkCuda phù hợp tự nhiên với giao thức GKR
Mặc dù zkCuda được thiết kế như một khuôn khổ điện toán chung tương thích với nhiều hệ thống chứng minh không kiến thức, nhưng nó có mức độ phù hợp kiến trúc tự nhiên cao với giao thức GKR (Goldwasser-Kalai-Rothblum).
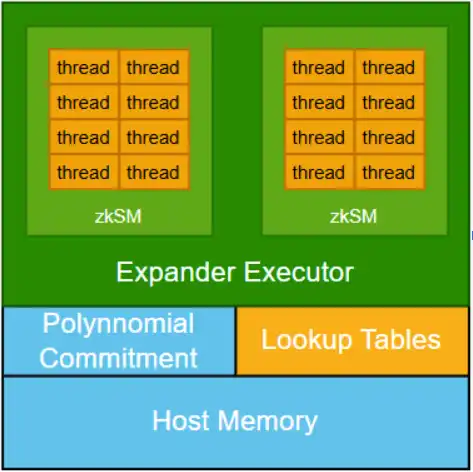
Về mặt thiết kế kiến trúc, zkCUDA kết nối nhiều hạt nhân tính toán phụ khác nhau bằng cách giới thiệu cơ chế cam kết đa thức để đảm bảo rằng tất cả các phép tính phụ chạy trên dữ liệu được chia sẻ nhất quán. Cơ chế này rất quan trọng để duy trì tính toàn vẹn của hệ thống, nhưng nó cũng mang lại chi phí tính toán đáng kể.
Ngược lại, giao thức GKR cung cấp một đường dẫn thay thế hiệu quả hơn. Không giống như các hệ thống không kiến thức truyền thống yêu cầu mỗi hạt nhân phải chứng minh đầy đủ các ràng buộc nội bộ của nó, GKR cho phép xác minh tính chính xác của phép tính được theo dõi đệ quy ngược từ đầu ra của hạt nhân đến đầu vào. Cơ chế này cho phép truyền tính chính xác giữa các hạt nhân thay vì xác minh đầy đủ trong từng mô-đun. Ý tưởng cốt lõi của nó tương tự như truyền ngược gradient trong học máy, theo dõi và truyền các tuyên bố về tính chính xác thông qua đồ thị tính toán.
Mặc dù việc hợp nhất các "gradient chứng minh" như vậy theo nhiều đường dẫn mang lại sự phức tạp nhất định, nhưng chính cơ chế này tạo thành cơ sở cho sự hợp tác sâu sắc giữa zkCUDA và GKR. Bằng cách sắp xếp các tính năng cấu trúc trong quy trình đào tạo học máy, zkCUDA dự kiến sẽ đạt được sự tích hợp hệ thống chặt chẽ hơn và tạo ra bằng chứng không kiến thức hiệu quả hơn trong các tình huống mô hình lớn.
Kết quả sơ bộ và định hướng tương lai
Chúng tôi đã hoàn thành quá trình phát triển ban đầu của khuôn khổ zkCuda và đã thử nghiệm thành công trong nhiều tình huống, bao gồm các hàm băm mật mã như Keccak và SHA-256, cũng như các mô hình học máy quy mô nhỏ.
Nhìn về phía trước, chúng tôi hy vọng sẽ giới thiệu thêm một loạt các kỹ thuật kỹ thuật trưởng thành trong đào tạo học máy hiện đại, chẳng hạn như lập lịch hiệu quả về bộ nhớ và tối ưu hóa cấp đồ thị. Chúng tôi tin rằng việc kết hợp các chiến lược này vào quy trình tạo bằng chứng không kiến thức sẽ cải thiện đáng kể ranh giới hiệu suất và tính linh hoạt trong việc thích ứng của hệ thống.
Đây chỉ là điểm khởi đầu. zkCuda sẽ tiếp tục hướng tới một khuôn khổ chứng minh chung hiệu quả, có khả năng mở rộng cao và có khả năng thích ứng cao.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan