OpenAI chính thức ra mắt GPT-4 đa phương thức: cải thiện độ chính xác và hỗ trợ cho Bing mới của Microsoft
Tiêu đề gốc: " Nghỉ lớn! OpenAI chính thức ra mắt GPT-4 đa phương thức 》
Tác giả gốc: OpenAI&TheVerge&Techcrunch
Bản tổng hợp gốc: Alpha Rabbit
*Bài viết này có 6.000 từ dài Trái và phải
Điểm nổi bật
GPT-4 có thể chấp nhận đầu vào hình ảnh và văn bản, trong khi GPT-3.5 chỉ chấp nhận văn bản.
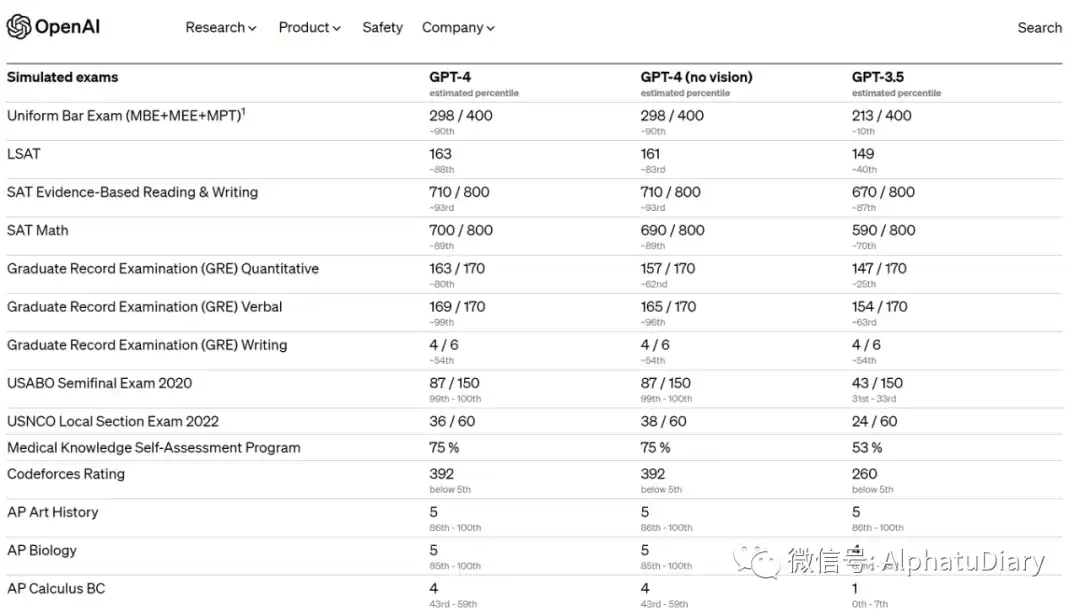
GPT-4 đạt được hiệu suất "cấp độ con người" trên nhiều tiêu chuẩn chuyên môn và học thuật. Ví dụ: nó đã vượt qua một kỳ thi giả với số điểm nằm trong khoảng 10% thí sinh có điểm cao nhất.
OpenAI đã dành 6 tháng sử dụng kinh nghiệm thu được từ dự án thử nghiệm đối thủ và ChatGPT để liên tục điều chỉnh GPT-4 và kết quả là thực tế và đạt được "kết quả tốt nhất từ trước đến nay" " về khả năng khởi động và khả năng kiểm soát.
Trong một cuộc trò chuyện đơn giản, sự khác biệt giữa GPT-3.5 và GPT-4 có thể không đáng kể, nhưng khi mức độ phức tạp của nhiệm vụ Khi đạt đến ngưỡng đủ, sự khác biệt sẽ trở nên rõ ràng. GPT-4 đáng tin cậy hơn, sáng tạo hơn và có thể xử lý nhiều hướng dẫn phức tạp hơn GPT-3.5.
GPT-4 có thể minh họa và giải thích những hình ảnh tương đối phức tạp, ví dụ như nhận dạng adapter Lightning Cable từ hình ảnh một chiếc iPhone đang cắm vào đó (hình bên dưới) ) .
Khả năng hiểu hình ảnh chưa được cung cấp cho tất cả khách hàng của OpenAI và OpenAI đang thử nghiệm khả năng này với đối tác Be My Eyes.
OpenAI thừa nhận GPT-4 không hoàn hảo và vẫn sẽ gây nhầm lẫn cho vấn đề xác minh thực tế , cũng sẽ mắc một số lỗi suy luận và đôi khi quá tự tin.
Đánh giá OpenAI mã nguồn mở, được sử dụng để tạo và chạy các điểm chuẩn nhằm đánh giá các mô hình như GPT- 4, đồng thời Kiểm tra mẫu hiệu suất của nó theo mẫu.
Văn bản thông báo chính thức
OpenAI đã chính thức ra mắt GPT-4, đây cũng là cột mốc mới nhất của OpenAI trong việc mở rộng deep learning. GPT-4 là một mô hình đa phương thức lớn (có khả năng chấp nhận đầu vào loại hình ảnh và văn bản và đưa ra đầu ra văn bản). Mặc dù GPT-4 không có khả năng như con người trong nhiều tình huống thực tế nhưng nó có thể được sử dụng trong nhiều tình huống khác nhau. chuyên nghiệp và học thuật Trên các tiêu chuẩn, nó thể hiện hiệu suất gần như ở cấp độ con người.
Ví dụ: GPT-4 đã vượt qua kỳ thi thanh mô phỏng với số điểm nằm trong khoảng 10% cao nhất của tất cả những người tham gia bài kiểm tra. Để so sánh, GPT-3.5 đạt điểm khoảng 10% cuối cùng. Nhóm của chúng tôi đã dành 6 tháng liên tục điều chỉnh GPT-4 bằng kinh nghiệm của tôi trong các dự án thử nghiệm đối thủ và dựa trên ChatGPT. Kết quả là GPT-4 đạt được kết quả tốt nhất từ trước đến nay về tính xác thực, khả năng điều khiển và không vượt ra ngoài lan can. Nó vẫn chưa hoàn hảo)
Hơn trong hai năm qua, chúng tôi đã tái cấu trúc toàn bộ hệ thống deep learning của mình và làm việc với Azure để cùng thiết kế khối lượng công việc ngay từ đầu để xây dựng một siêu máy tính. Cách đây 1 năm, OpenAI đã đào tạo GPT-3.5 là "chạy thử" đầu tiên của toàn bộ hệ thống, cụ thể là chúng tôi đã tìm và sửa một số lỗi và cải thiện cơ sở lý thuyết trước đó. Kết quả là, các chuyến tàu GPT-4 của chúng tôi chạy (ít nhất là đối với chúng tôi!) với độ ổn định chưa từng có và trở thành mô hình lớn đầu tiên có hiệu suất huấn luyện có thể được dự đoán trước chính xác. Khi chúng tôi tiếp tục tập trung vào việc mở rộng quy mô đáng tin cậy, mục tiêu cấp trung là tinh chỉnh các phương pháp giúp OpenAI tiếp tục dự đoán và chuẩn bị cho tương lai, điều mà chúng tôi tin là rất quan trọng đối với bảo mật.
Chúng tôi đang phát hành chức năng nhập văn bản của GPT-4 thông qua ChatGPT và API (bạn có thể tham gia WaitList). Để cung cấp chức năng nhập hình ảnh trên quy mô lớn hơn , chúng tôi đang hợp tác chặt chẽ với các đối tác để có một khởi đầu tốt đẹp. Chúng tôi dự định mở OpenAI Evals, khuôn khổ của chúng tôi để tự động đánh giá hiệu suất của các mô hình AI, để bất kỳ ai cũng có thể chỉ ra những thiếu sót trong mô hình của chúng tôi nhằm giúp cải thiện nó hơn nữa.
Khả năng
Có thể không dễ tìm thấy GPT-3.5 và GPT trong quá trình trò chuyện đơn giản Sự khác biệt giữa -4. Tuy nhiên, khi độ phức tạp của nhiệm vụ đạt đến ngưỡng đủ lớn thì sự khác biệt giữa chúng sẽ xuất hiện. Cụ thể, GPT-4 đáng tin cậy hơn, sáng tạo hơn và có thể xử lý nhiều hướng dẫn phức tạp hơn GPT-3.5.
Để hiểu rõ sự khác biệt giữa hai mô hình, chúng tôi đã thử nghiệm chúng trên nhiều điểm chuẩn khác nhau, bao gồm cả mô phỏng các bài kiểm tra được thiết kế ban đầu cho con người. Bằng cách sử dụng các bài kiểm tra công khai mới nhất (cho các kỳ thi Olympic Toán và AP, v.v.) và bao gồm cả việc mua phiên bản 2022-2023 của kỳ thi thực hành, chúng tôi chưa đào tạo riêng mô hình cho loại kỳ thi này. các câu hỏi trong bài thi có mặt trong quá trình huấn luyện mô hình, nhưng chúng tôi tin rằng các kết quả sau đây mang tính đại diện.
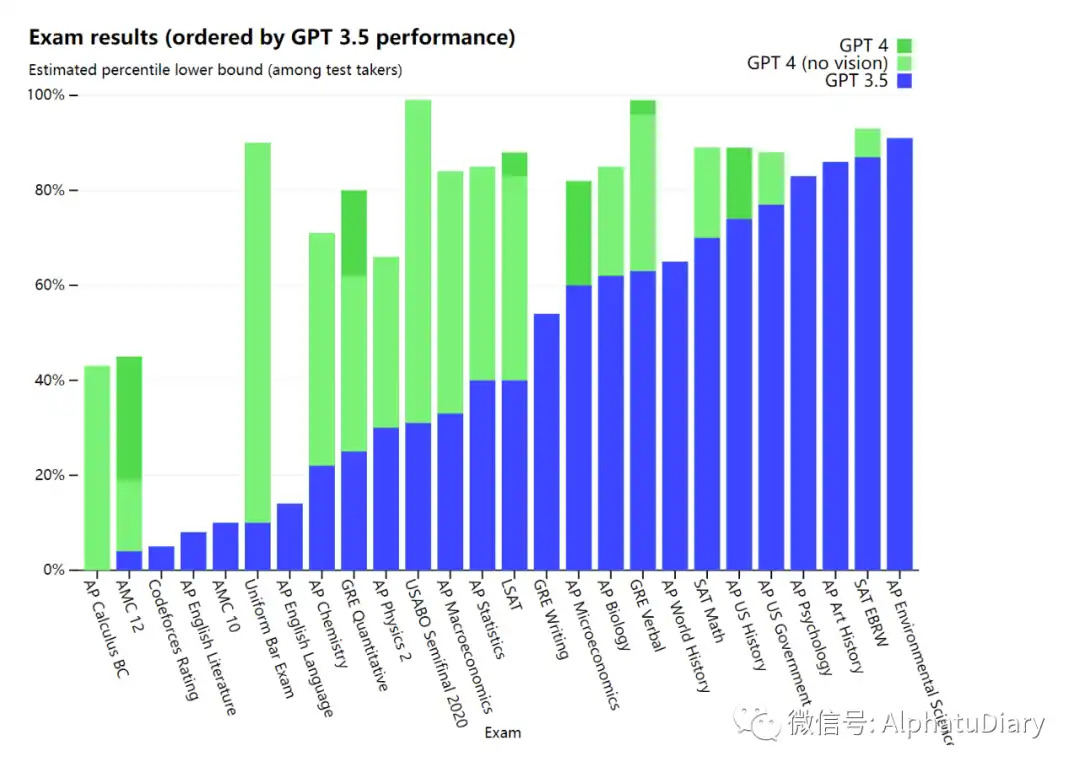
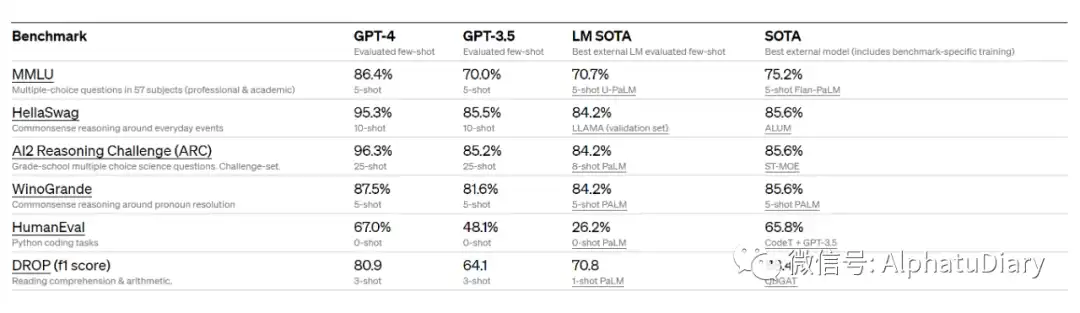
Chúng tôi cũng đã thực hiện GPT-4 trên điểm chuẩn truyền thống được thiết kế cho các mô hình học máy. Hãy đánh giá. GPT-4 vượt trội đáng kể so với các mô hình ngôn ngữ lớn hiện có và ngang bằng với hầu hết các mô hình hiện đại (SOTA) bao gồm việc tạo thủ công dựa trên điểm chuẩn hoặc các giao thức đào tạo bổ sung.
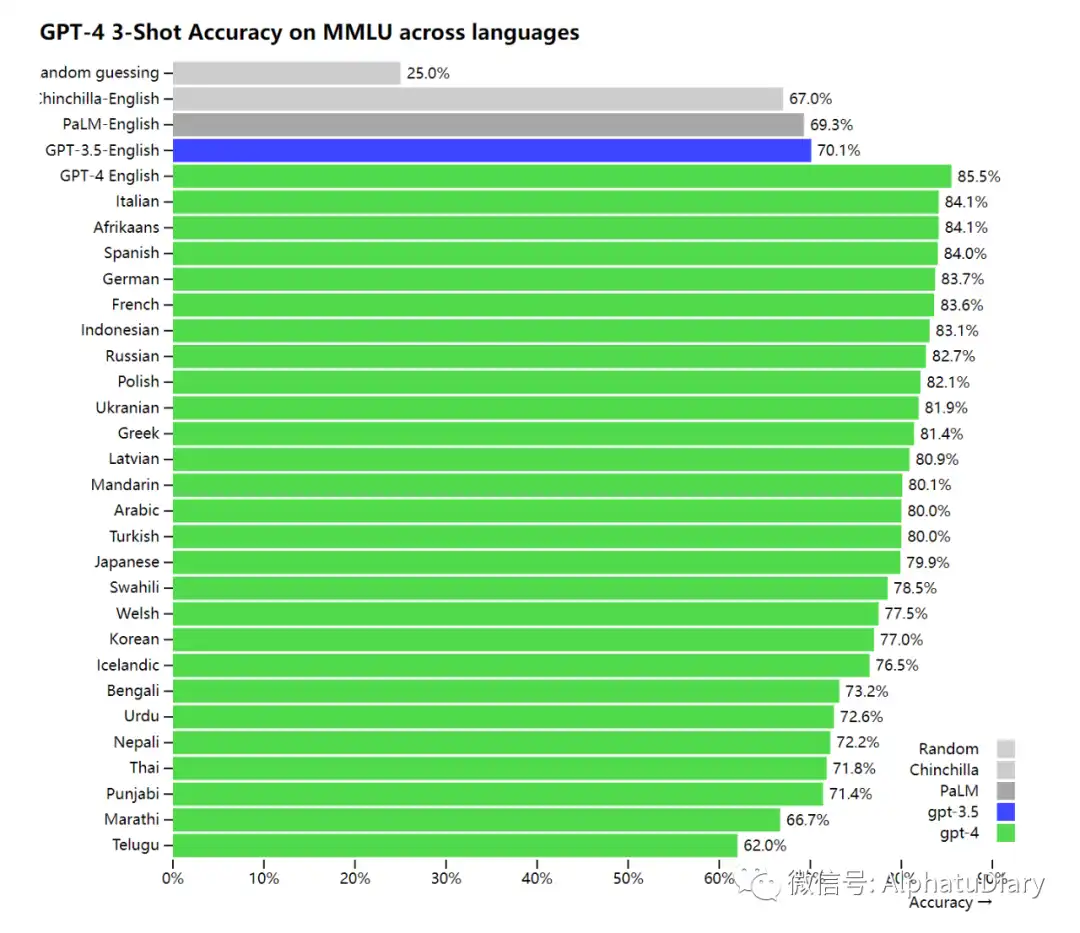
Vì hầu hết các điểm chuẩn ML hiện tại đều được viết bằng tiếng Anh nên để có được hiểu biết sơ bộ về các chức năng của các ngôn ngữ khác, chúng tôi đã sử dụng Azure Translate để dịch điểm chuẩn MMLU: một bộ gồm 14.000 câu hỏi trắc nghiệm bao gồm 57 chủ đề sang nhiều ngôn ngữ khác nhau. GPT-4 vượt trội hơn GPT-3.5 và các mẫu lớn khác (Chinchilla, PaLM) bằng tiếng Anh ở 24 trong số 26 ngôn ngữ được thử nghiệm, bao gồm tiếng Latvia, tiếng Wales và tiếng Sri Lanka, tiếng Wahili, v.v.
Chúng tôi đã và đang sử dụng GPT-4 trong nội bộ và nhận thấy GPT-4 hữu ích cho việc hỗ trợ, doanh số bán hàng, kiểm duyệt nội dung và lập trình sẽ có tác động lớn. Chúng tôi cũng đang sử dụng nó để hỗ trợ con người đánh giá đầu ra của AI. Đây là bước khởi đầu cho giai đoạn thứ hai trong quá trình điều chỉnh chiến lược của chúng tôi.
Đầu vào trực quan
GPT-4 có thể chấp nhận lời nhắc bằng văn bản và hình ảnh (lời nhắc) , tương đương với cài đặt chỉ có văn bản. Ví dụ: nó cho phép người dùng chỉ định bất kỳ tác vụ hình ảnh hoặc ngôn ngữ nào, nó có thể tạo đầu ra văn bản (ngôn ngữ tự nhiên, mã, v.v.) và đầu vào đã cho bao gồm các tệp có văn bản và ảnh, sơ đồ hoặc ảnh chụp màn hình. hiệu suất tương tự như khả năng tương tự cho việc nhập văn bản thuần túy. Ngoài ra, nó cũng có thể được áp dụng để thử nghiệm công nghệ thời gian được phát triển cho các mô hình ngôn ngữ văn bản thuần túy, bao gồm một vài shot và CoT's Nhắc nhở.Tuy nhiên, hiện tại hình ảnh đầu vào vẫn là bản xem trước nghiên cứu và chưa có sản phẩm công cộng như C-side.
Hình ảnh sau đây minh họa hộp đựng của bộ chuyển đổi "Cáp Lightning", có ba tấm.
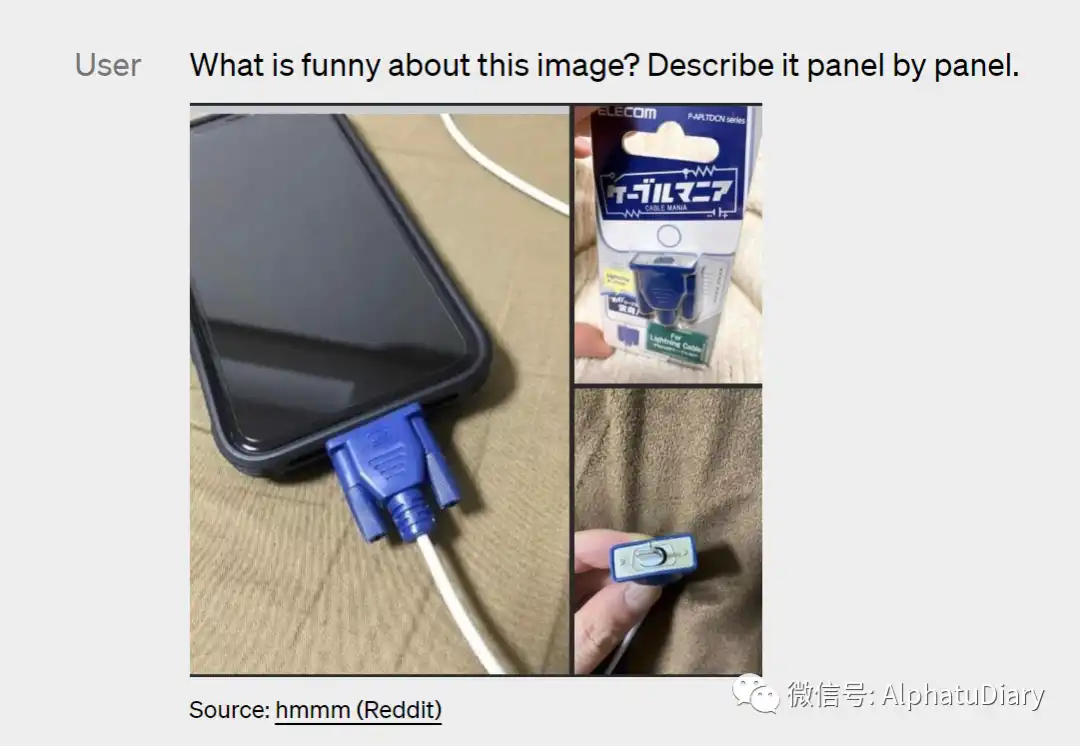
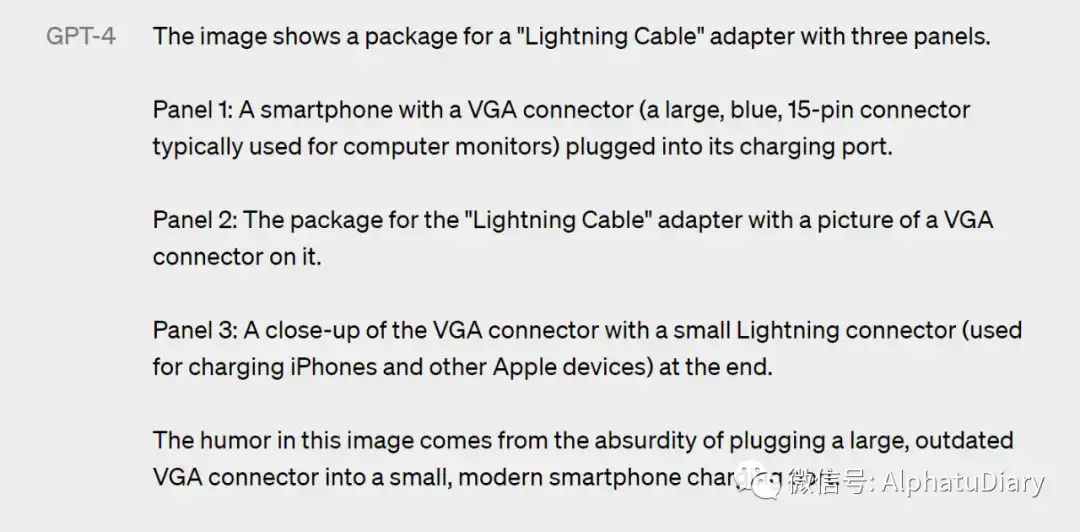
Bảng 1: Giao diện VGA (thường dùng cho màn hình máy tính) Màu xanh lớn Điện thoại thông minh 15 chân cắm vào cổng sạc của nó.
Bảng 2: Có hình ảnh đầu nối VGA trên bao bì của bộ chuyển đổi "Cáp Lightning".
Hình 3: Cận cảnh đầu nối VGA, kết thúc bằng đầu nối Lightning nhỏ (dùng để sạc iPhone và các thiết bị khác của Apple).
Tính chất vui nhộn của hình ảnh này đến từ việc cắm một đầu nối VGA lớn, lỗi thời vào một cổng sạc điện thoại thông minh nhỏ, hiện đại.. nên trông thật lố bịch
Đánh giá và xem trước hiệu suất của GPT-4 trên một tập hợp hẹp các tiêu chuẩn hình ảnh học thuật tiêu chuẩn. Tuy nhiên, những con số này không đại diện cho phạm vi khả năng của nó, vì chúng tôi nhận thấy rằng mô hình này có thể xử lý một số nhiệm vụ mới và thú vị, đồng thời OpenAI có kế hoạch sớm đưa ra các số liệu phân tích và đánh giá tiếp theo cũng như các kết quả kỹ thuật trên lần kiểm tra. Điều tra kỹ lưỡng kết quả.
AI có thể điều khiển
Chúng tôi đã và đang nỗ lực thực hiện bài viết về xác định hành vi của AI, mọi khía cạnh của kế hoạch được vạch ra, bao gồm cả khả năng kiểm soát của AI. Thay vì giọng nói, giọng điệu và phong cách cố định của tính cách ChatGPT cổ điển, các nhà phát triển (và sắp tới là tất cả người dùng ChatGPT) giờ đây có thể ra lệnh cho phong cách và nhiệm vụ của AI của riêng họ bằng cách mô tả các hướng này trong thông báo "hệ thống". Thông báo hệ thống cho phép người dùng API tùy chỉnh đáng kể trải nghiệm người dùng trong phạm vi và chúng tôi sẽ tiếp tục cải thiện nó.
Hạn chế
Mặc dù có những khả năng tuyệt vời, GPT-4 vẫn tồn tại và các Mẫu GPT đời đầu có những hạn chế tương tự. Trên hết, nó vẫn chưa hoàn toàn đáng tin cậy (chẳng hạn như nó có thể "gây ảo giác" sự thật và mắc lỗi suy luận). Cần hết sức cẩn thận khi sử dụng đầu ra của các mô hình ngôn ngữ, đặc biệt là trong các tình huống có rủi ro cao (tức là cần có sự xem xét của con người, tránh hoàn toàn việc sử dụng có rủi ro cao) và phù hợp với nhu cầu của trường hợp sử dụng cụ thể.
Mặc dù vẫn còn tồn tại nhiều tình huống khác nhau, nhưng GPT-4 làm giảm đáng kể ảo giác (nghĩa là Đó là ảo ảnh trên Internet và ở đây ý tôi là vô nghĩa nghiêm trọng). Trong đánh giá thực tế đối thủ nội bộ của chúng tôi, GPT-4 đạt điểm cao hơn 40% so với bản phát hành mới nhất của chúng tôi, GPT-3.5.

AI có thể điều khiển được
Mô hình cơ sở của GPT-4 chỉ nhỉnh hơn GPT-3.5 một chút về nhiệm vụ này, tuy nhiên, sau khi đào tạo sau với RLHF (áp dụng quy trình tương tự mà chúng tôi đã sử dụng cho GPT-3.5), Khoảng cách lớn. Mô hình sẽ có nhiều thành kiến khác nhau trong kết quả đầu ra và chúng tôi đã đạt được tiến bộ trong các lĩnh vực này, nhưng vẫn còn nhiều việc phải làm. Theo bài đăng trên blog gần đây của chúng tôi, mục tiêu của chúng tôi là cho phép các hệ thống AI mà chúng tôi xây dựng có các hành vi mặc định hợp lý phản ánh nhiều giá trị của người dùng, cho phép các hệ thống này được tùy chỉnh trên nhiều cài đặt khác nhau và nhận được ý kiến đóng góp của công chúng trên các phạm vi đó.
GPT-4 nhìn chung thiếu kiến thức về các sự kiện xảy ra sau phần lớn thời gian cắt dữ liệu (tháng 9 năm 2021) và không rút ra bài học kinh nghiệm. Đôi khi nó mắc phải những lỗi suy luận đơn giản mà dường như không phù hợp với năng lực trong nhiều lĩnh vực hoặc quá tin tưởng vào những cách trình bày sai rõ ràng của người dùng. Đôi khi nó cũng gặp lỗi ở những vấn đề khó khăn như con người, chẳng hạn như tạo ra các lỗ hổng bảo mật trong mã mà nó tạo ra. GPT-4 cũng có thể tự tin sai trong dự đoán của mình.
Rủi ro và biện pháp giảm nhẹ
Chúng tôi đã và đang nghiên cứu lại GPT-4 để biến nó thành hiện thực An toàn và nhất quán hơn ngay từ khi bắt đầu đào tạo, những nỗ lực của chúng tôi bao gồm việc lựa chọn và lọc dữ liệu trước đào tạo, đánh giá, mời chuyên gia tham gia, cải thiện an toàn mô hình, giám sát và thực hiện.
GPT-4 tiềm ẩn những rủi ro tương tự như các mô hình trước đây, chẳng hạn như tạo ra các đề xuất có hại, mã sai hoặc thông tin không chính xác. Tuy nhiên, các khả năng bổ sung của GPT-4 cũng dẫn đến những rủi ro mới. Để làm rõ chi tiết cụ thể của những rủi ro này, chúng tôi đã thuê hơn 50 chuyên gia từ các lĩnh vực rủi ro giao diện trí tuệ nhân tạo, an ninh mạng, rủi ro sinh học, niềm tin và an toàn cũng như an ninh quốc tế để tiến hành thử nghiệm đối nghịch mô hình. Sự tham gia của họ cho phép chúng tôi kiểm tra hành vi của mô hình trong các lĩnh vực có rủi ro cao cần có chuyên môn để đánh giá. Phản hồi và dữ liệu từ các chuyên gia trong các lĩnh vực này cho biết nỗ lực của chúng tôi trong việc giảm thiểu và cải thiện các mô hình của mình. Ví dụ: chúng tôi đã thu thập dữ liệu bổ sung để cải thiện khả năng từ chối các yêu cầu của GPT-4 về cách tổng hợp hóa chất độc hại.
GPT-4 bổ sung tín hiệu khen thưởng an toàn cho hoạt động đào tạo RLHF nhằm giảm sản lượng có hại bằng cách đào tạo mô hình từ chối các yêu cầu đối với nội dung đó (Như được xác định trong nguyên tắc sử dụng của chúng tôi ). Phần thưởng được cung cấp bởi bộ phân loại của GPT-4, có khả năng đánh giá các ranh giới bảo mật và cách hoàn thành các gợi ý liên quan đến bảo mật. Để ngăn mô hình từ chối các yêu cầu hợp lệ, chúng tôi thu thập các tập dữ liệu đa dạng từ các nguồn khác nhau (ví dụ: dữ liệu sản xuất được gắn nhãn, nhóm màu đỏ của con người, gợi ý do mô hình tạo) và áp dụng phần thưởng an toàn cho các danh mục được phép và không được phép. .
Các biện pháp giảm thiểu của chúng tôi cải thiện đáng kể nhiều đặc tính bảo mật của GPT-4 so với GPT-3.5. So với GPT-3.5, chúng tôi đã giảm 82% xu hướng phản hồi các yêu cầu về nội dung bất hợp pháp của mô hình, trong khi GPT-4 phản hồi các yêu cầu nhạy cảm (chẳng hạn như tư vấn y tế và tự làm hại bản thân) tuân thủ chính sách của chúng tôi thường xuyên hơn 29%
Nhìn chung, các biện pháp can thiệp ở cấp mô hình của chúng tôi làm tăng khó khăn trong việc gây ra hành vi không mong muốn nhưng vẫn có những "bẻ khóa" để tạo ra các hành vi vi phạm Nội dung trong Hướng dẫn sử dụng của chúng tôi. Khi rủi ro của hệ thống AI tăng lên, việc đạt được độ tin cậy cực cao trong các biện pháp can thiệp này sẽ trở nên quan trọng. Điều quan trọng bây giờ là bổ sung những hạn chế này bằng các công nghệ bảo mật triển khai theo thời gian, chẳng hạn như tìm cách giám sát chúng.
GPT-4 và các mô hình tiếp theo có thể có tác động tích cực hoặc tiêu cực đến xã hội, đồng thời chúng tôi cũng đang hợp tác với các nhà nghiên cứu bên ngoài để nâng cao hiểu biết và đánh giá về các tác động tiềm ẩn. , như thiết lập đánh giá về khả năng nguy hiểm có thể phát sinh trong các hệ thống trong tương lai. Chúng tôi sẽ sớm chia sẻ nhiều suy nghĩ của mình hơn về các tác động kinh tế và xã hội tiềm tàng của GPT-4 và các hệ thống AI khác.
Quy trình đào tạo
Giống như mô hình GPT trước đó, quá trình đào tạo GPT-4 mô hình cơ bản Nó được thiết kế để dự đoán từ tiếp theo trong tài liệu và được đào tạo bằng cách sử dụng dữ liệu có sẵn công khai (chẳng hạn như dữ liệu Internet) cũng như dữ liệu được chúng tôi ủy quyền. Dữ liệu được rút ra từ tập hợp dữ liệu cực lớn và bao gồm các giải pháp đúng và sai cho các vấn đề toán học, lý luận yếu và mạnh, các tuyên bố mâu thuẫn và nhất quán cũng như nhiều hệ tư tưởng và ý tưởng khác nhau.
Do đó, khi được nhắc bằng một câu hỏi, mô hình cơ bản có thể phản ứng theo nhiều cách khác nhau mà có thể khác xa với ý định của người dùng. Để điều chỉnh nó phù hợp với mục đích của người dùng, chúng tôi sử dụng phương pháp học tăng cường với phản hồi của con người (RLHF) để tinh chỉnh hành vi của mô hình.
Lưu ý rằng khả năng của mô hình dường như chủ yếu đến từ quá trình đào tạo trước và RLHF không cải thiện điểm kiểm tra (nếu không nỗ lực tích cực, nó sẽ thực sự làm giảm điểm kiểm tra). Nhưng việc hướng dẫn mô hình xuất phát từ quá trình sau đào tạo—mô hình cơ sở yêu cầu kỹ thuật kịp thời để biết được câu hỏi mà nó sẽ trả lời.
Mở rộng có thể dự đoán được
Trọng tâm chính của dự án GPT-4 là xây dựng một quy mô có thể dự đoán được Ngăn xếp deep learning mở rộng có tính dự đoán. Lý do chính là đối với các hoạt động đào tạo rất lớn như GPT-4, việc thực hiện nhiều điều chỉnh mô hình cụ thể là không khả thi. Cơ sở hạ tầng của chúng tôi đã được phát triển và tối ưu hóa để có hành vi rất có thể dự đoán được ở nhiều quy mô. Để xác minh khả năng mở rộng này, chúng tôi đã dự đoán trước chính xác tổn thất cuối cùng của GPT-4 trong cơ sở mã nội bộ của chúng tôi (không phải một phần của tập huấn luyện) bằng cách suy luận từ một mô hình được huấn luyện bằng phương pháp tương tự, nhưng sử dụng số lượng ít hơn 10.000 lần.
Chúng tôi tin rằng khả năng dự đoán chính xác tương lai của máy học là một phần quan trọng của bảo mật nhưng lại không nhận được đủ sự quan tâm liên quan đến tác động tiềm tàng của nó (mặc dù chúng tôi đã được khuyến khích bởi nỗ lực của một số tổ chức). Chúng tôi đang mở rộng nỗ lực phát triển các phương pháp nhằm cung cấp cho xã hội hướng dẫn tốt hơn về những gì có thể mong đợi từ các hệ thống trong tương lai và chúng tôi hy vọng điều này sẽ trở thành mục tiêu chung trong lĩnh vực này.
Đánh giá AI mở
Chúng tôi đang cung cấp nguồn mở Đánh giá AI OpenAI, Khung phần mềm của chúng tôi để tạo và chạy các điểm chuẩn để đánh giá các mô hình như GPT-4 trong khi kiểm tra hiệu suất của chúng trên cơ sở từng mẫu. Chúng tôi sử dụng Đánh giá để hướng dẫn phát triển các mô hình của mình (bao gồm xác định những thiếu sót và ngăn chặn sự hồi quy) và người dùng của chúng tôi có thể áp dụng nó để theo dõi hiệu suất của các phiên bản mô hình khác nhau (hiện sẽ được triển khai thường xuyên) và phát triển tích hợp sản phẩm. Ví dụ: Stripe đã sử dụng Evals để bổ sung cho các đánh giá của con người nhằm đo lường độ chính xác của các công cụ tài liệu dựa trên GPT của họ.
Vì mã là nguồn mở nên Evals hỗ trợ viết các lớp mới để triển khai logic đánh giá tùy chỉnh. Tuy nhiên, theo kinh nghiệm của chúng tôi, nhiều điểm chuẩn tuân theo một trong số "mẫu", vì vậy, chúng tôi cũng đã đưa vào nội bộ những điểm hữu ích nhất (bao gồm một điểm dành cho "Đánh giá xếp hạng mô hình" - chúng tôi nhận thấy rằng GPT-4 có khả năng ấn tượng trong việc kiểm tra bài làm của mình). Nói chung, cách hiệu quả nhất để xây dựng đánh giá mới là tạo một trong các mẫu này và cung cấp dữ liệu. Chúng tôi rất vui khi thấy những gì người khác có thể xây dựng với các mẫu và Đánh giá này ở phạm vi rộng hơn.
Chúng tôi muốn Evals trở thành một công cụ chia sẻ và đánh giá nguồn lực cộng đồng nhằm tối đa hóa khả năng thể hiện một loạt các phương thức lỗi và nhiệm vụ khó khăn. Như một ví dụ tiếp theo, chúng tôi đã tạo một bản đánh giá câu đố logic chứa 10 gợi ý về lỗi GPT-4. Đánh giá cũng tương thích với việc triển khai các tiêu chuẩn hiện có; chúng tôi đã đưa vào một số sổ ghi chép triển khai các tiêu chuẩn học thuật và một số biến thể kết hợp CoQA (một tập hợp con nhỏ) làm ví dụ.
Chúng tôi mời mọi người sử dụng Đánh giá để kiểm tra các mô hình của chúng tôi và gửi những ví dụ thú vị nhất của bạn. Chúng tôi tin rằng Đánh giá sẽ là một phần không thể thiếu trong quá trình sử dụng và xây dựng trên các mô hình của chúng tôi và chúng tôi hoan nghênh những đóng góp, câu hỏi và phản hồi trực tiếp.
ChatGPT Plus
Người dùng ChatGPT Plus sẽ có thể sử dụng nó trên chat.openai. com Bị giới hạn quyền GPT-4. Chúng tôi sẽ điều chỉnh giới hạn sử dụng chính xác dựa trên nhu cầu thực tế và hiệu suất hệ thống, nhưng chúng tôi cho rằng dung lượng sẽ bị hạn chế nghiêm trọng (mặc dù chúng tôi sẽ mở rộng quy mô và tối ưu hóa trong những tháng tới).
Tùy thuộc vào mô hình lưu lượng truy cập mà chúng tôi thấy, chúng tôi có thể giới thiệu cấp độ đăng ký mới để có mức sử dụng GPT-4 cao hơn và chúng tôi cũng hy vọng sẽ có một số lượng GPT miễn phí nhất định -4 truy vấn được cung cấp tại thời điểm này để người dùng không đăng ký cũng có thể dùng thử.
API
Để có được API GPT-4 (sử dụng với gpt-3.5-turbo Cùng API ChatCompletions), vui lòng đăng ký trên Danh sách chờ chính thức của OpenAI.
Kết luận
Chúng tôi mong muốn GPT-4 trở thành một công cụ có giá trị cho nhiều ứng dụng cung cấp động lực cải thiện đời sống nhân dân. Vẫn còn rất nhiều việc phải làm và chúng tôi mong muốn được xây dựng, khám phá và đóng góp cho mô hình này thông qua nỗ lực chung của cộng đồng để cùng nhau cải tiến mô hình.
Tài liệu tham khảo:
1.https://openai.com/research/gpt-4
2.https:/ / techcrunch.com/2023/03/14/openai-releases-gpt-4-ai-that-it-claims-is-state-of-the-art/
3.https:// www .theverge.com/2023/3/14/23638033/openai-gpt-4-chatgpt-multimodal-deep-learning
Liên kết gốc
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia
 Bài viết liên quan