


Tốn kém Lưu Trữ: Bài Báo của Google AI với Vốn 900 Tỷ Đô la bị Buộc Tội Gian Dối Thực Nghiệm
Dịch từ tiêu đề gốc: "Giấy nén bộ nhớ 900 tỷ USD của Google AI bị buộc tội gian lận thử nghiệm"
Nguồn bài viết gốc: TechFlow của DeepTech
Một bài báo của Google tự xưng là "nén lượng bộ nhớ AI xuống còn 1/6", đã khiến cho giá trị thị trường của các công ty chip lưu trữ toàn cầu như Micron, SanDisk giảm hơn 900 tỷ USD vào tuần trước.
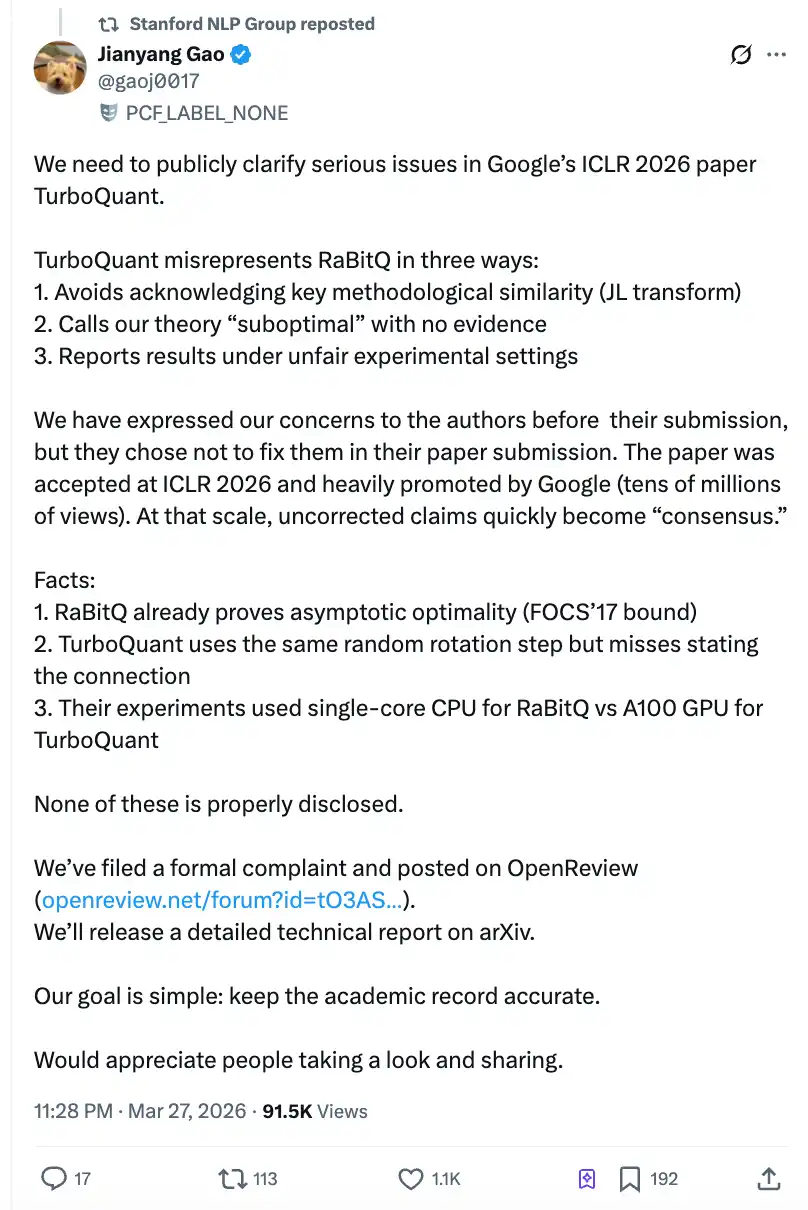
Tuy nhiên, chỉ hai ngày sau khi bài báo được công bố, đối tác đã bị "đè" bởi thuật toán - tiến sĩ sau tiến sĩ tại Viện Công nghệ Thụy Sĩ ở Zurich, Gao Jianyang, đã phát hành một lá thư công khai hàng ngàn chữ, buộc tội nhóm nghiên cứu của Google đã thử nghiệm với đối thủ bằng script Python trên CPU đơn lõi, nhưng vẫn thử nghiệm với GPU A100 của chính họ, và từ chối sửa đổi sau khi được thông báo vấn đề trước khi nộp bài. Số lượt đọc trên Zhihu đã nhanh chóng vượt qua con số 4 triệu, tài khoản chính thức của Stanford NLP đã chia sẻ, cả giới học thuật và thị trường đều bị làm rung chuyển.
Vấn đề cốt lõi của cuộc tranh cãi này không phức tạp: một bài báo hội nghị AI do Google chính thức quảng bá rộng rãi, gây ra sự hoang mang trên toàn cầu của ngành chip, liệu có một cách hiểu sai đối với một công trình tiên quyết đã được công bố, và thông qua việc thực hiện thử nghiệm không công bằng một cách cố ý, bài báo đã tạo ra một câu chuyện về lợi thế hiệu suất giả mạo?
TurboQuant đã làm gì: Nén "giấy vo bích" của AI xuống còn 1/6 ban đầu
Khi mô hình ngôn ngữ lớn tạo ra câu trả lời, nó cần viết và xem lại nội dung đã tính toán trước đó. Những kết quả trung gian này được lưu trữ tạm thời trong bộ nhớ đệm khổng lồ, được ngành công nghiệp gọi là "KV Cache" (bộ nhớ đệm khóa giá trị). Càng dài cuộc trò chuyện, tờ "giấy vo bích" này càng dày, tiêu tốn bộ nhớ và chi phí cũng càng cao.
Thuật toán TurboQuant mà nhóm nghiên cứu của Google đã phát triển, điểm mấu chốt là nén tờ giấy này xuống còn 1/6 ban đầu, đồng thời tuyên bố không mất độ chính xác, tăng tốc độ lý luận lên đến 8 lần. Bài báo được công bố lần đầu trên nền tảng bản thảo học thuật arXiv vào tháng 4 năm 2025, và sau đó được Hội nghị ICLR 2026, một trong những hội nghị hàng đầu trong lĩnh vực AI, chấp nhận vào tháng 1 năm 2026, và được Google tái đóng gói và quảng bá trên blog chính thức vào ngày 24 tháng 3.
Mặt kỹ thuật, phương pháp của TurboQuant có thể được hiểu đơn giản là: đầu tiên, sử dụng một biến đổi toán học để "rửa sạch" dữ liệu rối, sau đó nén từng phần dữ liệu bằng bảng nén tối ưu đã được tính toán trước, và sau cùng sử dụng một cơ chế sửa lỗi 1 bit để điều chỉnh sai số tính toán do nén gây ra. Các cộng đồng độc lập đã xác minh hiệu suất nén của nó gần như là đúng, và các đóng góp toán học của mặt thuật toán là thực sự tồn tại.
Sự tranh cãi không nằm ở việc TurboQuant có thể sử dụng hay không, mà ở việc Google đã làm gì để chứng minh rằng nó "vượt trội hơn đối thủ".
Bức Thư Công Khai của Cao Kiện Dương: Ba Cáo Buộc, Mỗi Cáo Trọng Tâm
Vào lúc 10 giờ tối ngày 27 tháng 3, Cao Kiện Dương đã đăng một bài viết dài trên Zhihu, đồng thời gửi bình luận chính thức trên OpenReview, nền tảng đánh giá chính thức của ICLR. Cao Kiện Dương là tác giả chính của thuật toán RaBitQ, được công bố vào năm 2024 tại hội nghị hàng đầu trong lĩnh vực cơ sở dữ liệu SIGMOD, giải quyết cùng một loại vấn đề - nén hiệu quả của vector có chiều cao.
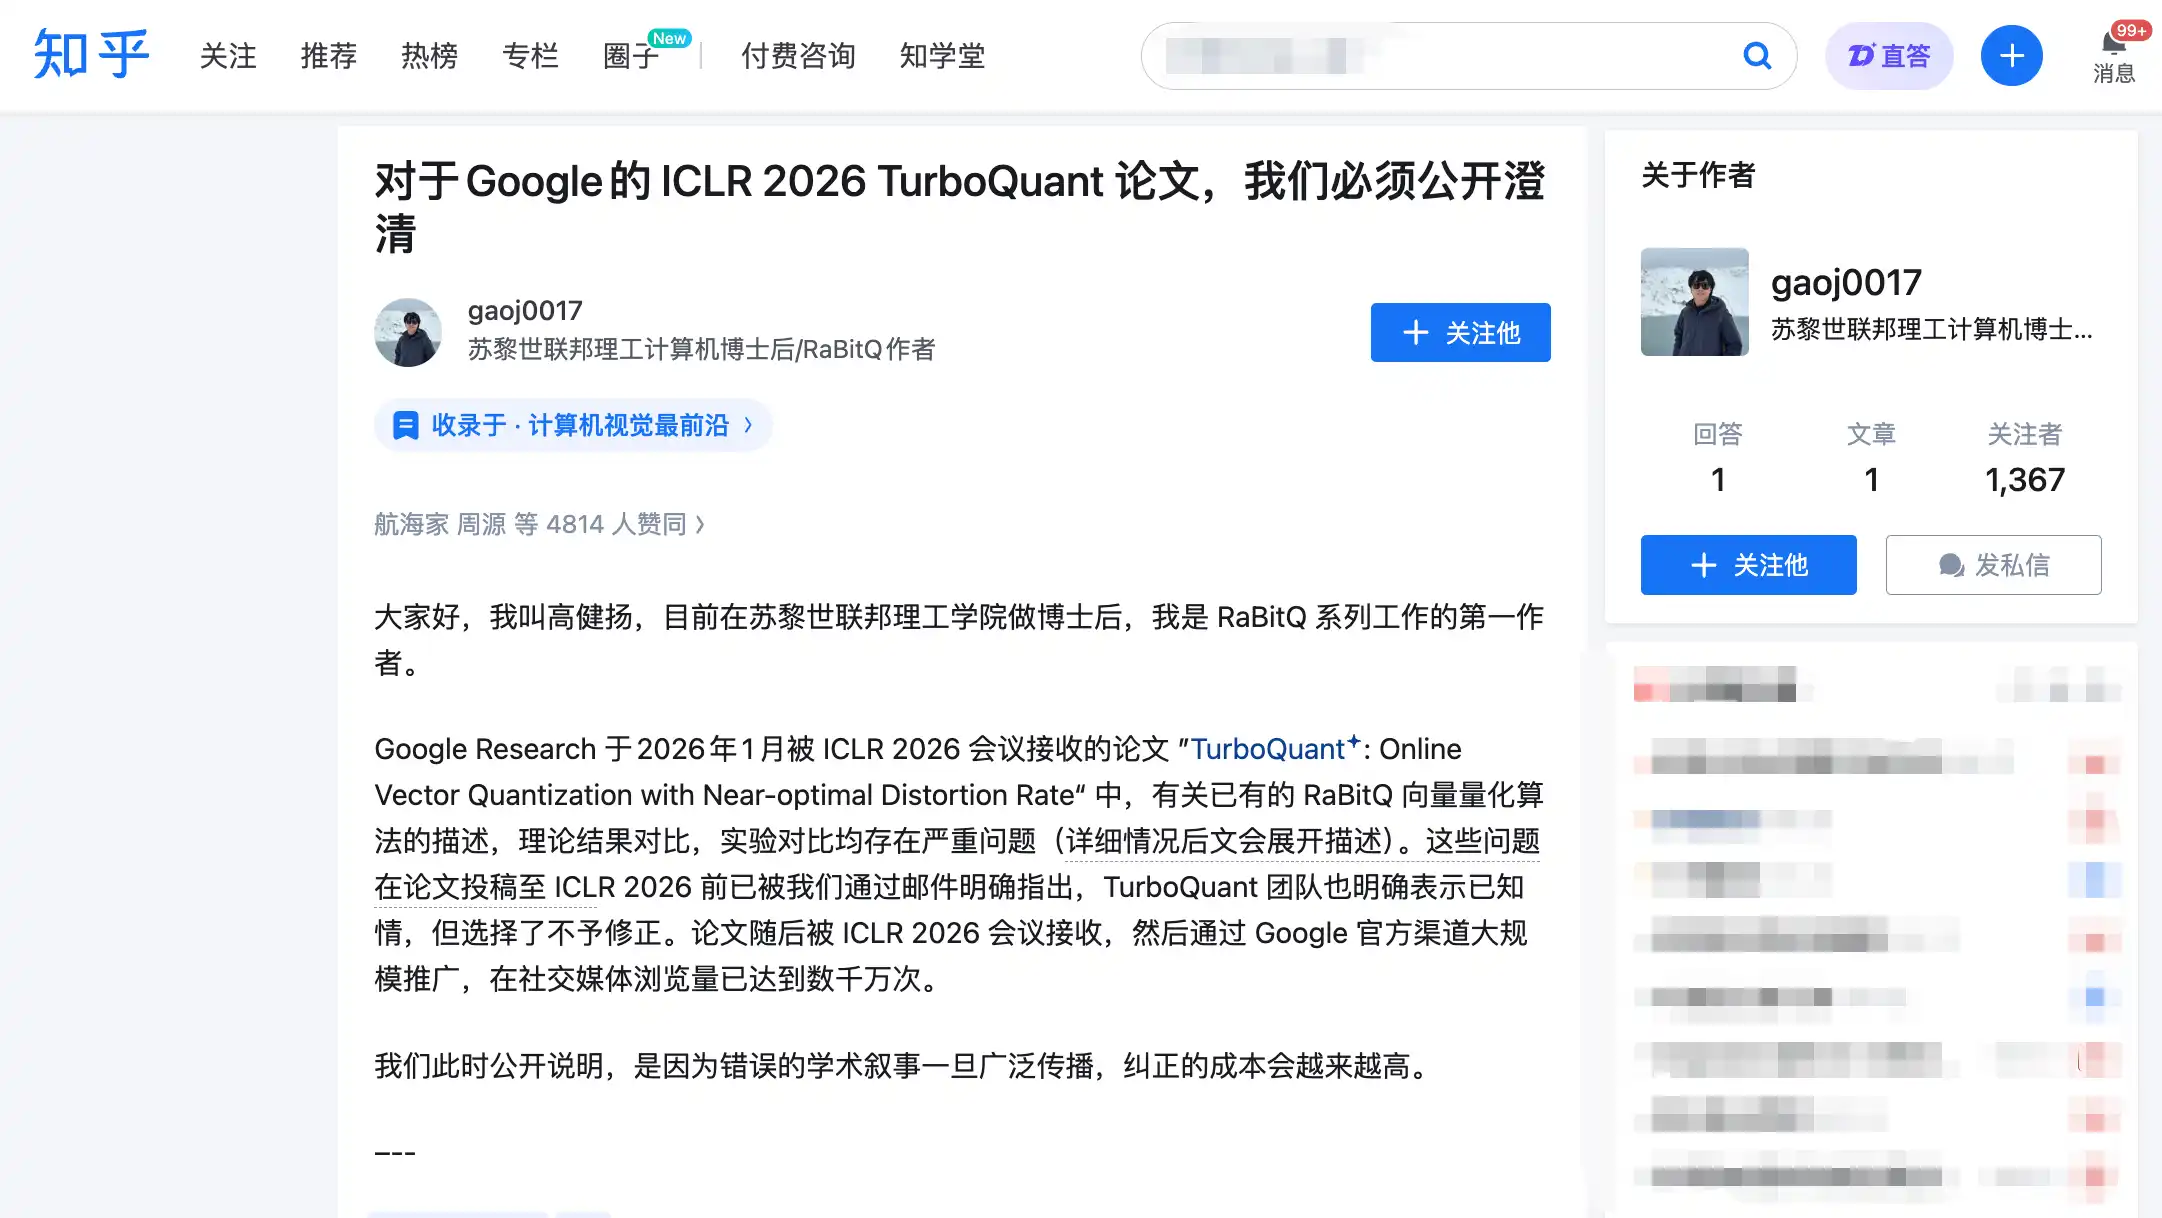
Đồng thời, 3 cáo buộc của ông đều có bằng chứng về email và dãy thời gian.
Cáo Buộc Thứ Nhất: Sử dụng phần tử lõi của người khác mà không được đề cập trong toàn văn.
Cốt lõi kỹ thuật của TurboQuant và RaBitQ có một bước chung quan trọng: Trước khi nén dữ liệu, đầu tiên thực hiện một lần “quay ngẫu nhiên” trên dữ liệu. Bước này nhằm chuyển dữ liệu ban đầu phân phối không đồng đều thành phân phối đồng đều có thể dự đoán, từ đó giảm đáng kể khó khăn trong việc nén. Đây là phần cốt lõi, gần giống nhau nhất của hai thuật toán.
Đối tác của TurboQuant đã tự thừa nhận điều này trong trả lời xét duyệt, nhưng không bao giờ đề cập trực tiếp trong toàn bộ bài báo về sự liên quan này với RaBitQ. Điều quan trọng hơn là: Tác giả thứ hai của TurboQuant, Majid Daliri, đã tự mình liên hệ nhóm Cao Kiện Dương vào tháng 1 năm 2025, yêu cầu trợ giúp để điều chỉnh phiên bản Python dựa trên mã nguồn của RaBitQ mà anh ta đã viết lại. Email này mô tả chi tiết các bước để tái tạo và thông tin về lỗi - nói cách khác, nhóm TurboQuant hiểu rõ chi tiết kỹ thuật của RaBitQ.
Một người xét duyệt ẩn danh của ICLR cũng đã chỉ ra rằng cả hai đều sử dụng cùng một công nghệ, yêu cầu thảo luận một cách đầy đủ. Tuy nhiên, trong bản cuối cùng của bài báo, nhóm TurboQuant không chỉ không thêm phần thảo luận mà còn di chuyển (đã không đầy đủ) phần mô tả của RaBitQ ban đầu từ phần chính lên phụ lục.
Cáo Buộc Thứ Hai: Mang không có cơ sở gán nhãn lý thuyết của đối phương là "thứ dưới cấp".
Bài báo của TurboQuant trực tiếp gắn nhãn RaBitQ là "thứ dưới cấp" (suboptimal), lí do được đưa ra là phân tích toán học của RaBitQ "khá thô lỗ". Tuy nhiên, Cao Kiện Dương chỉ ra rằng bản mở rộng của Bài báo RaBitQ đã chứng minh một cách chặt chẽ rằng sai số nén của nó đạt được ranh giới tối ưu toán học - kết luận này đã được công bố trong hội nghị hàng đầu về lý thuyết máy tính.
Vào tháng 5 năm 2025, nhóm của Gao Jianyang đã thông qua nhiều vòng email để chi tiết giải thích sự tối ưu của lý thuyết RaBitQ. Tác giả thứ hai của TurboQuant, Daliri, đã xác nhận đã thông báo cho tất cả các tác giả. Tuy nhiên, bài báo cuối cùng vẫn giữ nguyên cụm từ "tối ưu thấp hơn" mà không cung cấp bất kỳ bằng chứng bác bỏ nào.
Điều Khiển Ba: "Buộc tay bằng tay trái, cầm dao bằng tay phải" trong Thử nghiệm So sánh.
Đây là điều khiển gây thiệt hại nhất trong toàn văn. Gao Jianyang chỉ ra rằng, bài báo của TurboQuant đã chồng lên nhau hai điều kiện không công bằng trong thử nghiệm so sánh tốc độ:
Thứ nhất, RaBitQ đã cung cấp mã nguồn C++ được tối ưu hóa (mặc định hỗ trợ song song nhiều luồng), nhưng nhóm TurboQuant không sử dụng mà thay vào đó sử dụng phiên bản Python do chính họ dịch để kiểm tra RaBitQ.
Thứ hai, khi thử nghiệm RaBitQ, họ sử dụng CPU đơn nhân và vô hiệu hóa đa luồng, trong khi TurboQuant sử dụng GPU NVIDIA A100.
Hiệu ứng của việc chồng lên nhau hai điều kiện này là: kết luận mà độc giả thấy là "RaBitQ chậm hơn TurboQuant một số bậc đơn vị", nhưng họ không thể biết rằng tiền đề của kết luận này là nhóm Google đã buộc chặt đối thủ trước khi chạy cuộc đua. Bài báo không tiết lộ đầy đủ sự khác biệt về các điều kiện thử nghiệm này.
Phản hồi của Google: "Xoay Ngẫu Nhiên là Công Nghệ Phổ Quát, không thể trích dẫn từng bài làm"
Theo thông tin của Gao Jianyang, trong phản hồi qua email vào tháng 3 năm 2026, nhóm TurboQuant cho biết: "Việc sử dụng xoay ngẫu nhiên và biến đổi Johnson-Lindenstrauss đã trở thành công nghệ tiêu chuẩn trong lĩnh vực này, chúng tôi không thể trích dẫn từng bài báo sử dụng phương pháp này."
Nhóm của Gao Jianyang tin rằng đây là việc hoán đổi khái niệm: vấn đề không phải là có nên trích dẫn tất cả các bài báo đã sử dụng xoay ngẫu nhiên, mà là RaBitQ là công việc đầu tiên trong cùng một bài toán hoàn toàn đã kết hợp phương pháp này với nén vector và chứng minh tính tối ưu của nó, bài báo của TurboQuant nên mô tả chính xác mối quan hệ giữa hai vấn đề này.
Tài khoản chính thức X của Nhóm NLP Stanford đã chuyển tiếp tuyên bố của Gao Jianyang. Nhóm của Gao Jianyang đã đăng bình luận công khai trên nền tảng ICLR OpenReview và đã nộp khiếu nại chính thức đến Chủ tịch Hội nghị ICLR và Ủy ban Đạo đức, và sau này sẽ công bố một báo cáo kỹ thuật chi tiết trên arXiv.
Người viết blog công nghệ độc lập Dario Salvati đã đưa ra một đánh giá tương đối trung lập trong phân tích: TurboQuant thực sự đã đóng góp đáng kể trong phương pháp toán học, nhưng mối quan hệ với RaBitQ thì quan trọng hơn rất nhiều so với những gì bài báo trình bày.
Giảm giá thị trường 900 Tỷ USD: Sự tranh cãi về bài báo khiến thị trường lo sợ hơn
Thời điểm của cuộc tranh cãi học thuật này rất tinh tế. Vào ngày 24 tháng 3, Google đã thông qua blog chính thức giới thiệu TurboQuant, ngành công nghiệp vi xử lý toàn cầu đã bắt đầu phản ứng mạnh mẽ với sự bán tháo. Theo một số trang tin như CNBC, cổ phiếu của Micron Technology đã giảm liên tiếp trong sáu ngày giao dịch, tổng giảm hơn 20%; cổ phiếu của SanDisk giảm 11% trong một ngày; SK Hynix của Hàn Quốc giảm khoảng 6%, Samsung Electronics giảm gần 5%, Kioxia của Nhật Bản giảm khoảng 6%.
Logic của nỗi sợ hãi trên thị trường rất đơn giản: việc nén phần mềm có thể giảm bộ nhớ suy luận AI 6 lần, tầm nhìn về nhu cầu bộ nhớ lưu trữ sẽ bị giảm cấu trúc.
Nhà phân tích của Morgan Stanley, Joseph Moore, đã phản bác logic này trong báo cáo ngày 26 tháng 3, duy trì bình thường đánh giá "Giữ" cho Micron và SanDisk. Moore chỉ ra rằng TurboQuant chỉ nén KV Cache, một loại bộ nhớ cache cụ thể, chứ không phải tổng lượng sử dụng bộ nhớ, và gọi đó là "cải tiến hiệu suất bình thường". Nhà phân tích của Ngân hàng Quốc gia, Andrew Rocha, cũng dựa vào * Dilemma của Jevons * tin rằng việc nâng cao hiệu suất giảm chi phí có thể kích thích triển khai AI quy mô lớn hơn, dẫn đến tăng cấp độ nhu cầu bộ nhớ.
Bài báo cũ, Gói mới: Rủi ro truyền tải câu chuyện thị trường từ nghiên cứu AI
Theo phân tích của blogger công nghệ Ben Pouladian, bài báo TurboQuant đã được công bố công khai vào tháng 4 năm 2025, không phải là nghiên cứu mới. Vào ngày 24 tháng 3, Google đã giới thiệu lại TurboQuant thông qua blog chính thức, nhưng thị trường lại coi đó như một đột phá mới. Chiến lược tiếp thị "bài báo cũ, phát hành mới" này, kết hợp với khuyết điểm thực nghiệm có thể tồn tại trong bài báo, phản ánh rủi ro hệ thống trong chuỗi truyền tải câu chuyện từ nghiên cứu học thuật đến thị trường trong lĩnh vực AI.
Đối với nhà đầu tư cơ sở hạ tầng AI, khi một bài báo tuyên bố đã đạt được cải tiến hiệu suất "một số cấp số nhân", điều cần phải được xem xét đầu tiên là liệu điều kiện so sánh cơ sở có công bằng hay không.
Đội ngũ của Gao Jianyang đã tuyên bố rõ ràng sẽ tiếp tục thúc đẩy giải pháp chính thức cho vấn đề này. Phía Google vẫn chưa có phản hồi chính thức về các cáo buộc cụ thể trong thư công khai.
Chào mừng bạn tham gia cộng đồng chính thức của BlockBeats:
Nhóm Telegram đăng ký: https://t.me/theblockbeats
Nhóm Telegram thảo luận: https://t.me/BlockBeats_App
Tài khoản Twitter chính thức: https://twitter.com/BlockBeatsAsia